

本地AI备考实战 · 第 2 篇
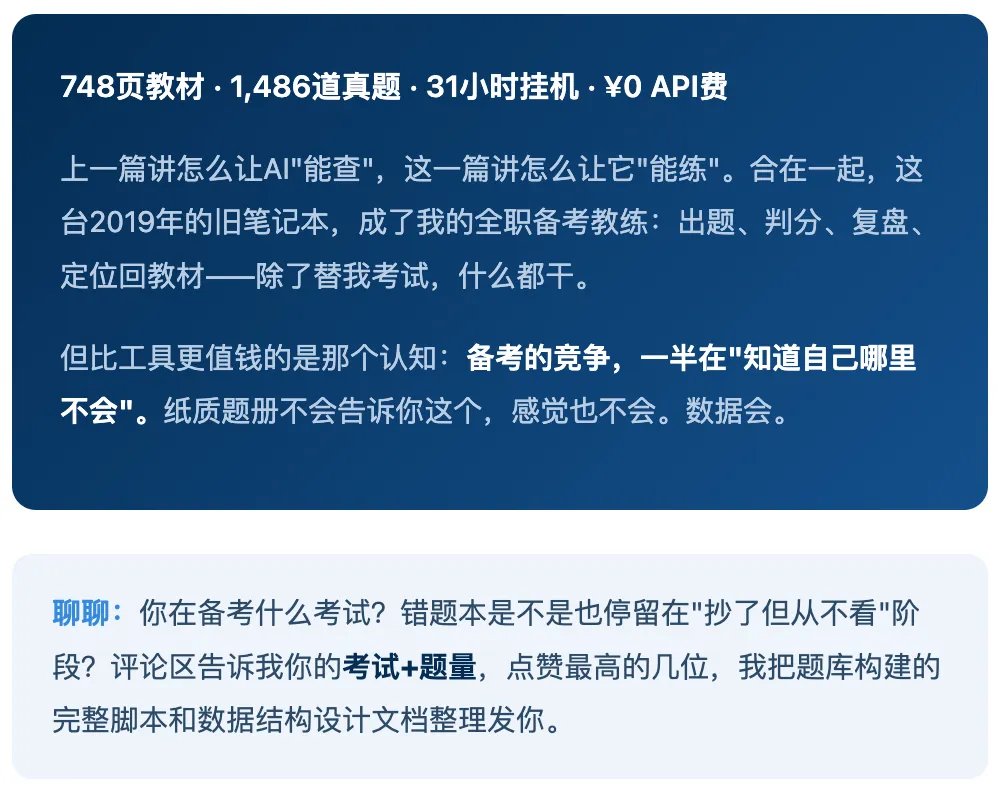
748页教材喂给AI之后
我又把1486道真题喂给了它
零买题库钱 · 零API费 · 一台2019年的旧笔记本
上一篇
《我用一台2019年的旧笔记本,把748页软考教材喂给了本地AI》
讲的是怎么让AI能查——输入一个考点,3秒定位到教材页码。
但真正备考过的人都懂:能查只是开始,能练才是命门。
查得到"挣值管理的公式",不代表你做对挣值管理的题。就像熟读交规不代表科目一能过——考的是做题,是题感,是一遍遍把错题碾过去。
于是我干了第二件事:把《章节分类练习与解析》里1486道真题全部识别、结构化,做成一套自动判分、自动复盘、自动定位回教材页码的刷题系统。
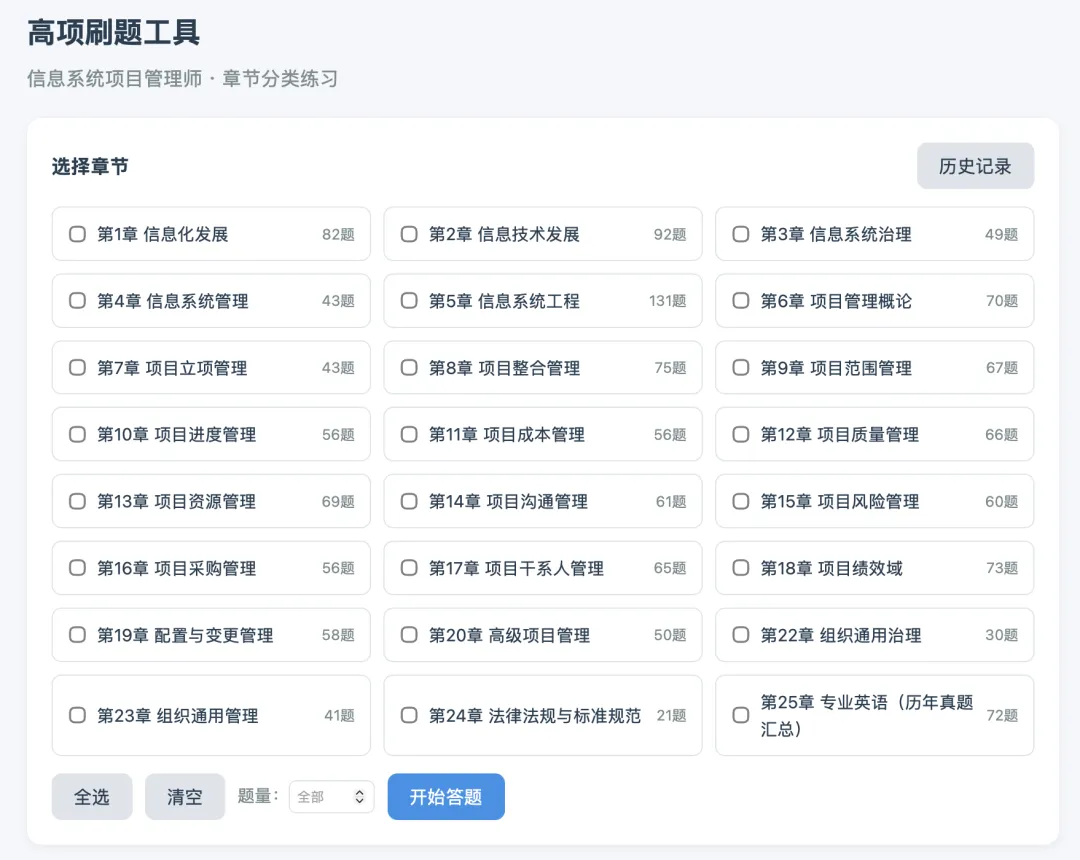
图 1 · 高项刷题工具答题界面首页
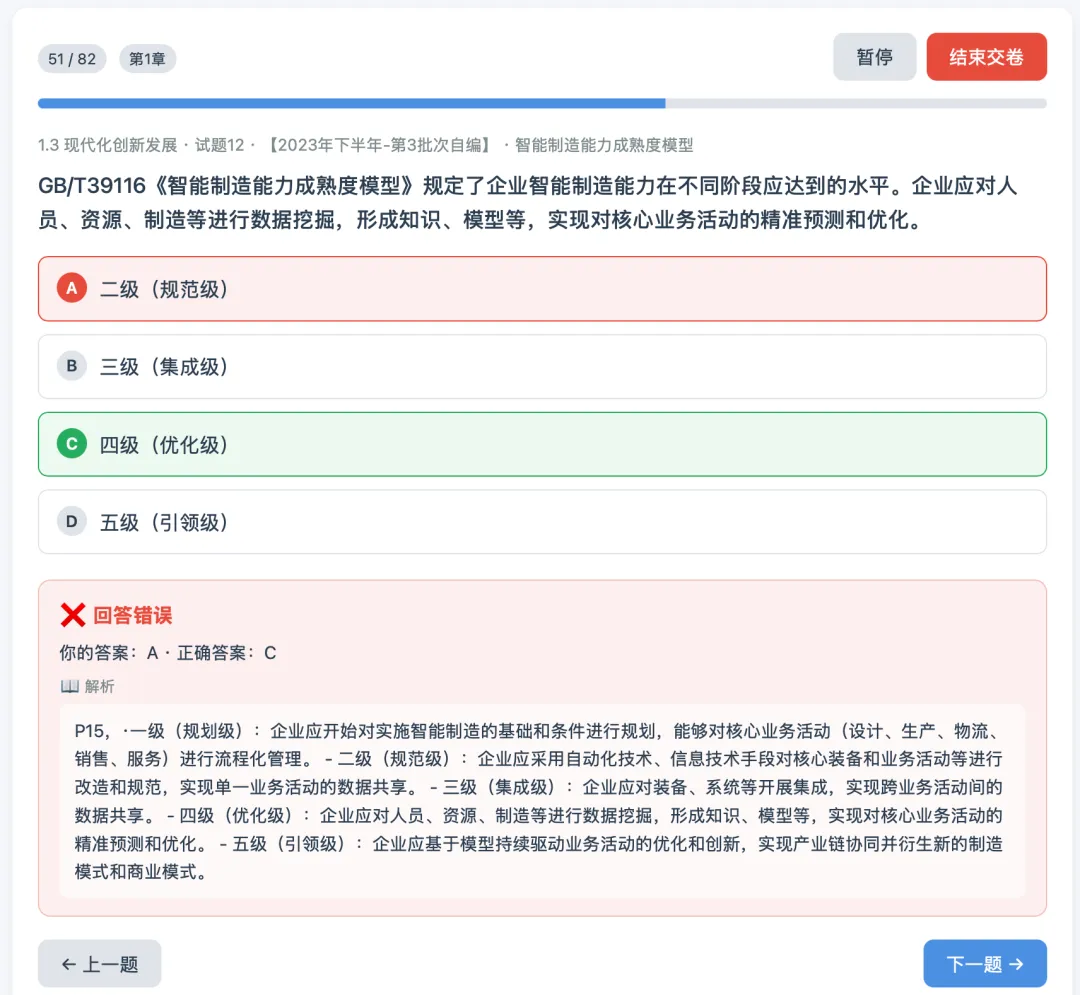
图 2 · 高项刷题工具刷题界面
零买题库钱。这篇讲清楚三件事:怎么做的,踩了什么坑,你能不能复刻。
先看成果:一张"体检报告"
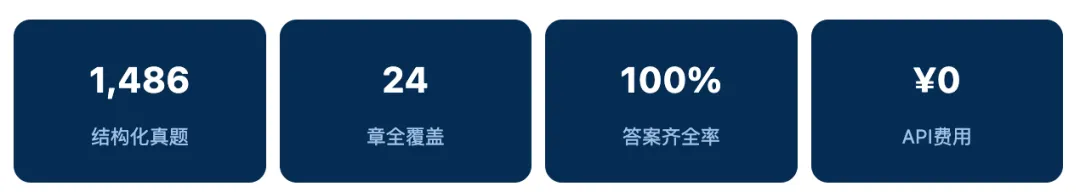
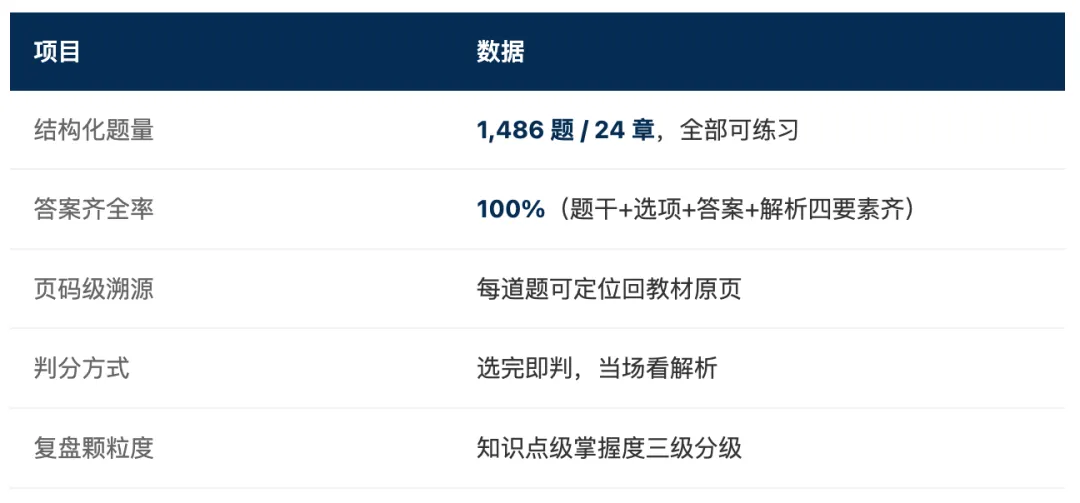
系统给我的第一份"体检报告"长这样——32道题做下来,对7错25,正确率21.9%。
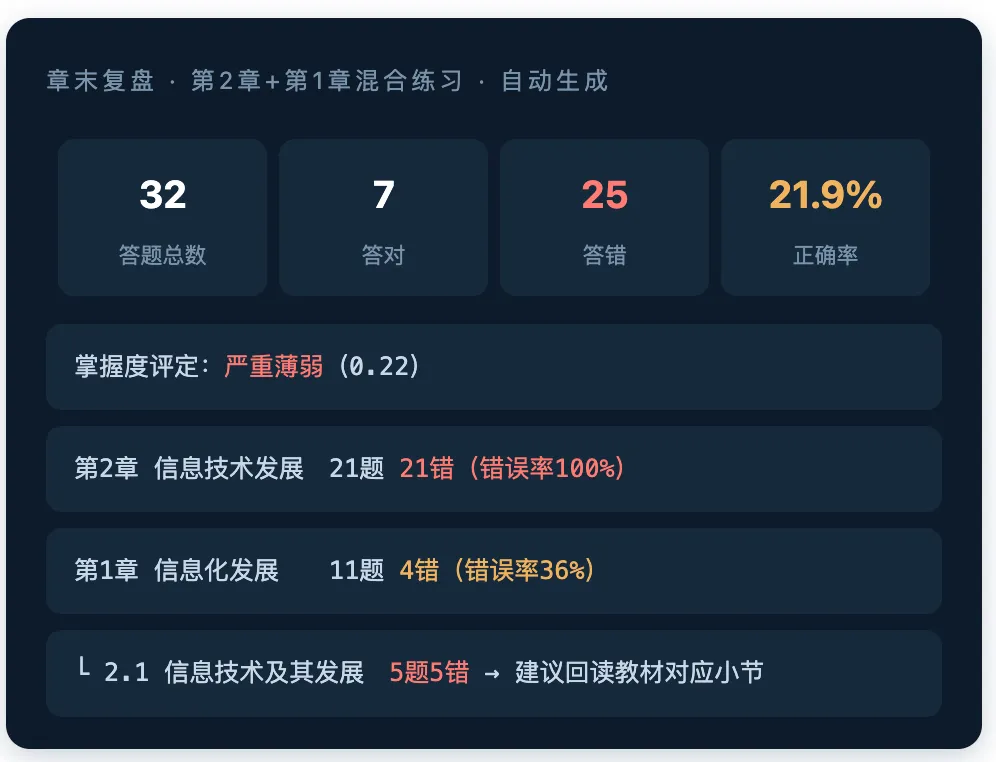
哪一节拉的胯、哪个知识点反复错、应该先回教材第几页补——全部列成了清单。说实话,比我自己刷一个月题更早看清了自己的真实水平。这就是数据化刷题和纸质题册的区别:它不会陪你演戏。
新问题:纸质的题册,天然没法复盘
为什么要自己造轮子?因为纸质章节练习册有三个死穴:
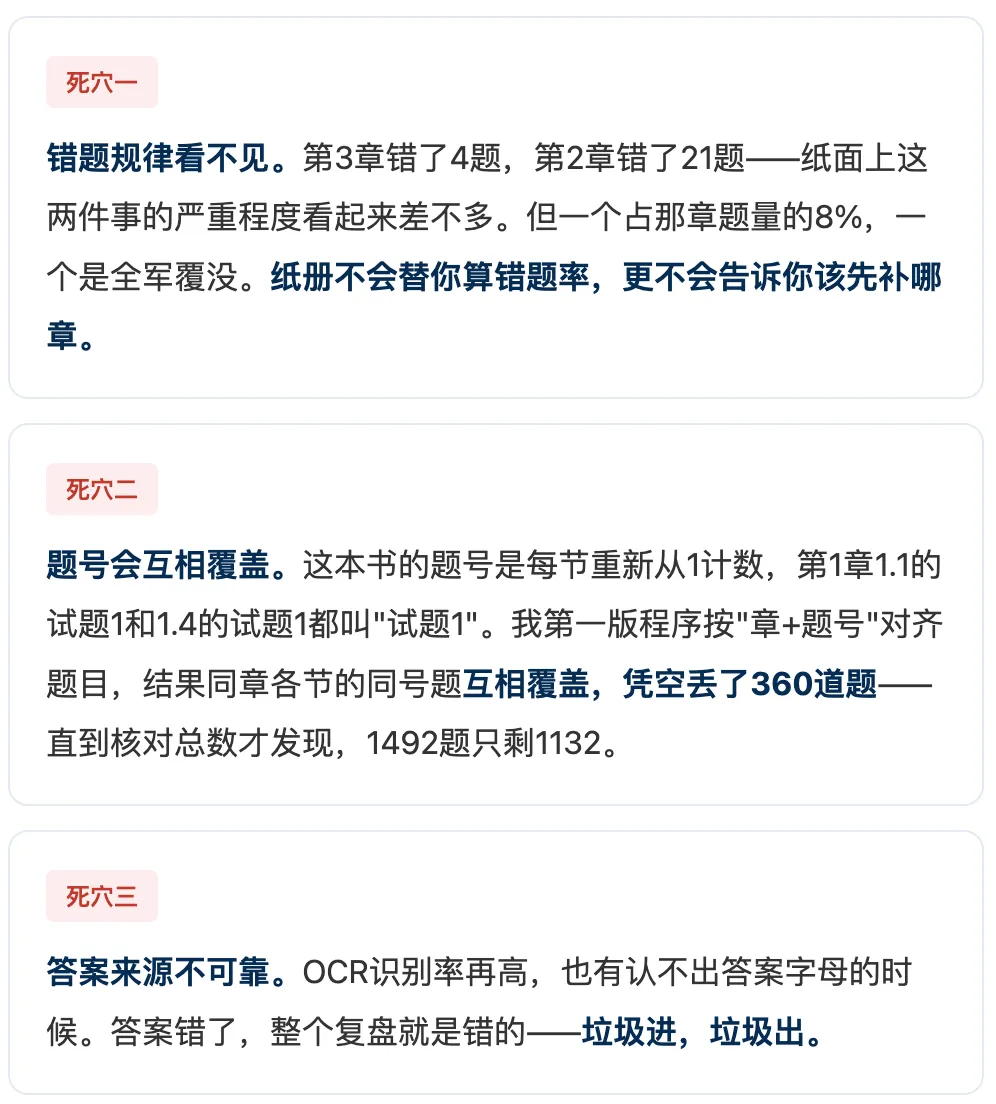
三个死穴指向同一个解法:题目必须变成结构化数据,每道题带着章节、节号、书内序号、页码、答案来源,才能被程序统计、排序、复盘。
技术方案:四步流水线
剥掉术语,这条流水线就四步,每步一个类比:
图 3 · 题库构建四步流水线
第一步,OCR识别(眼睛)。用GLM-OCR把整本练习册的每一页转成文字。上一篇文章说过:它给748页教材干过同样的活,识别置信度0.9981——这次是同一套基础设施的复用,这也是本地知识库的一次挂机、多重复用。
第二步,顺序扫描切题(分拣员)。程序从头到尾扫一遍文字流,按"章标题→节标题→试题编号"的事件序列切出一道道题。关键设计:不按"章+题号"对齐,按文档流出现顺序给每道题编号(book_order)——书里第几道就是第几道,从根上杜绝覆盖。
第三步,严格解析四要素(质检员)。每道题解析出题干、选项、答案、解析。选项必须满足A→B→C→D的序列约束,防止把题干里的"A、B两个开发人员"误判成选项——我要求选项起点前至少有4个字的题干,才认。
第四步,答案校验链(审计员)。每道题的答案从四个来源兜底,每个答案的来源都记录在案、可追溯:
| 1107 | |||
| 59 | |||
| 195 | |||
| 131 |
图 4 · 四级答案兜底链构成(总 1,492 题,每题来源可追溯)
四级兜底之后,1,492题答案齐全。其中13道"极性表述"题(解析只说"X错误"没说选谁)逐题人工审计过——AI判断不是黑箱,每一个答案都有出处,错了能查到根。
意外收获:程序替我做了一次知识时效性审查
构建管线跑完,我顺手加了一条规则:题干、选项、来源标签里命中"十四五/第十四五/2035年远景"关键词的题,自动标记排除。
结果排掉了6道题——全是考"十四五"规划内容的题。我的备考决策是第4版教材+2027年考期,这些题的知识点已经更新换代,做它们等于背过期地图。
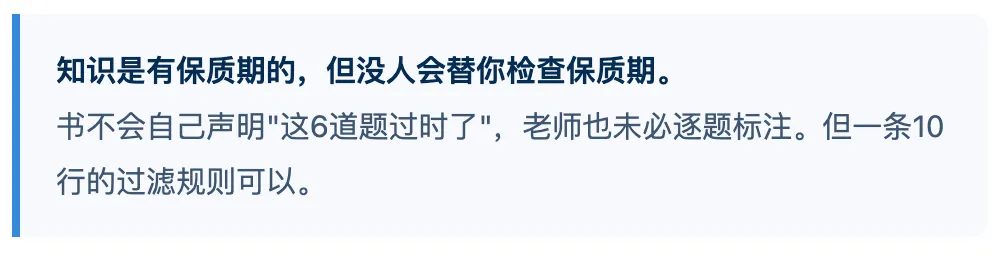
你的行业资料、考试大纲、内部规范,有没有同类的"过期存货"在污染你的学习?值得用同样的思路扫一遍。
拆解事故:360道题是怎么丢的
技术方案听起来顺,但第一版翻车翻得很典型——值得单独拆给你看。
现象:第一版题库跑完,我核对总数:1,492题只识别出1,132,丢了360道。更诡异的是第3章3.1节——目录写明26题,题库里只剩6题。
图 3 · V1 / V2 主键设计对比:360 道题的丢失与找回
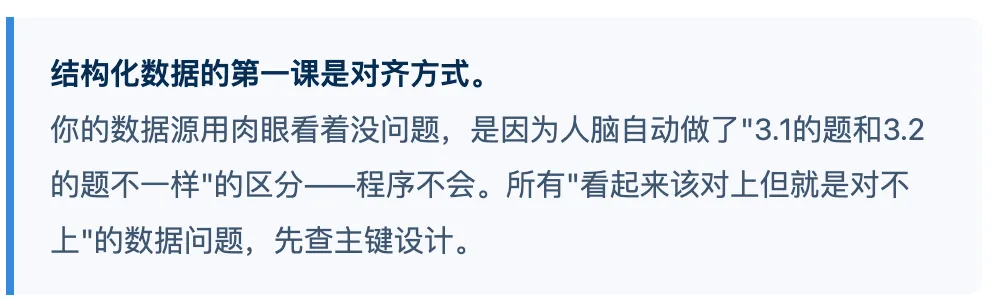
排查:dump出原始识别数据逐行比对,发现题号是"每节重新计数"——3.1的试题1和3.2的试题1在"章+题号"主键下是同一条记录,后写入的把先写入的覆盖了。丢的360道题,全是这样被自己人"吃"掉的。
修复:主键从"章+题号"改成"章+文档流偏移量"——不关心书里怎么编号,只关心它出现在文档流的第几位。重建后1,492题一题不丢,且天然严格书序。
用起来:从错题到改进计划的自动闭环
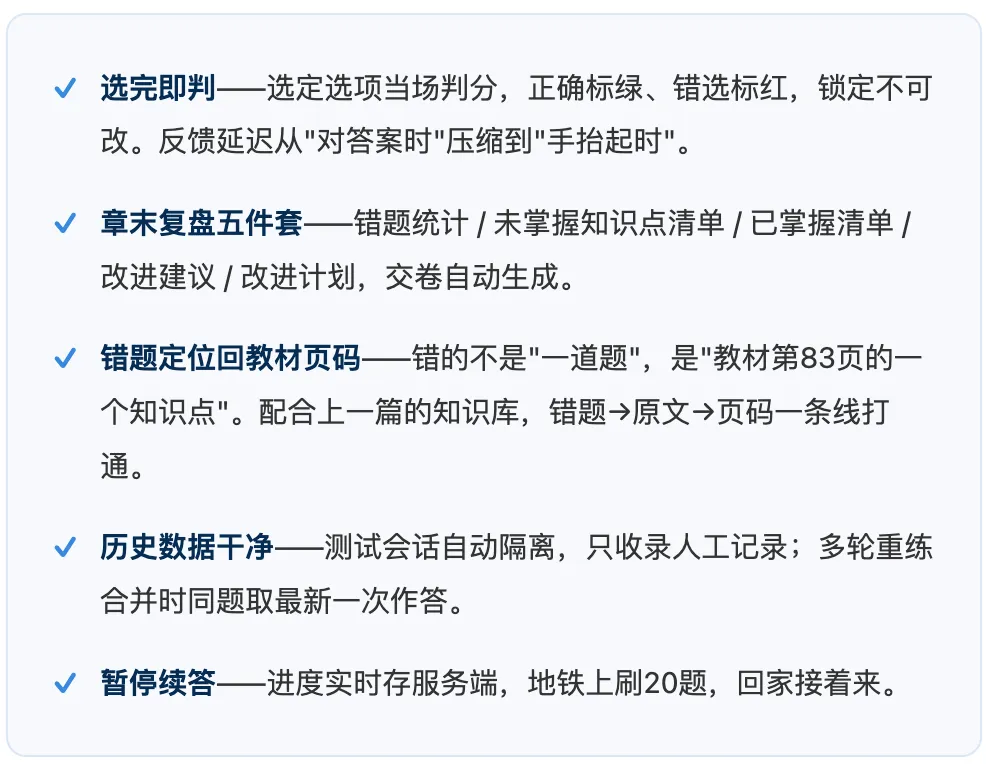
题库只是原料,真正值钱的是这套复盘闭环:
掌握度三级分级长这样:
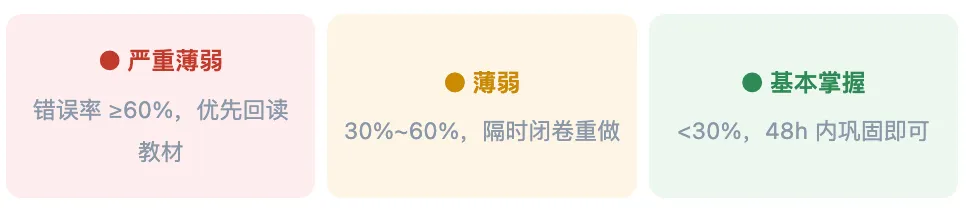
这套闭环跑下来,我的第一份复盘报告里最有价值的一行不是正确率,而是:"2.1 信息技术及其发展:5题5错,严重薄弱"——纸质题册永远不会替你把这行字写出来。
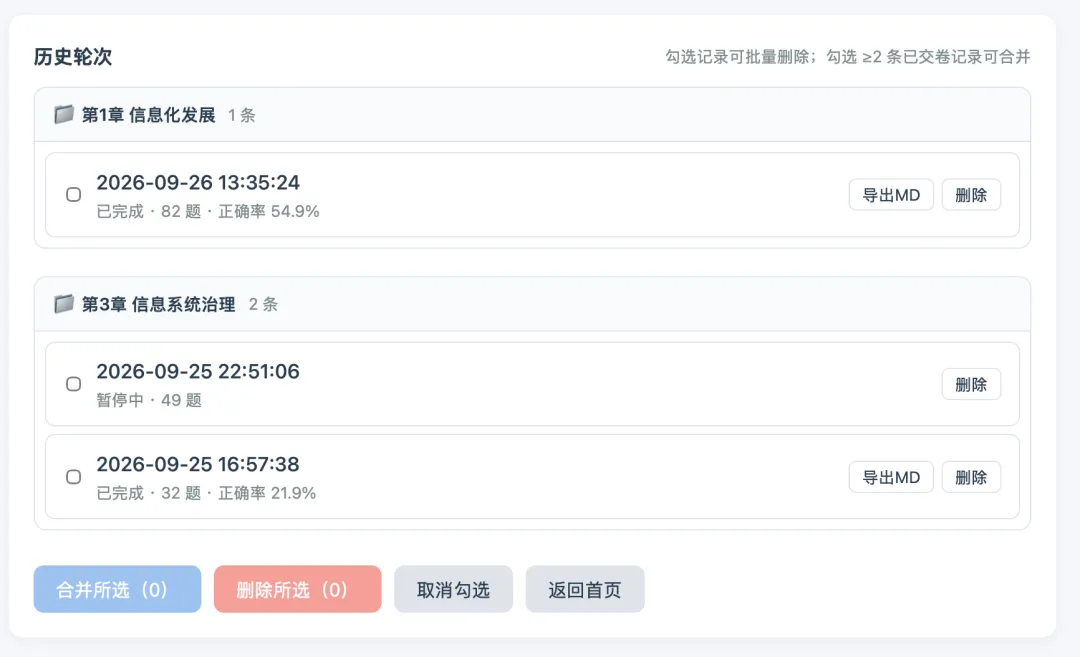
图 5 · 答题情况历史回溯复盘功能界面(支持导出)
你适合做吗?三个判断标准
满足任意一条,就值得:
1. 你在备考一本大部头——软考、法考、CPA、考编,题量大、周期长、错题规律值得被统计;
2. 你有错题本但从不回看——程序替你自动收集、自动分级、自动生成重练计划,比手抄错题本省一个数量级的精力;
3. 你受不了"刷了但不知道薄弱在哪"——数据化的意义就是把模糊的自我感觉,变成可执行的补强顺序。
技术门槛比你想的低。核心难点不在代码(AI辅助写代码,你描述需求就行),而在两件事:一是数据对齐设计(上文360题事故就是反例),二是答案可靠性验证(四级兜底链就是干这个的)。这两件事想清楚了,剩下的都是体力活。
复刻路径就三步:
1. 先拿电子版题册——有文字层的PDF最好,扫描版就挂机OCR;
2. 设计好数据结构再动手——每题必带:章节/节号/文档流序号/页码/答案来源字段。宁可开始前多想半小时,不要重建三次;
3. 先用免费题源验证流程——拿一本习题册的电子版跑通全流程,确认判分、复盘、页码定位都正常,再上你自己的备考材料。
写在最后
「时间地理」· 本地AI备考实战系列 · 第 2 篇
系列第 1 篇:


