

日常中最怕的不是数据不够,而是数据散、实时难、运维重,一套业务要搭多套异构引擎。
业务场景:业务库产生的订单、台账数据,一边要实时更新做业务大屏,一边要离线汇总做管理报表;原始明细需要长期归档审计,同时还要支持多维钻取分析。 传统方案只能拆成多套独立系统,数据多副本、口径难统一,实时写入还容易产生大量小文件,湖表维护成本居高不下。 |
现在一起来看看湖仓数据平台是怎么通过开源项目数仓分析平台(Apache Doris)、数仓建模平台(Apache Kylin)、数据湖分析平台(Apache Paimon)、数据湖运维平台(Apache Amoro),四大组件一体化解决痛点!
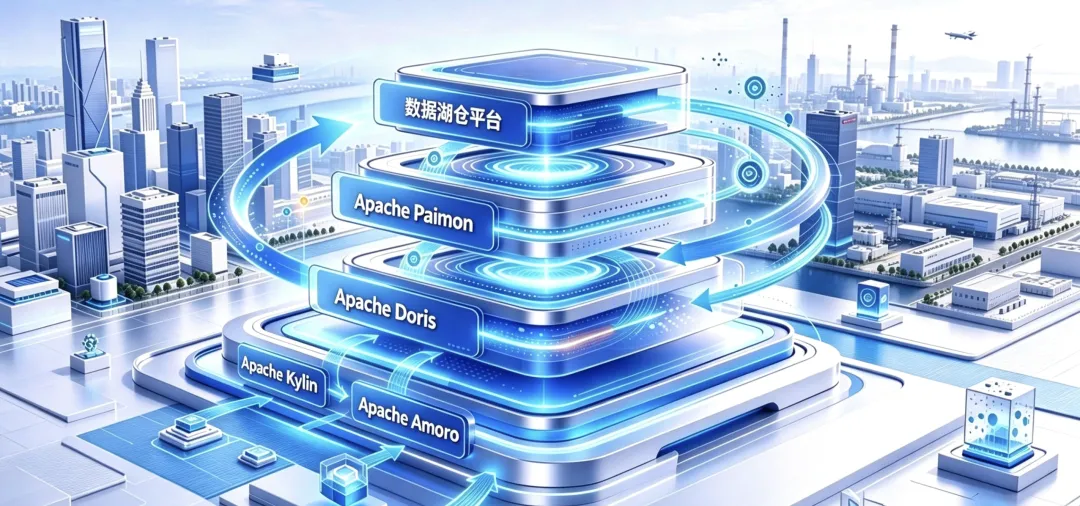
数据湖仓平台模块,4大功能拆解 |
一、数仓分析平台 (Apache Doris)
数仓分析平台基于Apache Doris构建可视化OLAP工作台,在 AllData数据中台统一纳管Doris集群,覆盖交互式SQL开发、元数据管理、查询会话监控、日志审计诊断、集群参数配置、硬件资源基线巡检,实现Doris数仓开发、运维、故障排查全链路闭环。
Apache Doris项目地址:https://github.com/apache/doris
Apache Doris官方文档:https://doris.apache.org
1、Doris交互式SQL开发与元数据探查能力
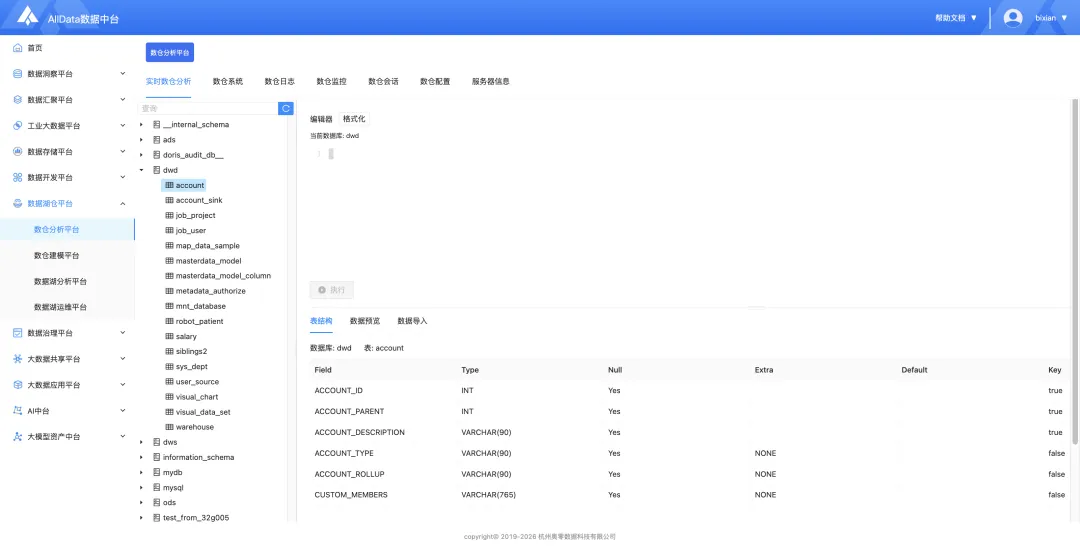
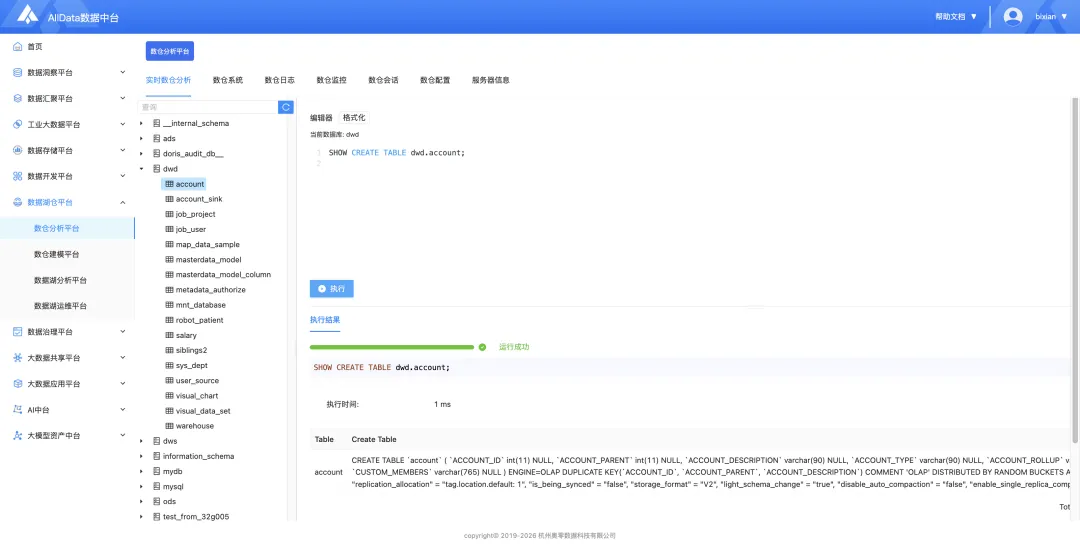
支持在线编写、执行和格式化Doris SQL,可视化浏览集群、数据库、数据表和分区对象,并可一键查看表结构、建表语句、数据预览及导入结果,帮助数仓开发人员快速完成表探查、指标分析和临时查询,无需额外客户端即可在数据中台内直接操作Doris。
实时数仓分析:快速数据表结构和数据,快速定位数据
编辑器支持通过SQL语句对数据表进行查处并展示执行耗时与执行结果
2、Doris集群运维监控与配置资源管理能力
提供Doris集群的可视化运维能力,包括查询任务监控、活跃会话管理、日志查看与异常诊断,同时支持集群配置参数、版本信息和节点硬件资源的集中展示,可用于集群状态巡检、SQL性能排查、参数调优和容量评估。
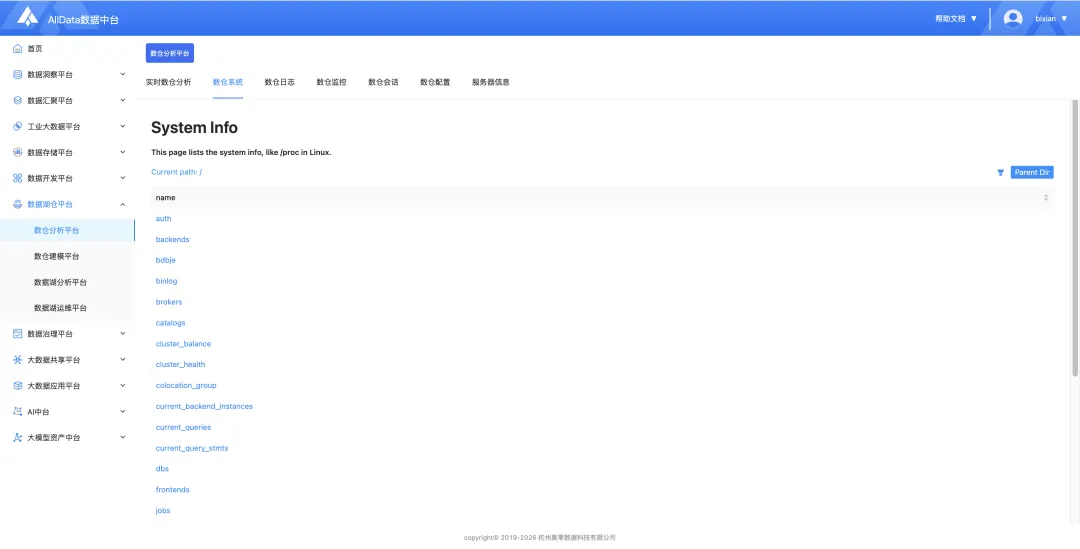
数仓系统:用于查看集群元信息、节点状态、负载、数据库列表、任务信息,用于集群巡检
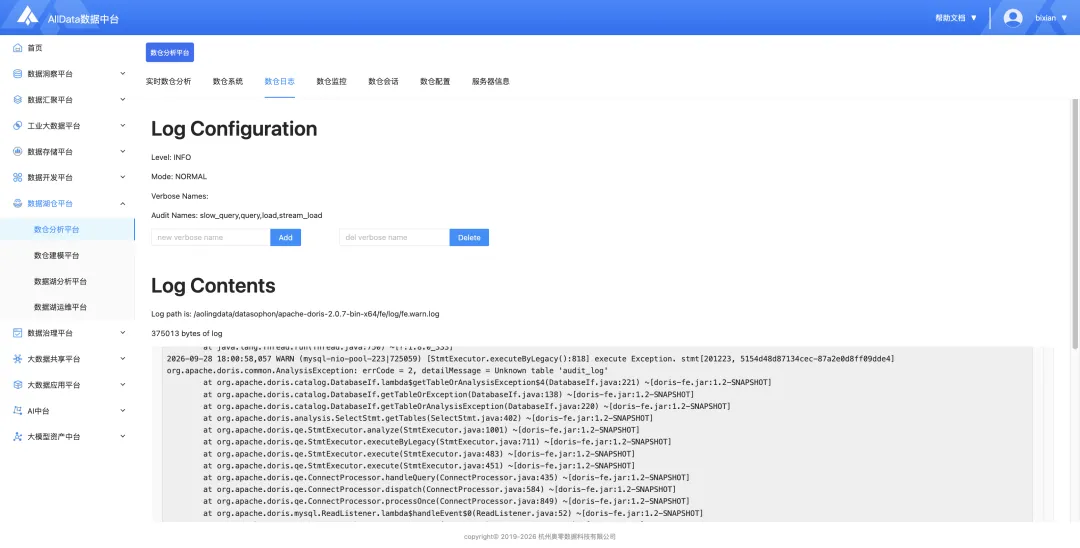
数仓监控:查看管理审计历史 SQL、定位慢查询、查看已结束任务耗时
二、数仓建模平台 (Apache Kylin)
AllData数据中台集成开源项目Kylin建设数仓建模平台,多维OLAP分析引擎基于预计算多维立方体技术Apache Kylin构建,是AllData数据中台海量数据多维分析核心组件,提供 B/PB级数据高并发、亚秒级多维分析能力。
数仓建模平台支持多源数据接入,流批融合Cube构建,预聚合多维指标;具备SQL查询、模型智能推荐、BI工具对接、元数据管理、访问审计能力,业务人员可视化完成多维模型搭建、指标预计算、自助报表分析,适配经营报表、大屏看板、多维自助分析场景,降低海量数据高并发查询成本。
Apache Kylin项目地址:https://kylin.apache.org/zh-Hans/docs/overview
1、多源数据接入与Cube预计算建模
可视化配置多源数据接入,依托Kylin多维Cube预计算引擎,支持离线与流批融合模型构建,自动预计算维度组合聚合指标。
✅ 支持Hive、MySQL、Kafka、数据湖等数据源接入,基于Spark引擎完成Cube构建;
✅ 亿级至PB级数据可实现亚秒级查询响应,支撑上千并发用户同时访问;
✅ 可视化拖拽建模,自动推荐维度与度量,无需深度调参即可完成多维指标预计算,构建任务支持进度可视化监控。
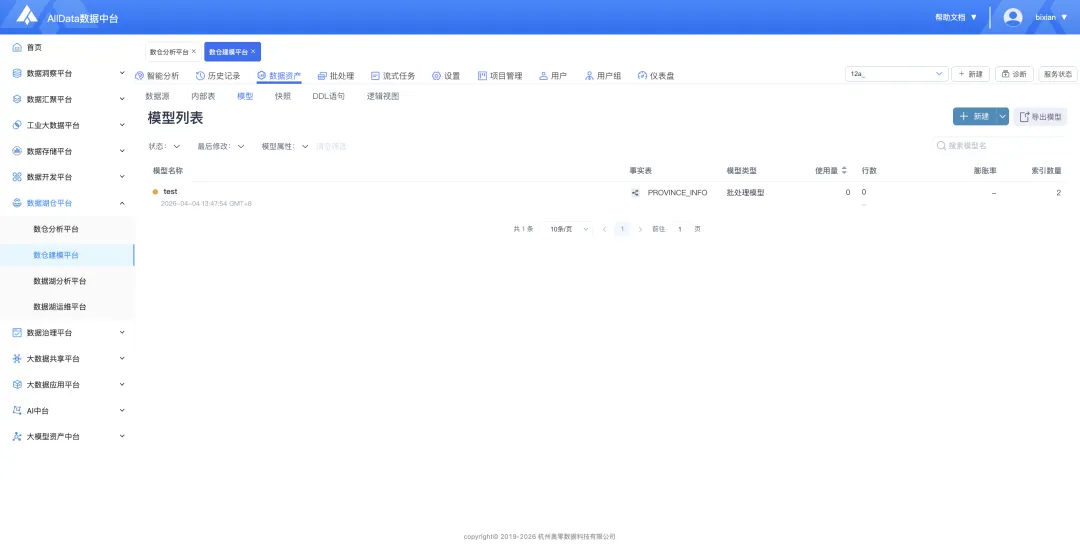
数据资产-模型页面
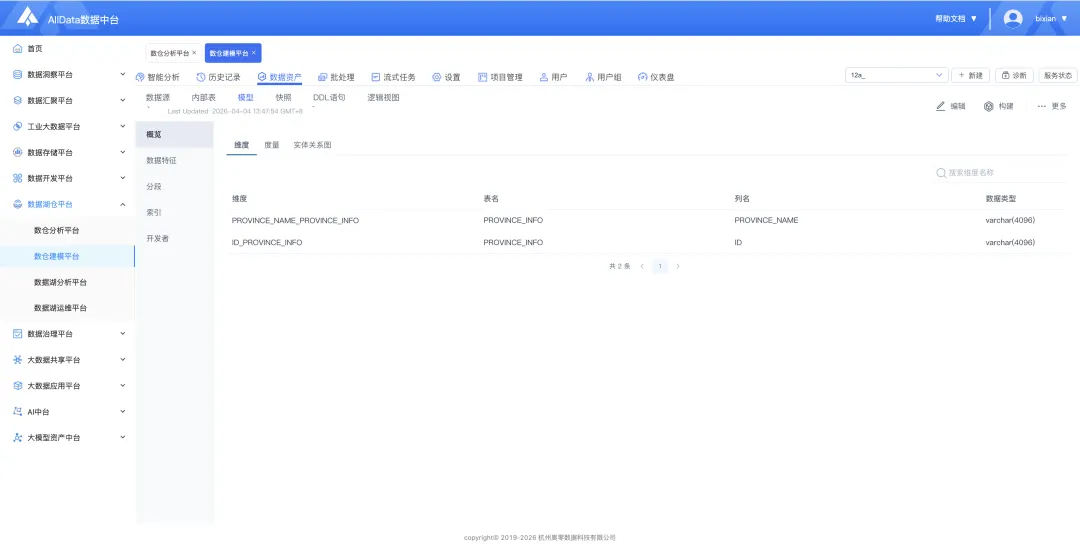
数据资产-模型详细页面:通过勾选维度、度量指标完成多维分析模型的搭建;同时支持数据源接入管理
2、自助多维分析与BI一体化
依托Kylin标准SQL接口,实现多维指标快速查询,结合元数据管理、权限管控,支持业务人员自助式多维分析。
✅ 预计算结果直接对外提供SQL服务,可无缝对接Tableau、PowerBI、Excel等主流BI工具;
✅ 内置数据模型管理、数据血缘、查询历史分析,自动优化Cube模型提升查询效率;支持行列权限、访问审计、查询限流;
✅ 提供标准SQL查询、可视化报表、指标下钻分析,面向业务快速完成多维度经营统计。
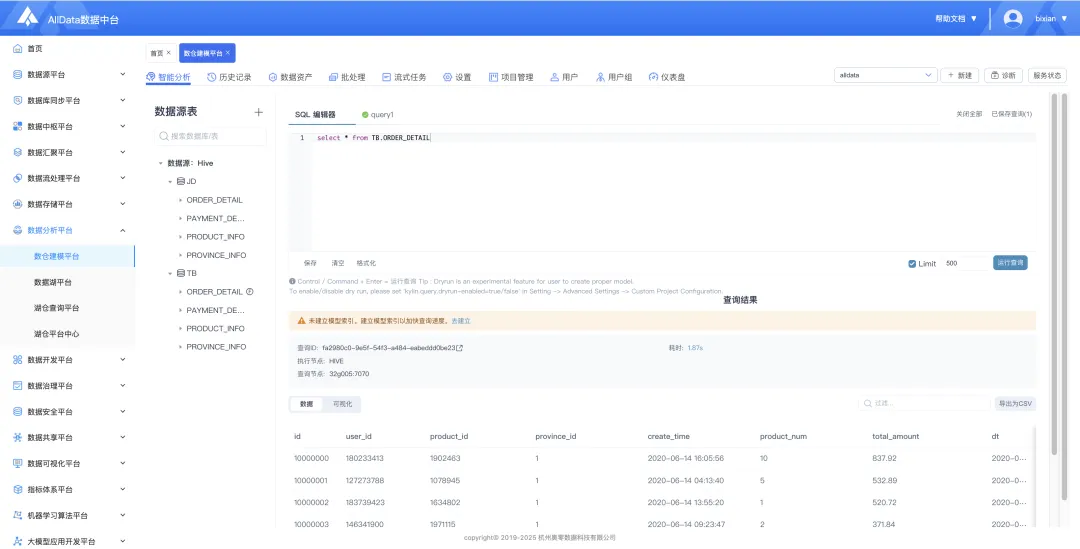
智能查询:提供SQL编辑器,执行查询
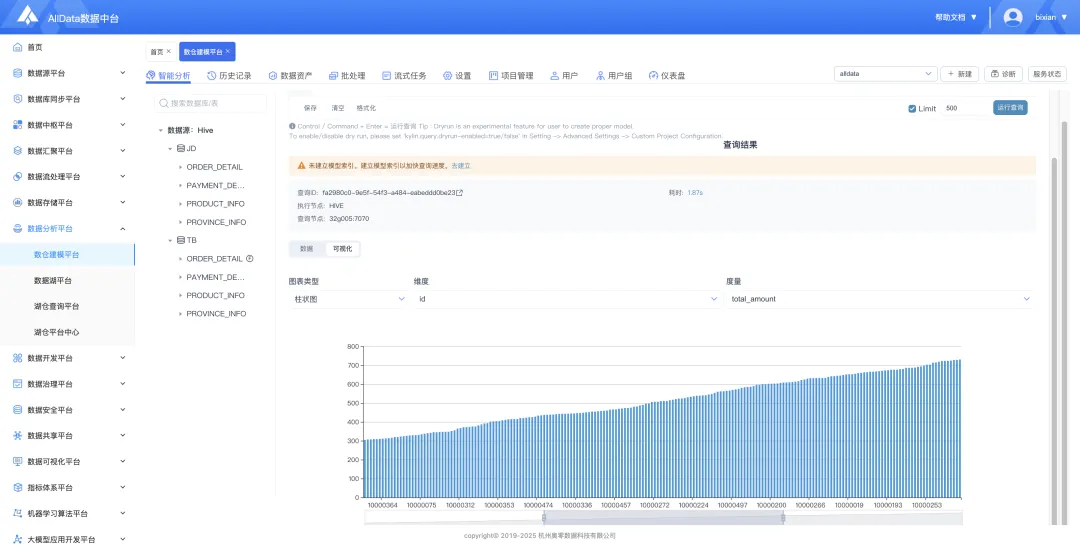
支持结果直接切换生成柱状图、折线图等可视化图表,完成自助数据分析
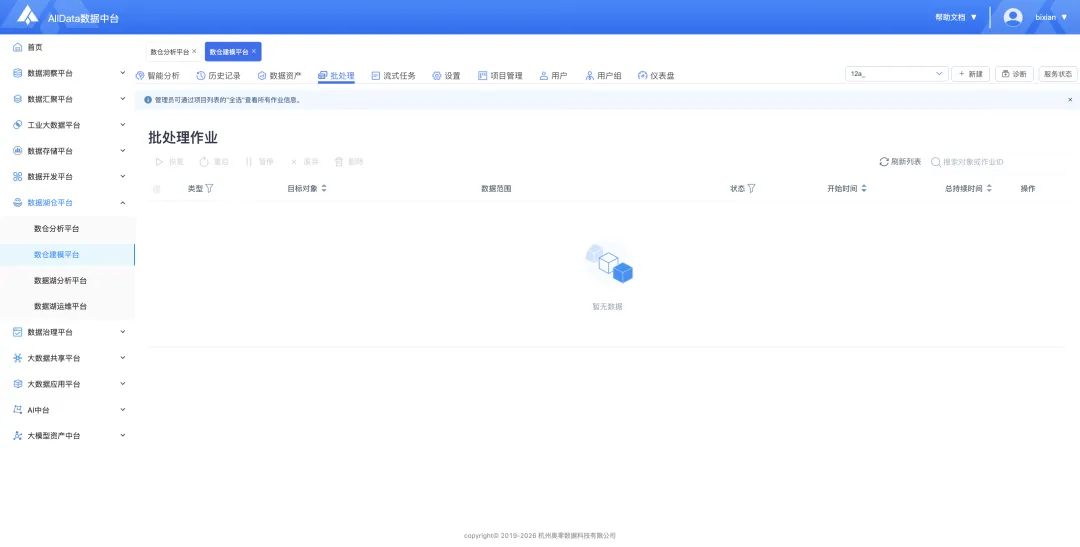
批处理:执行Cube构建预计算任务,生成Cube物化视图,预聚合数据,实现海量数据亚秒查询
三、数据湖分析平台 (Apache Paimon)
数据湖分析平台基于流批一体存储Apache Paimon构建,是AllData数据中台数据湖核心组件,提供全域数据汇聚、清洗治理、湖仓一体低代码分析能力。
平台支持20+数据源一站式接入,实时/离线流批一体同步,内置数据清洗规则;具备湖仓互通、元数据与血缘管理、大模型智能问答,配套权限、快照、审计能力,业务人员可视化完成数据接入、清洗、分析导出,适配业务库、文件、物联网等入湖场景,降低数据湖落地门槛。
Apache Paimon项目地址:https://github.com/apache/paimon-web
Apache Paimon文档地址:https://paimon.apache.org/docs/1.0/concepts/overview/
1、多源流批一体数据接入与智能清洗
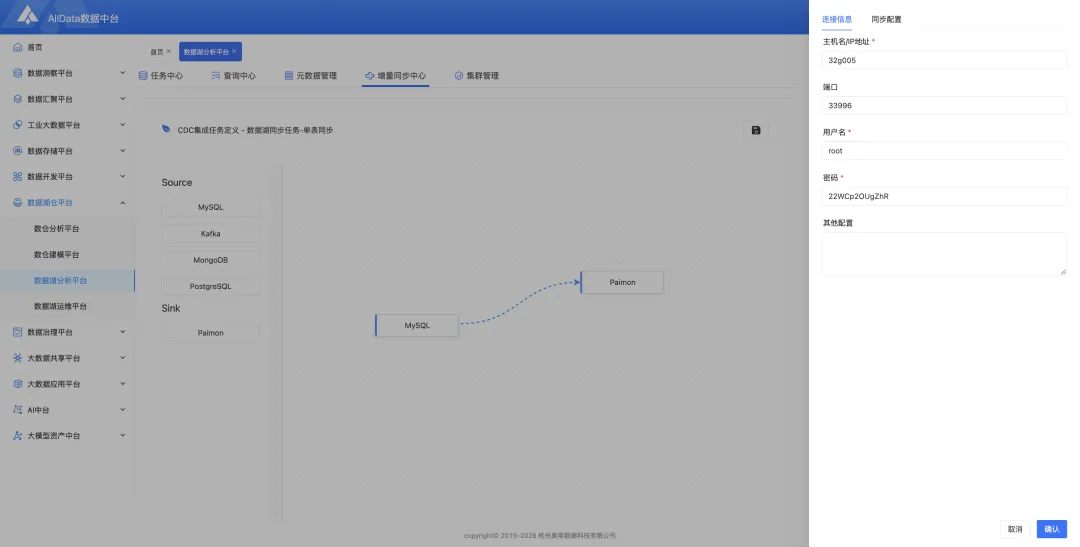
可视化配置完成多源数据源接入,依托Paimon流批统一读写、CDC变更捕获能力,支持实时CDC与定时离线同步,内置自动清洗规则实现数据标准化处理。
✅ 支持MySQL、Kafka等数据源接入,通过 Flink 引擎将变更数据写入Paimon主键表;
✅ 千万级数据分钟级、十亿级数据小时级同步,基于MergeEngine提供去重、部分更新能力;
✅ 可勾选自动去重、缺失值填充、格式统一等清洗规则,无需编码即可完成脏数据治理,同步任务支持进度可视化监控。
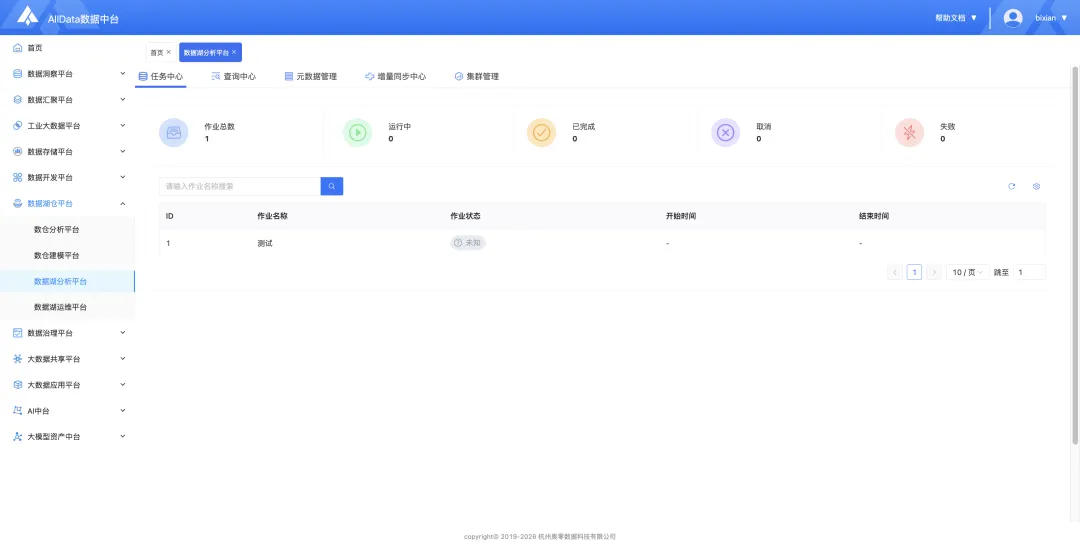
任务中心:快速查看当前任务总情况
增量同步中心-编辑页面:可视化拖拽式配置数据源连接
2、湖仓一体数据治理与低代码智能分析
依托Paimon多引擎兼容能力,实现数据湖 - 数据仓库之间数据无缝流转,结合元数据血缘、细粒度权限与大模型,支持业务人员自助式数据分析使用。
✅ 湖仓之间数据无需格式转换即可互通,Paimon表可被Flink/Spark/Doris直接读写,实现湖仓联合查询;
✅ 内置200+数据质量校验规则,完整数据血缘链路追踪,基于Paimon元数据管理Catalog库表信息;支持字段级权限、数据脱敏、快照备份、访问审计;
✅ 利用Paimon快照机制实现历史版本回溯,同时提供SQL查询、可视化图表、自然语言智能问答,不懂SQL也可获取数据结论。
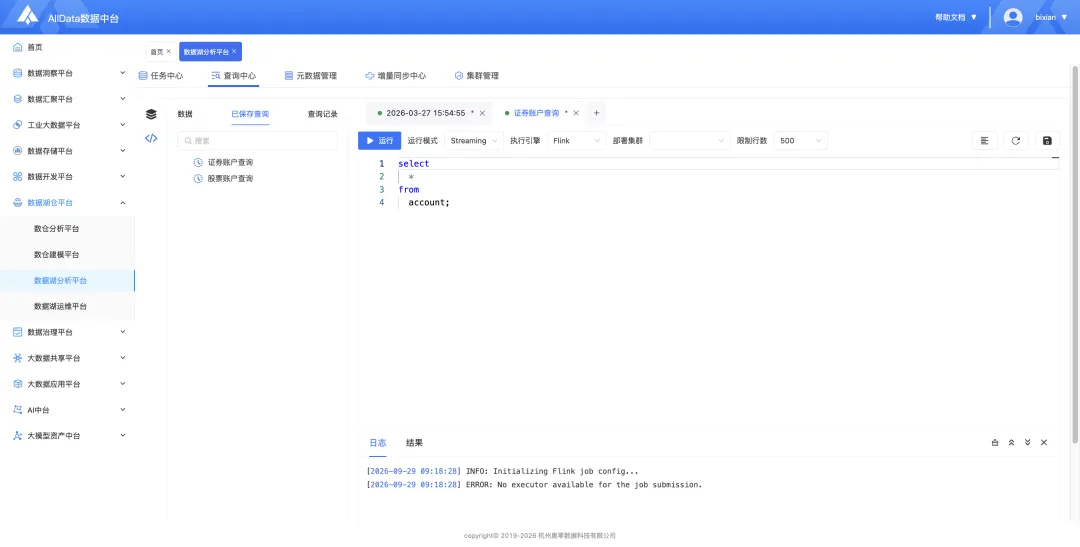
查询中心页面:支持Flink Streaming流模式查询Paimon湖表,在线编辑执行SQL,快速开展湖仓自助数据探查
四、数据湖运维平台 (Apache Amoro)
湖仓自治管理平台基于开放湖表格式管理系统Apache Amoro构建,是AllData数据中台湖仓运维核心组件,提供多格式湖表统一管理、后台自动优化、元数据统一Catalog能力。
数据湖运维平台支持Iceberg/Paimon/Mixed-Iceberg等多种表格式,自动执行小文件合并、快照清理、过期数据回收;具备跨引擎统一元数据、资源隔离、表运维监控、访问审计能力,开发人员低负担完成实时湖仓表运维,适配CDC入湖、实时数仓、离线分析场景,大幅降低数据湖运维门槛。
Apache Amoro开源项目:https://github.com/apache/amoro
Apache Amoro文档地址:https://amoro.apache.org/docs/latest/
1、多格式湖表接入与后台自治优化
可视化接入各类数据湖表,依托Amoro AMS管理服务,提供表文件自动运维,无需人工维护合并任务。
✅ 支持Iceberg、Paimon、Mixed-Iceberg、Mixed-Hive多表格式统一管理,对接Flink/Spark/Trino等计算引擎;
✅ 实时CDC写入自动产生的碎片小文件,后台异步执行文件合并、冗余数据清理,保障查询性能稳定;
✅ 可配置快照过期、孤儿文件清理策略,自动回收过期数据,降低存储成本,优化任务支持资源分组隔离与可视化监控。
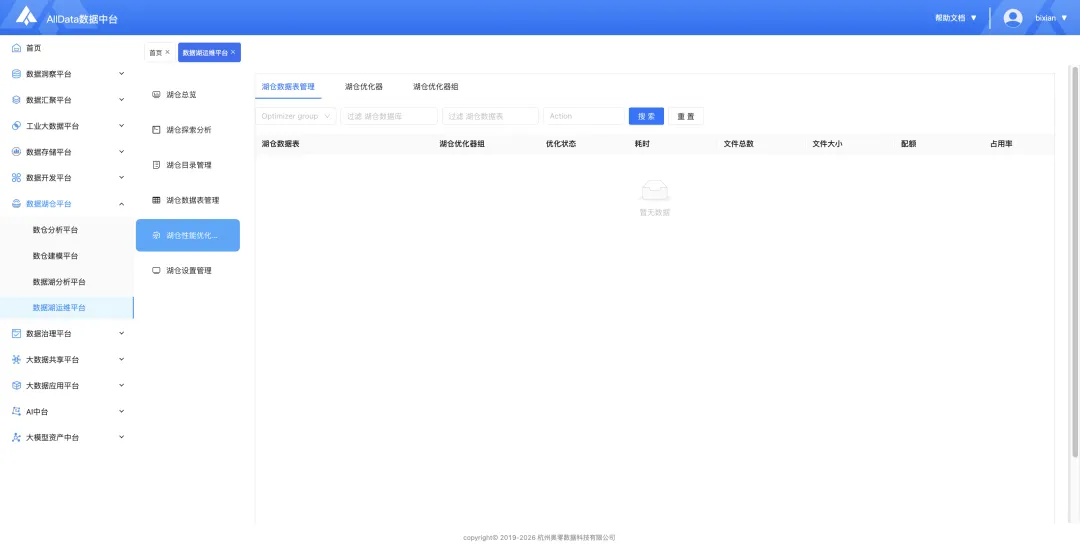
湖仓性能优化页面:依托Amoro AMS管理服务,可视化管理湖表自治优化任务与优化器资源组,自动执行小文件合并、快照清理,支持资源分组隔离,实时查看优化任务状态、文件指标,保障湖表查询性能稳定
2、统一元数据服务与湖仓运维治理
依托Amoro统一Catalog能力,实现多引擎共享一套湖表元数据,结合表监控、权限与审计,支撑湖仓一体化稳定运行。
✅ 统一Catalog对外提供标准元数据服务,可对接现有Hive元仓,一套元数据供Flink、Spark跨引擎读写;
✅ 内置表健康监控、文件指标、快照版本管理,完整记录表变更血缘链路;
✅ 支持表级资源配额、字段级权限、访问审计;提供SQL终端、Web管理面板,开发人员可以直接管理湖表、查看表健康状态,简化实时湖仓运维工作。
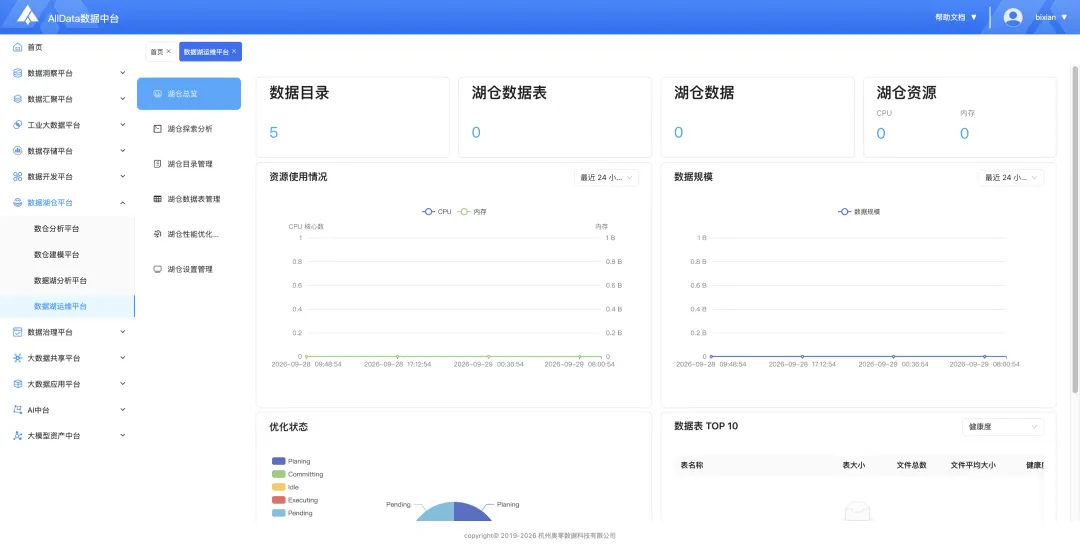
湖仓总览页面:集中展示湖仓目录、数据表、资源占用、数据规模、优化任务及表健康指标,实现湖仓集群整体状态可视化监控
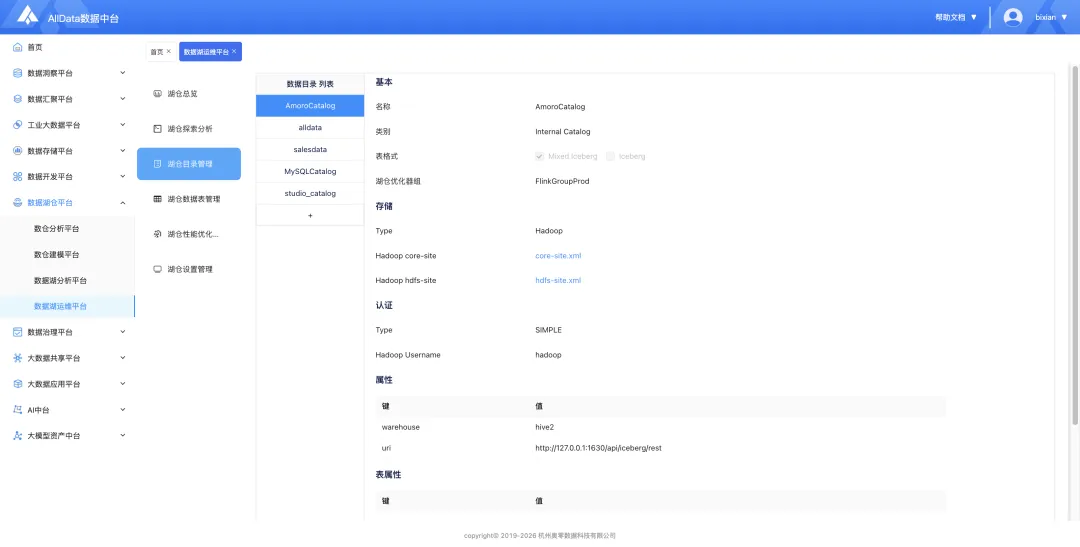
湖仓目录管理页面:可视化配置多类型Catalog,支持多种湖表格式,对接Hive元数据,实现跨引擎共享统一湖表元数据
4大功能核心定位与场景选型 |
Apache Paimon是湖存储、Apache Amoro是湖运维管理、Apache Doris是实时数仓查询引擎、Apache Kylin是多维预计算建模引擎。
1、数仓分析平台(Apache Doris)
核心定位:高性能MPP实时分析引擎,统一离线与实时数仓查询,支持多源数据联邦查询,秒级响应海量多维分析,可直接对接ODS/DWD分层数据,支撑报表、自助分析。
适合场景:
实时大屏、业务自助多维分析、固定指标报表; 高并发即席查询,海量明细+聚合混合查询; 多数据源融合查询(MySQL、Hive、Paimon等); 政务、制造、能源业务的T+0/T+1数仓落地。
核心定位:预计算OLAP多维立方体引擎,通过预聚合Cube,牺牲写入灵活性换取超高并发、超稳定的固定指标查询性能,面向定型指标体系。
适合场景:
指标体系稳定、查询模式固定的企业级看板、管理报表 大基数历史数据,高并发访问(大量业务人员同时查询) 传统 BI 对接,需要固定维度组合的汇总指标查询 不适合频繁变更维度、临时即席明细查询场景
3、数据湖分析平台(Apache Paimon)
核心定位:流批一体数据湖存储,构建可变更的湖表,支持CDC实时入湖、增量快照读取,统一实时流与离线批存储,作为湖仓底层存储层。
适合场景:
业务库CDC实时同步入湖,构建ODS/DWD湖分层; 需要版本回溯、快照查询、数据审计、回滚场景; 流批一体开发,Flink 实时写入 + 离线批量分析共用一套表; 多引擎共享底层湖数据(Doris、Spark 等读取Paimon湖表)。
4、数据湖运维平台(Apache Amoro)
核心定位:湖表自治管理运维平台,对Iceberg/Paimon等湖表进行后台自治优化,自动小文件合并、快照清理、过期数据回收,湖元数据统一管理与湖健康监控。
适合场景:
Paimon/Iceberg数据湖长期稳定运行,解决小文件爆炸问题; 大量实时CDC写入湖表,碎片文件持续生成场景; 统一Catalog管理、湖表健康巡检、优化任务调度运维; 降低数据湖运维门槛,减少人工维护快照、文件清理成本。


