每个做影像 AI 的研究生,都经历过这样的高光时刻:模型第一次跑通,准确率 95%,截图发到课题组群里,配文“初战告捷”。然后导师只回了一句话:“你按什么分的训练集和测试集?”就是这句话,让无数 95% 变成了 66%。今天这篇笔记,把数据集划分讲成一件考场上最朴素的事:出一张不许泄题的考卷。全程不讲数学,只讲纪律。
01|一个模型的三份卷子
模型学习和学生备考,几乎是同一件事。你手里的数据,要分成三份卷子,各司其职:
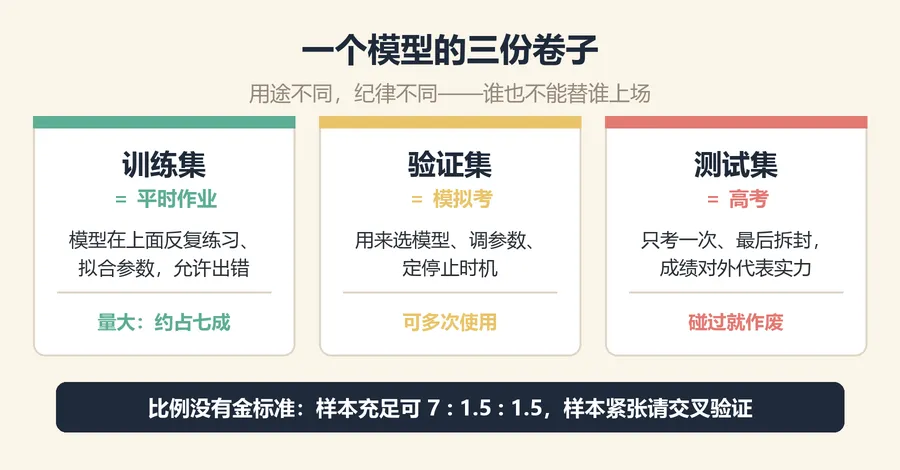
图 1:训练集、验证集、测试集——平时作业、模拟考与高考的分工
训练集是平时作业:模型在上面反复练习、拟合参数,允许它出错、允许它背题。 验证集是模拟考:用来比较候选模型、调超参数、决定什么时候停止训练。它可以考很多次,但它参与了“选人”,所以它的成绩永远偏乐观。 测试集是高考:只考一次,最后才拆封。论文里那个对外宣称的性能,必须由它说出。
新手最常见的错误,是把模拟考的成绩当成高考来报——模型调到验证集上最好看的那一刻,验证集就不再中立了。
至于比例,先说结论:没有金标准。样本充足时,常见的 7:1.5:1.5 或 7:2:1 都合理;样本紧张时,硬切一份测试集反而让每份都不够看,这时交叉验证更划算——后面细讲。
02|出卷第一原则:一个病人,只能进一个考场
如果说数据集划分只有一条铁律,就是这一条。先看反面教材:
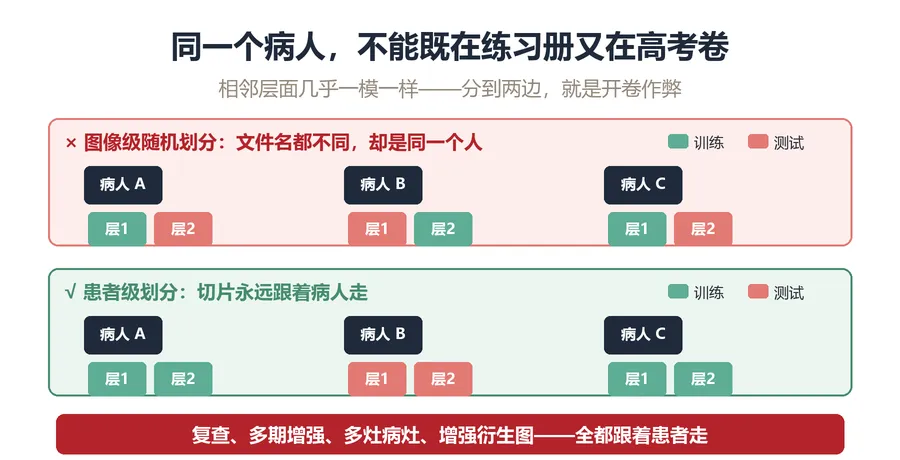
图 2:图像级划分 vs 患者级划分——同一病人的相邻层面被拆到两边,就是泄漏
假设你做一个胸片肺炎分类:每位病人拍了一张胸片,你随手调用随机划分函数,按图像 7:3 分开。看起来没毛病——文件名全不同、图像全不同。
但换成 CT 就露馅了:一位病人的 CT 会被裁成几百层,你把所有层随机打散。相邻两层的解剖结构、噪声纹理几乎一模一样——模型在训练集里见过“这位病人的肺”,测试时再遇到他的另一层,等于拿着他的病历进考场。这叫数据泄漏,是影像 AI 论文里最普遍、也最致命的造假——哪怕你是无心的。
看看真实数据的相邻层面长什么样:
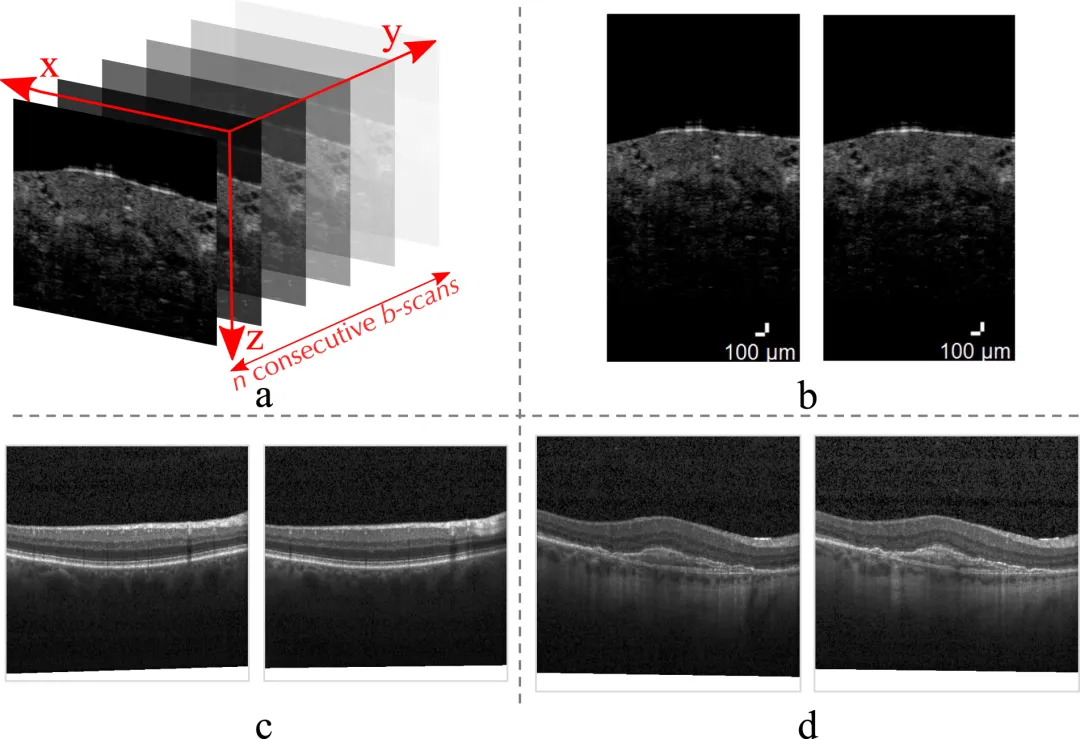
图 3|三个公开 OCT 数据集中的相邻扫描层面:结构几乎完全一致——它们绝不是独立样本 图源:Tampu IE, et al. Sci Data 2022;9:580, Figure 1(CC BY 4.0)
所以纪律是:划分的最小单位是“病人”,不是“图像”。复查随访、多期增强、多发姑灶、裁剪增强产生的衍生图,全都跟着病人走。检查方法很简单:列一张“病人编号 → 所属集合”的对照表,确保没有一个编号同时出现在两边。用公开数据集也要留心——有些数据库自带划分,但不同数据库之间可能藏着同一批病人。
03|数据泄漏的六种姿势
图像级划分只是最出名的泄题方式。按“谁在偷看答案”排查一遍,至少还有六种:
姿势一:先洗牌,再洗澡。标准化要用均值和标准差、去噪要拟合参数——如果这些“需要从数据里学规律”的步骤在全集上做,测试集的统计信息就提前漏进了训练集。正确姿势:先划分,再只在训练集上“学”处理规则,然后原封不动套到测试集上。
姿势二:先筛特征,再划分。影像组学研究尤其高发:在全部病人上筛出一堆有统计学意义的特征,然后才分训练测试。测试病人的结局早就参与了出题。
姿势三:反复摸底。看完测试成绩不满意,换个模型再跑,再不满意再换,最后报告最好的一次。每摸一次底,测试集就向模拟考堕落一步。
姿势四:在考场上调阈值。诊断模型要卡一个阳性/阴性界值。如果在测试集上寻找最佳阈值,再用同一批数据报告敏感度特异度,成绩必然虚高。阈值该在验证集上定。
姿势五:衍生图叛逃。旋转、裁剪、翻转产生的增强图像,被视为“新图”参与划分,与原图分居两集——同一病灶的两张脸隔空相认。
姿势六:幽灵重复。同一病人两次住院、跨数据库重复收录——编号不同,人是同一个。
泄漏的代价有多大?有人专门算了这笔账:
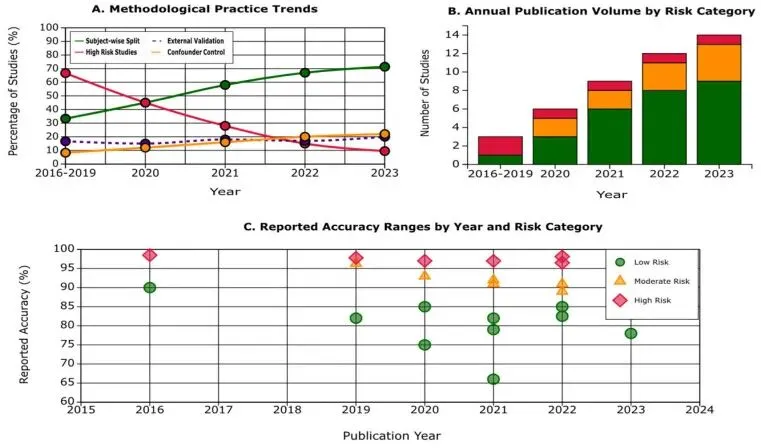
图 4|44 项阿尔茨海默病深度学习研究的复盘:按年份与泄漏风险分类的报告准确率——高风险研究普遍报 95%~99%,规范划分的研究只有 66%~90%图源:Young VM, et al. Diagnostics 2025;15(18):2348, Figure 3(CC BY 4.0)
一张图看懂:方法越不严谨,分数越漂亮。同一课题内直接对比,规范划分能让准确率从 94% 掉到 66%——差的 28 分,全是泄漏送的。审稿人和你导师问“按什么分的”,问的就是这 28 分。
04|病人太少怎么办:把高考改成五次月考
研究生最真实的困境:全中心拢共收了 80 个病人,切成三份,每份都薄得可怜,测试集里才二十来个人,成绩波动比股价还大。
这时别硬切,改用交叉验证:把数据分成五份,轮流拿一份当考生、其余当练习,跑五轮,五个成绩取平均——每一份数据都当过一次高考生,估计更稳定,还不浪费任何一例。
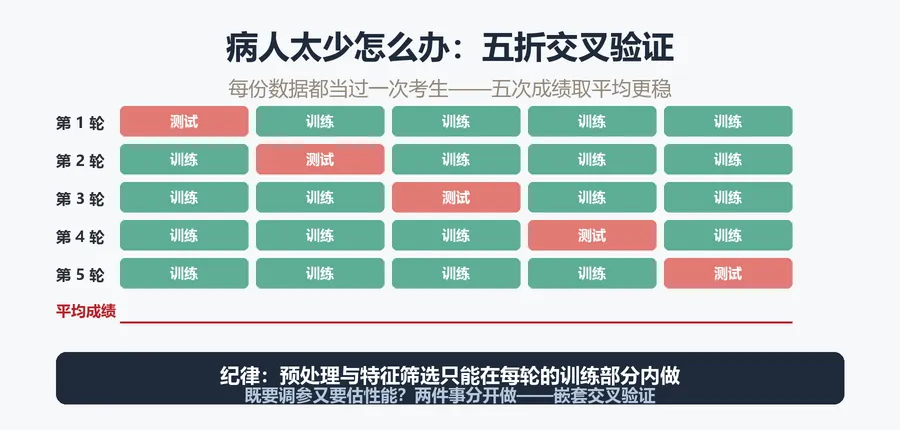
图 5:五折交叉验证——每份轮流做测试折,平均成绩更稳
但交叉验证也有自己的纪律:每一轮的预处理和特征筛选,只能在那轮的训练部分里做。先在全部数据上筛完特征再交叉验证,等于每折的考生都提前看过题。如果要调参又要估计性能,两件事得分开做——外层考性能、内层调参数,也就是嵌套交叉验证。
05|罕见病研究:多数派的陷阱
做罕见病的研究生还有一关:100 个病人里只有 8 个阳性。这时如果随手划分、随手评价,有两个坑等着你。
坑一:accuracy 会说谎。阳性只占 8%,模型闭着眼睛全报“阴性”,准确率也有 92%——它什么都没学会,却拿了高分。所以不平衡任务请看敏感度、特异度、F1 和 AUC,别用准确率自我感动。
坑二:随机划分会翻车。8 个阳性如果全靠手气分,可能训练集里只剩 5 个、测试集里 3 个,甚至某一集一个都没有。用分层抽样:按类别比例分配,保证每份卷子里阴阳比例一致。
坑三:过采样越界。对少数类做过采样、加权、SMOTE 都可以,但只能动训练集。在划分之前对全集过采样,合成样本会同时落进训练和测试两边——合成出来的“双胞胎”分居两集,又是一次开卷。
06|高考之后:还有跨省联考
内部测试做得再干净,也只能回答“在本院、这套扫描流程下的新病人身上表现如何”。模型到了别的医院,设备不同、人群不同、扫描协议不同,成绩几乎必然缩水——缩水多少,就是外部验证要回答的问题。
外部也有讲究:三家医院混在一起再随机划分,只是“混合分布里的新病人”;用两家训练、整家留出测试,才是真正的跨机构考试;用早期病人训练、后期病人测试,检验的是时间的侵蚀。三种安排回答三个不同的问题,别混着说。
外院成绩不好看,也可以在本地微调模型——但要说清三件事:原模型表现、怎么改的、改完用什么数据评估。同一批本地数据既用来改又用来考,成绩不算独立。最后是成绩单的规范:患者数和图像数都要报(只报 5 万张图不报 300 个病人,读者无法判断独立性)、给出置信区间而不是光秃秃一个均值、输出概率的模型还要看校准曲线。投稿前对照 CLAIM 2024 清单逐项打钩,能挡掉大半审稿意见。
07|发卷前自查清单
把这篇笔记压缩成一张卡,训练开始前逐条过一遍:
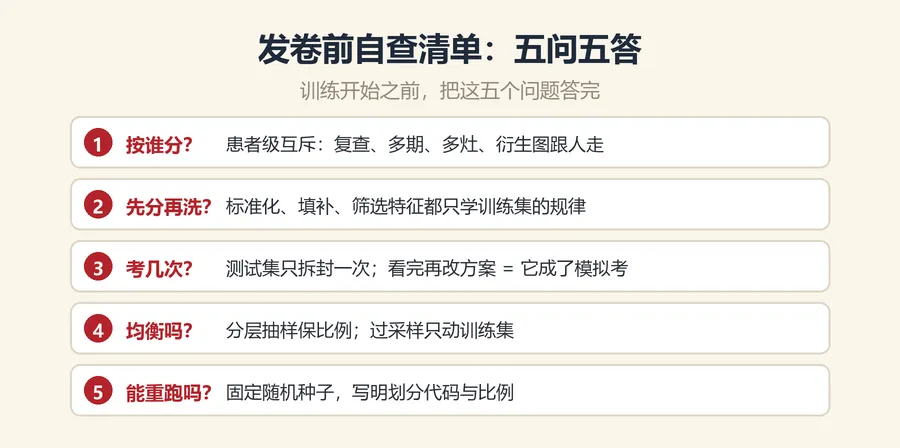
图 6:发卷前五问——层级、时机、纪律、均衡、可复现
[批] 一句话带走
训练是作业、验证是模拟考、测试是高考;最小单位是病人不是图像;需要“学规律”的步骤只碰训练集;测试只拆封一次;分数越好越要问一句——按什么分的。
写在最后
数据集划分没有任何高深的数学,它考的是纪律和诚实。95% 的准确率人人爱看,但只有经得起“按什么分的”这句话拷问的模型,才配写进论文、走向临床。
下次跑通模型的那一刻,先别发群。把这张对照表打开,确认没有病人的脸跨在两个考场里——然后,再报你的分数。