

老师已经为大家准备好电子打印版,需要完整电子版文件的朋友,可以拉到文末查看。 【答案解析】
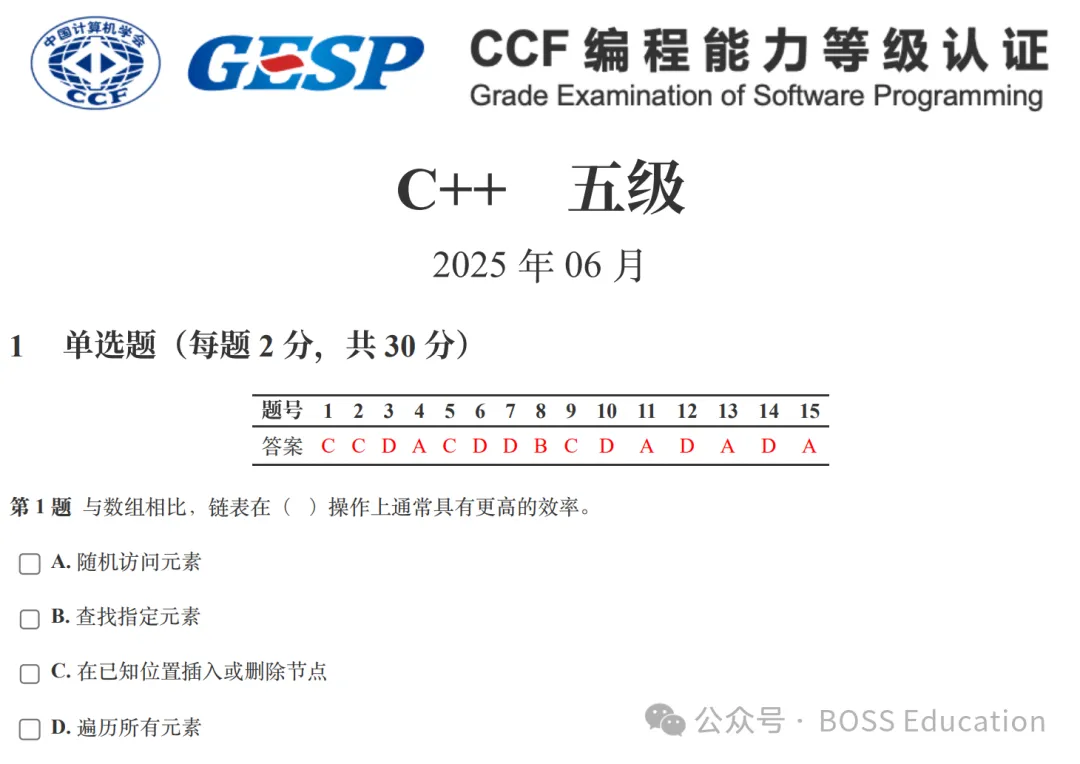
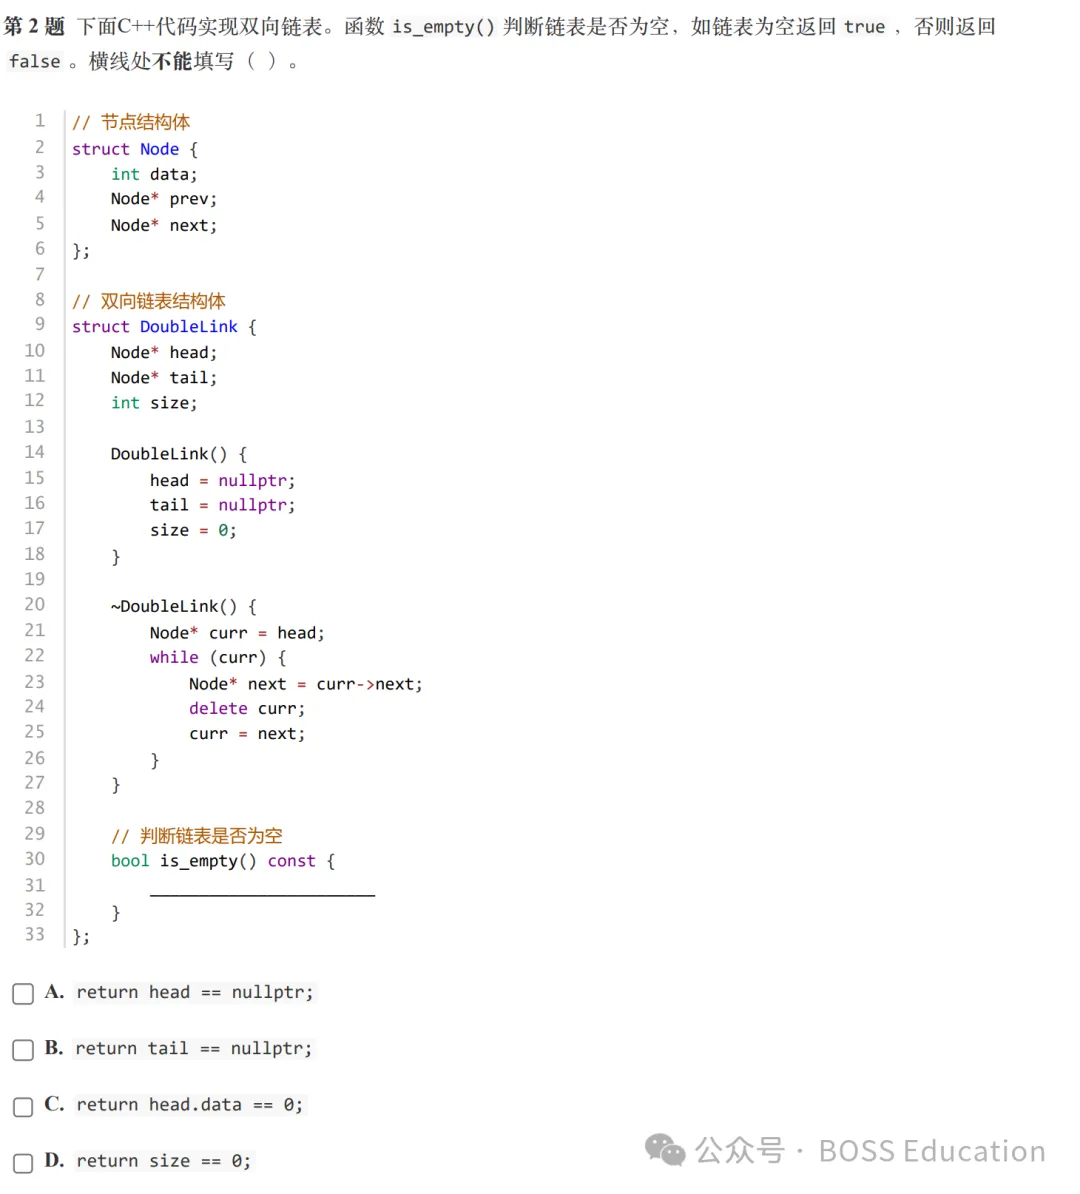
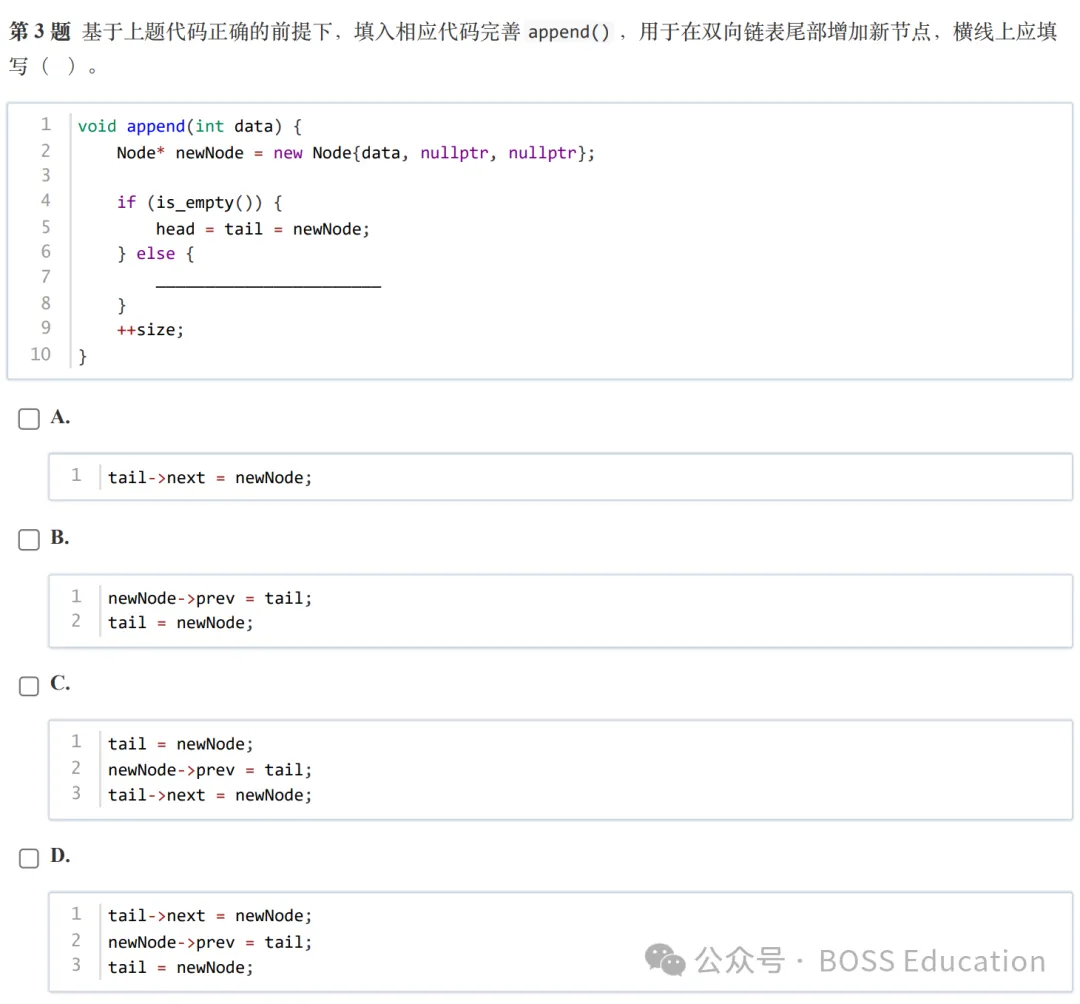
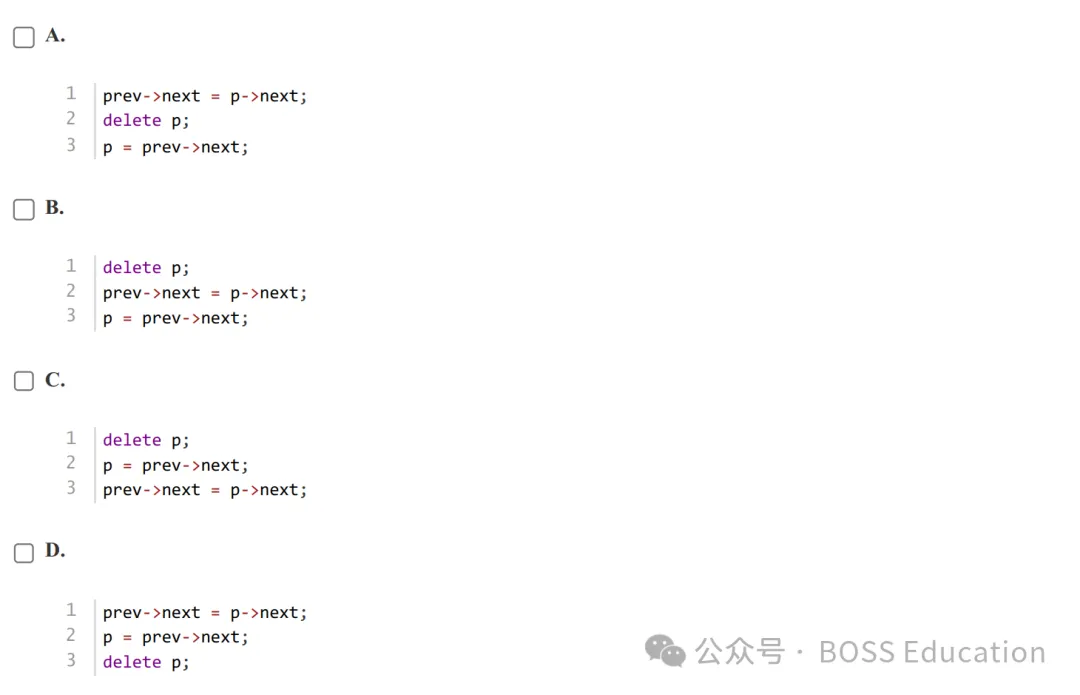
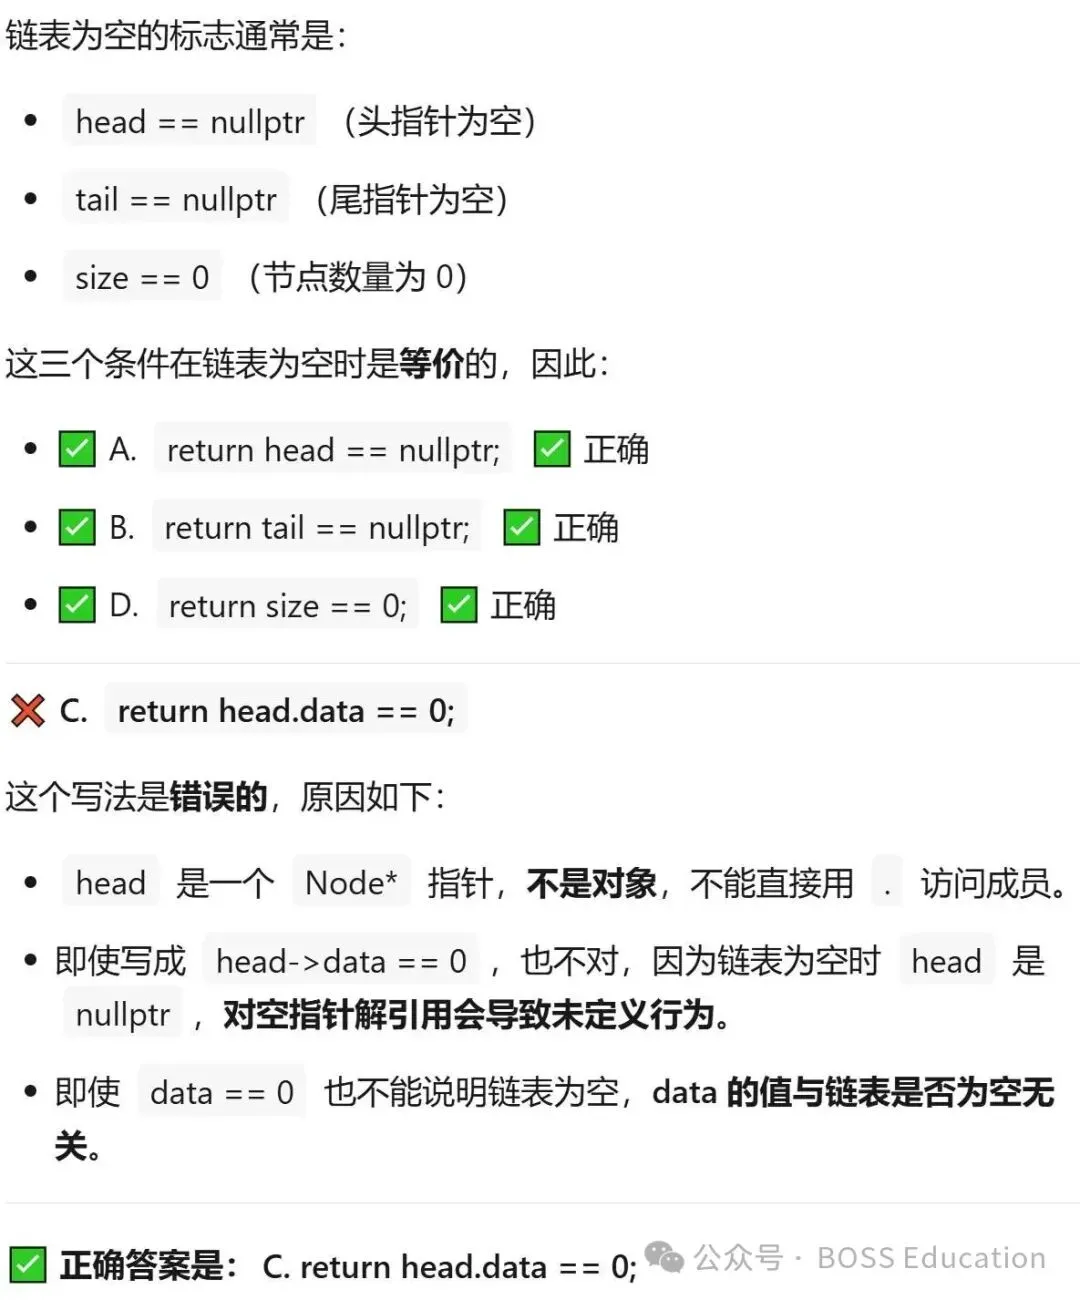
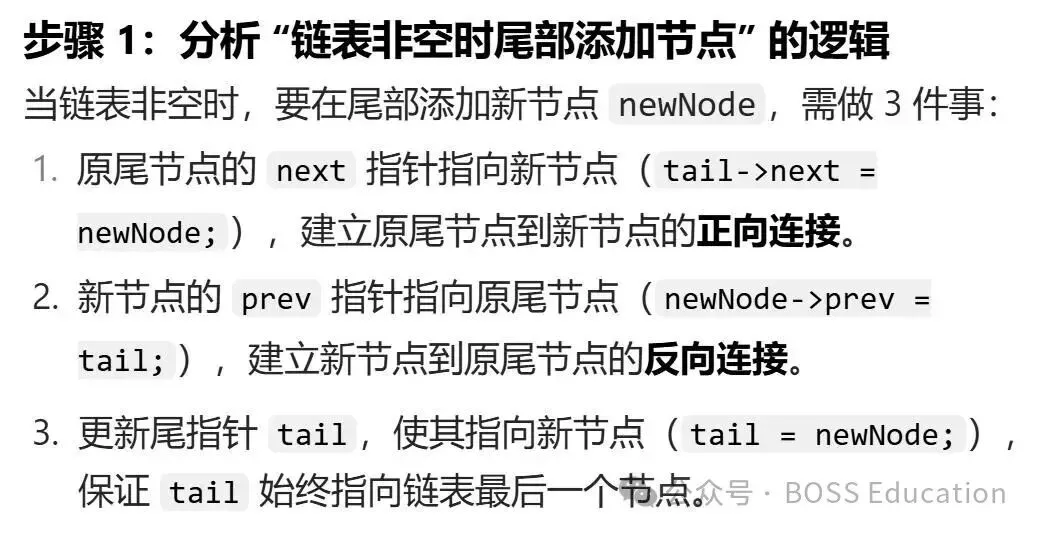
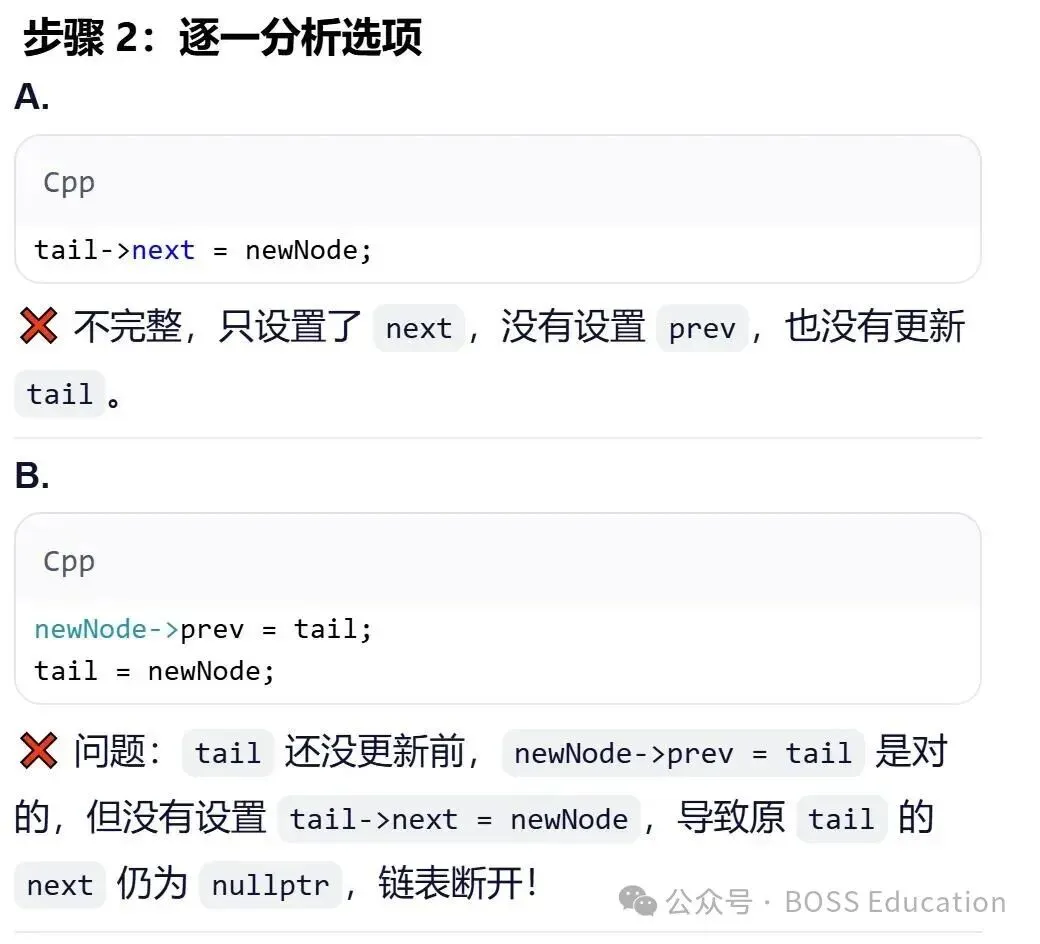
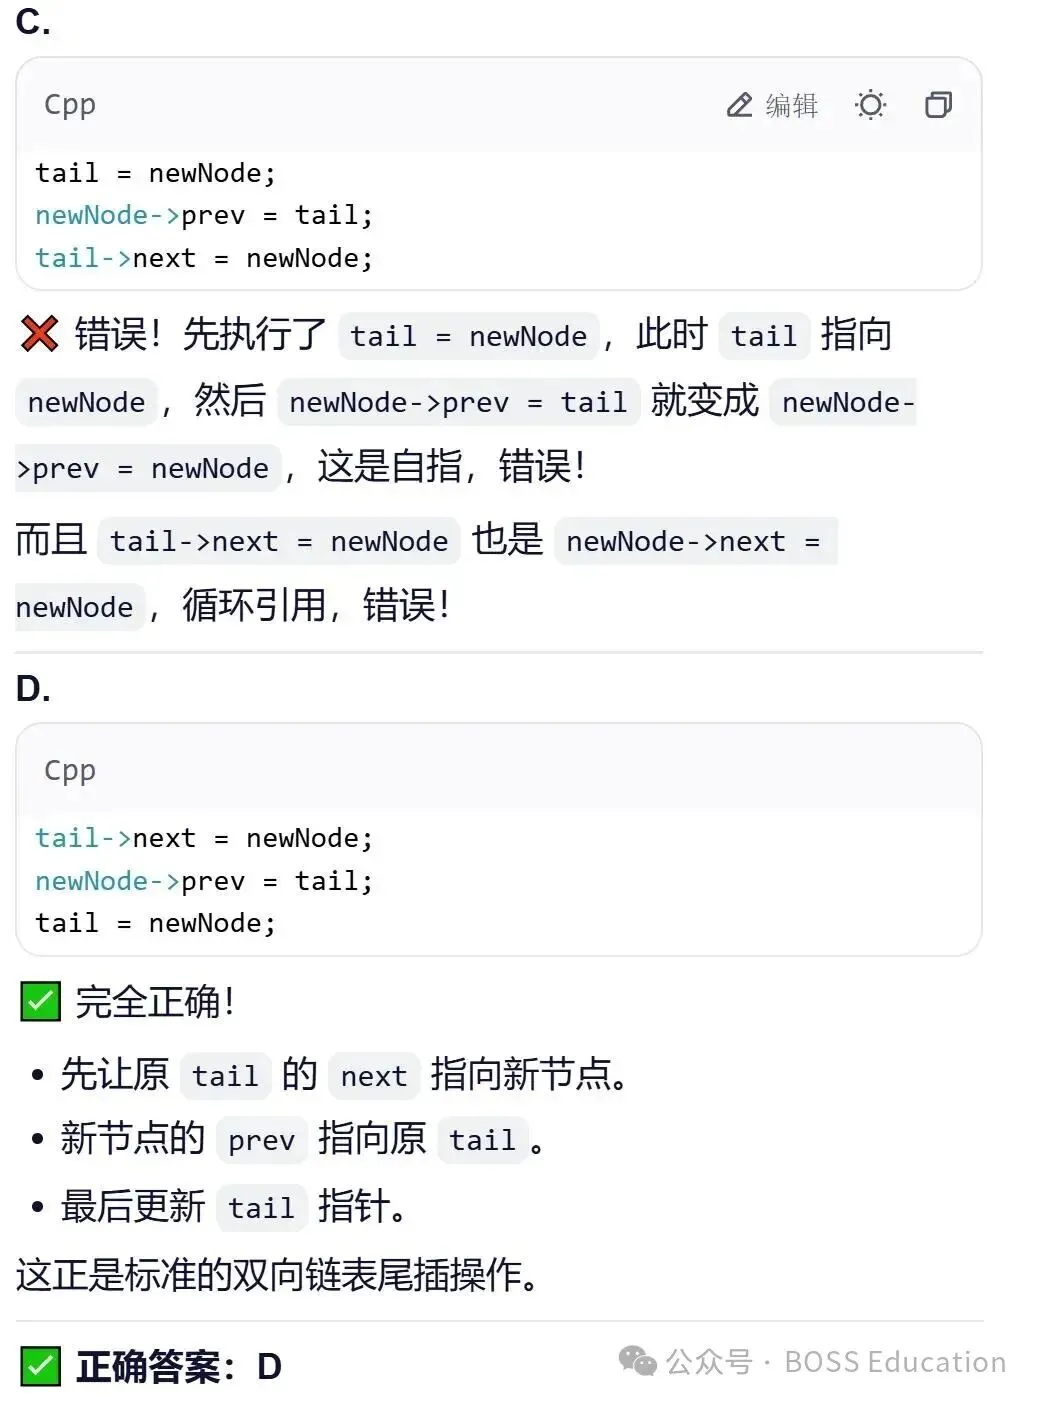
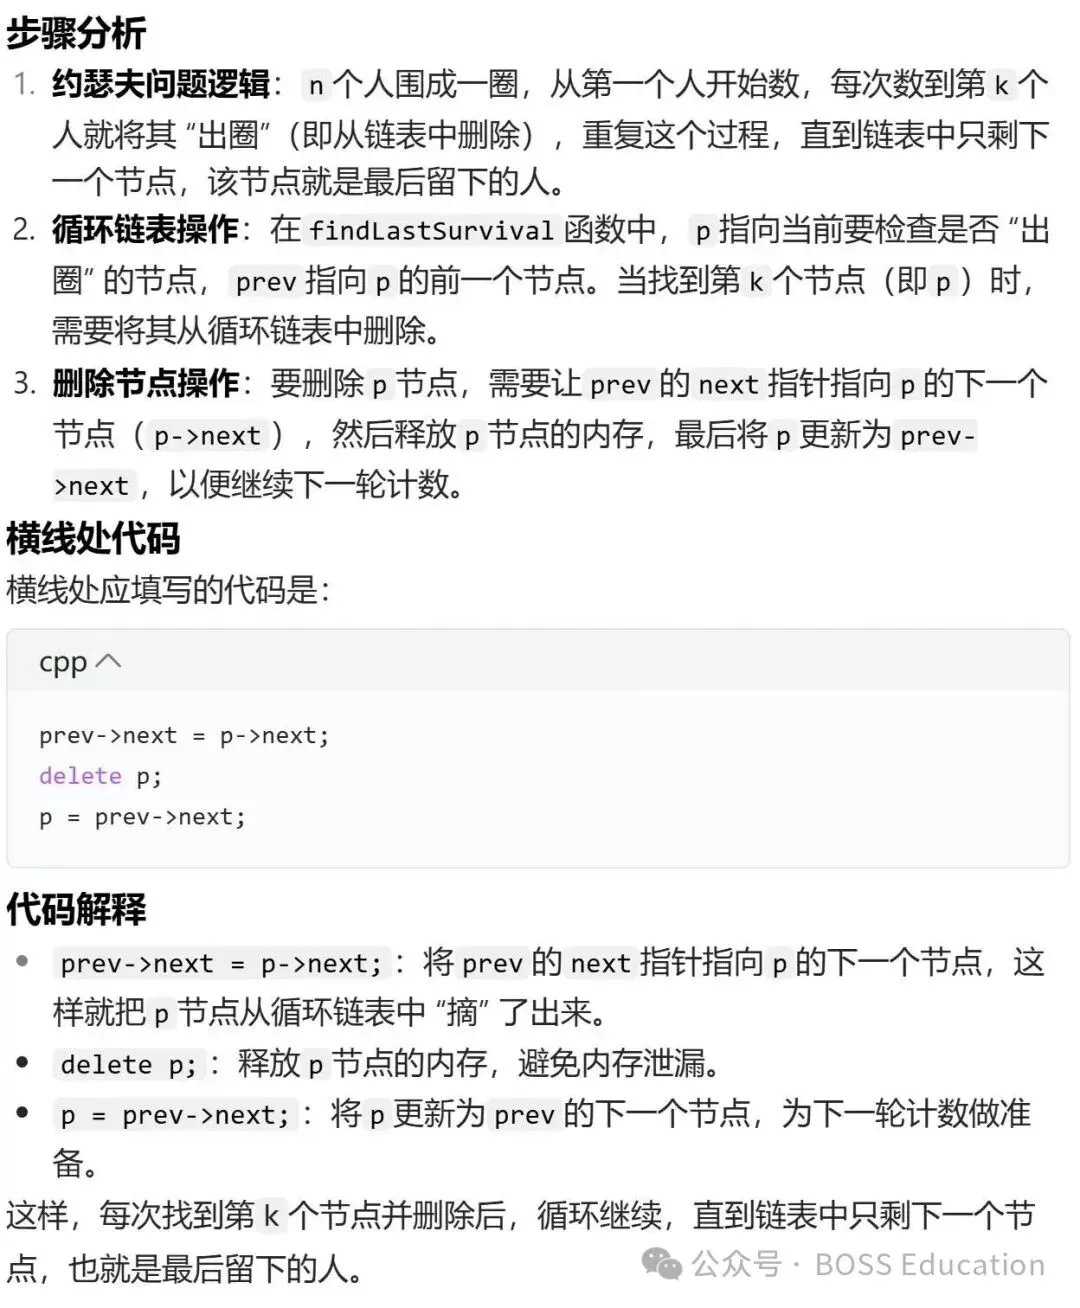
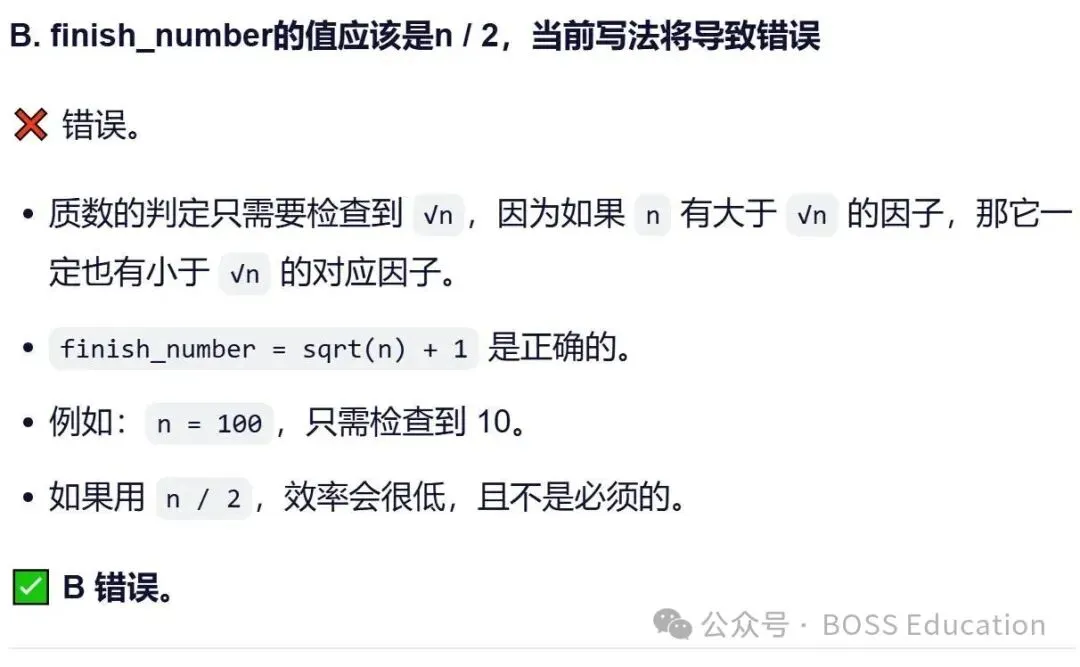
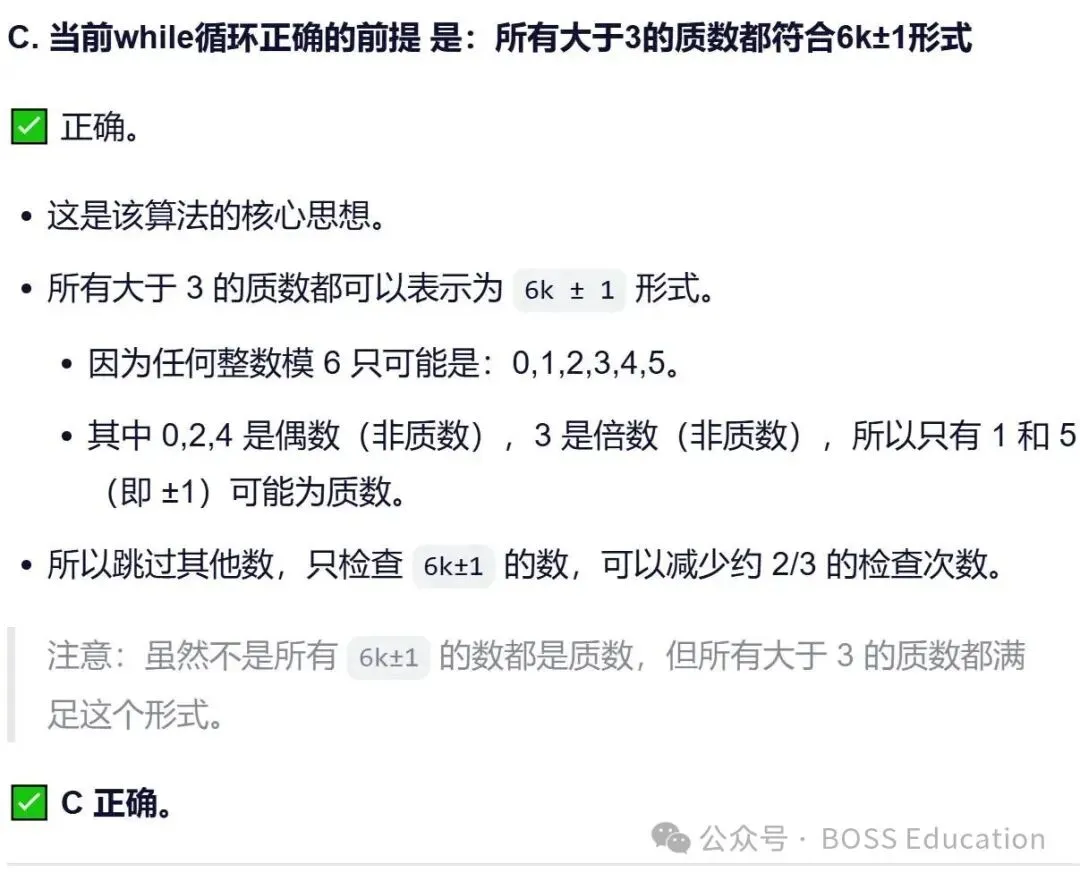
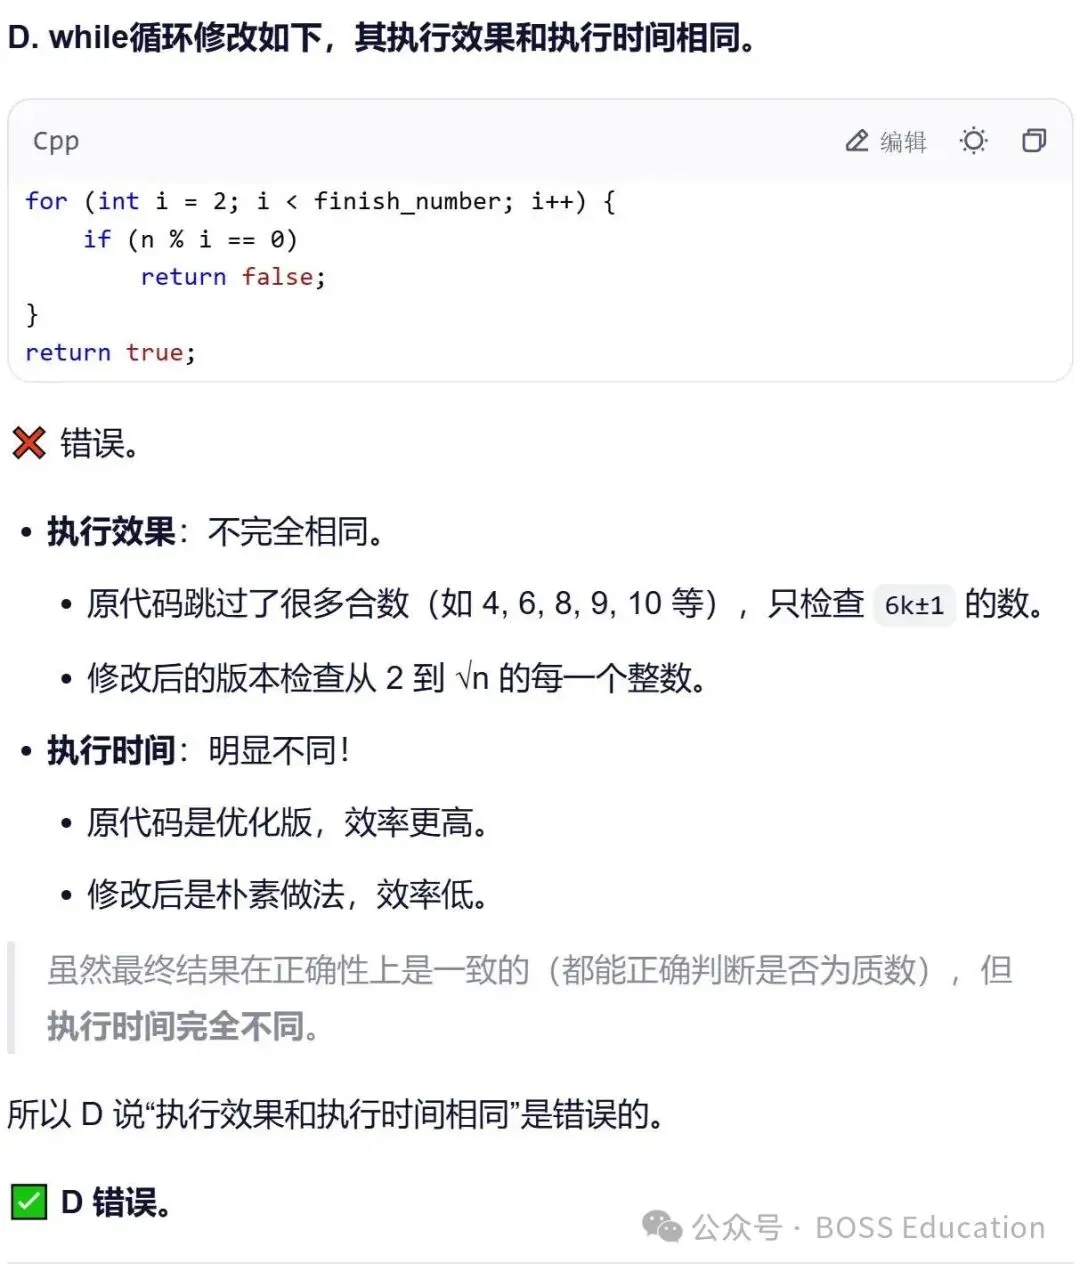
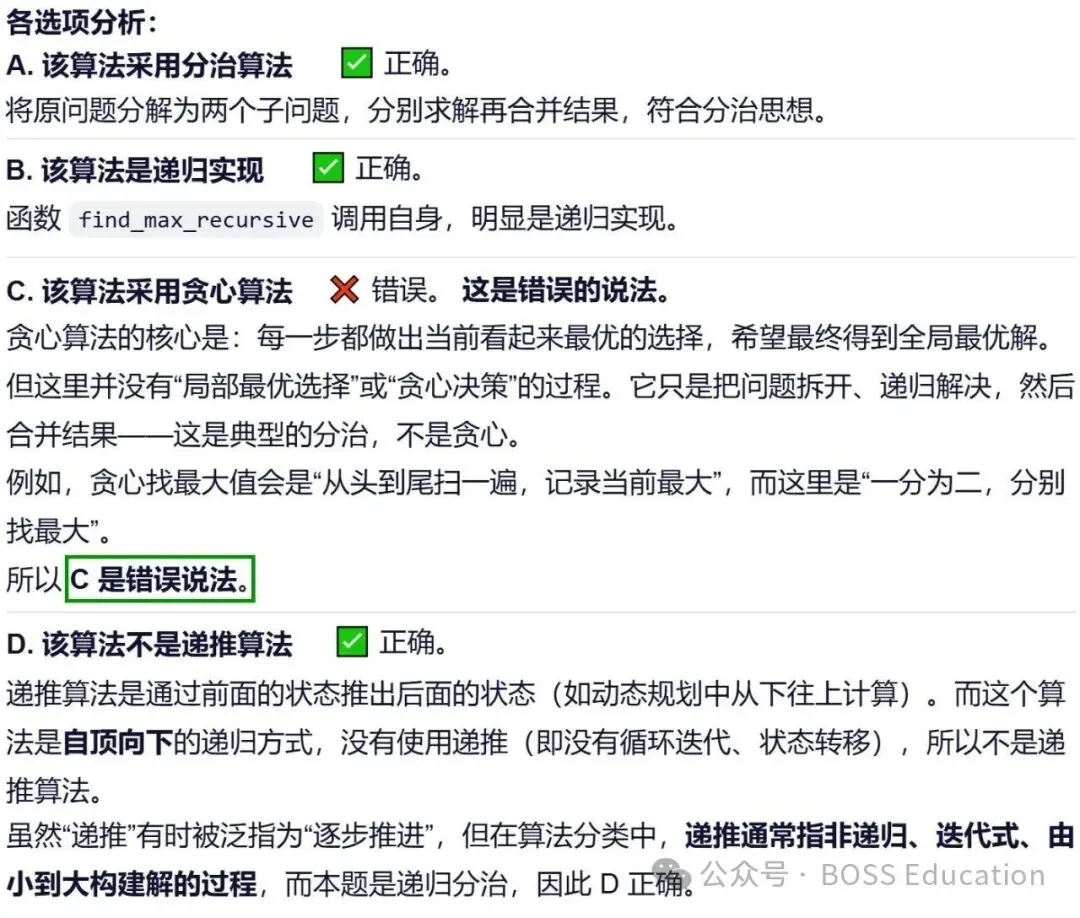
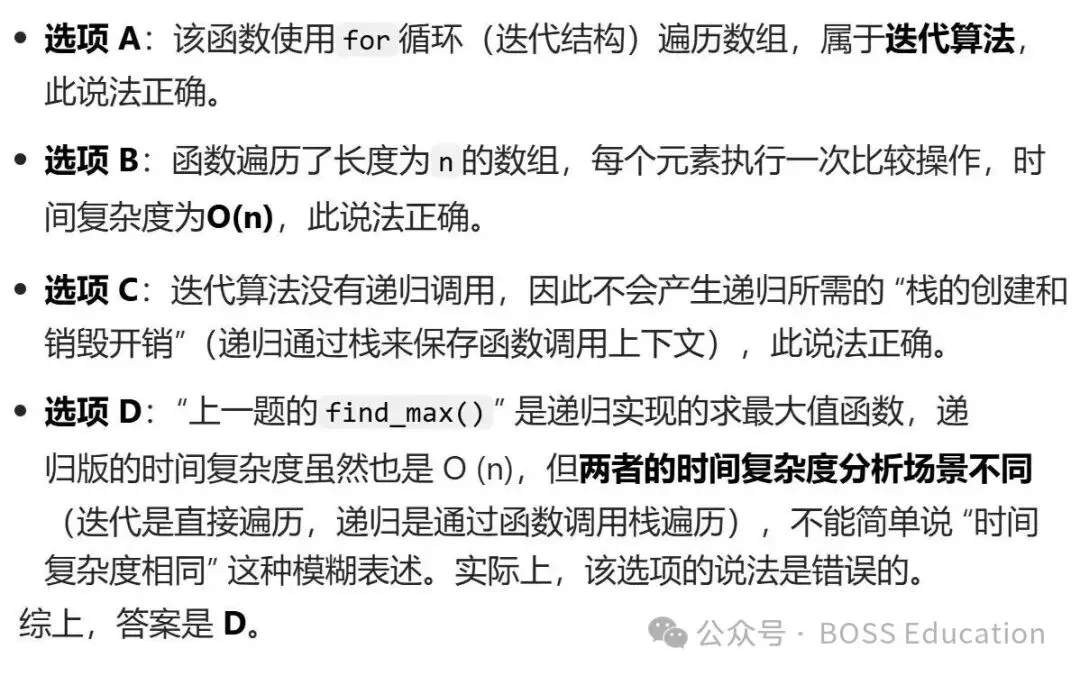
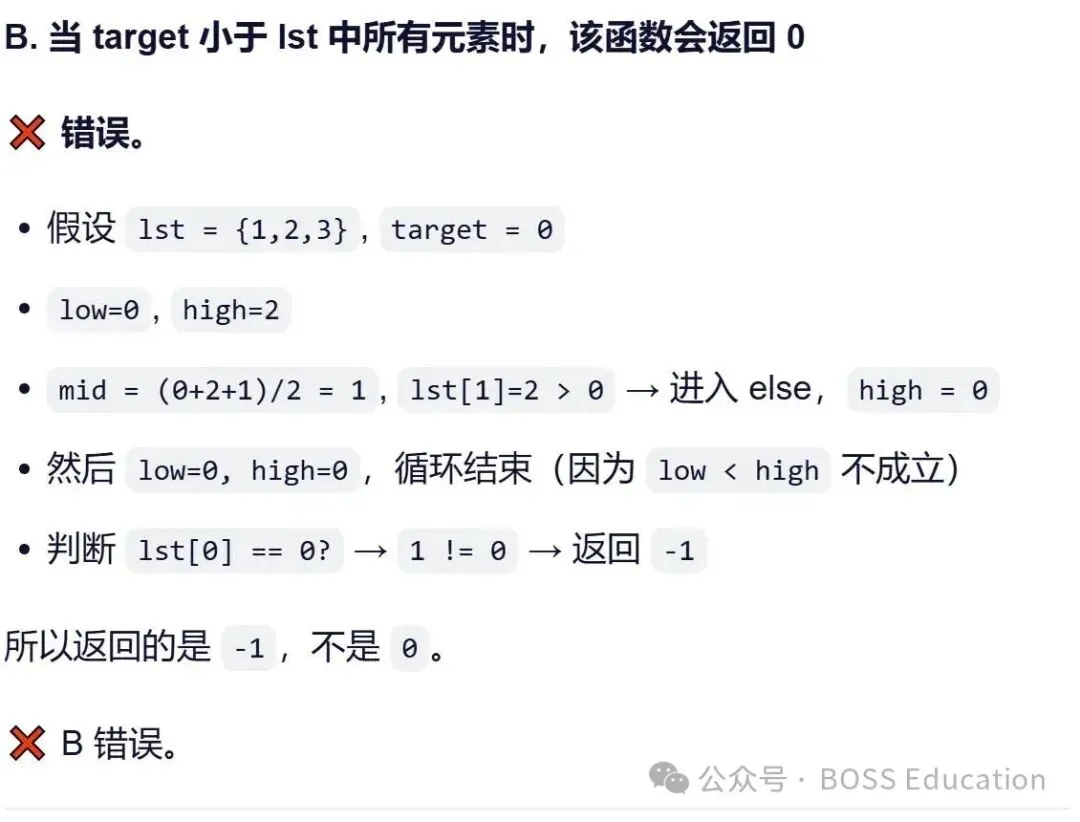
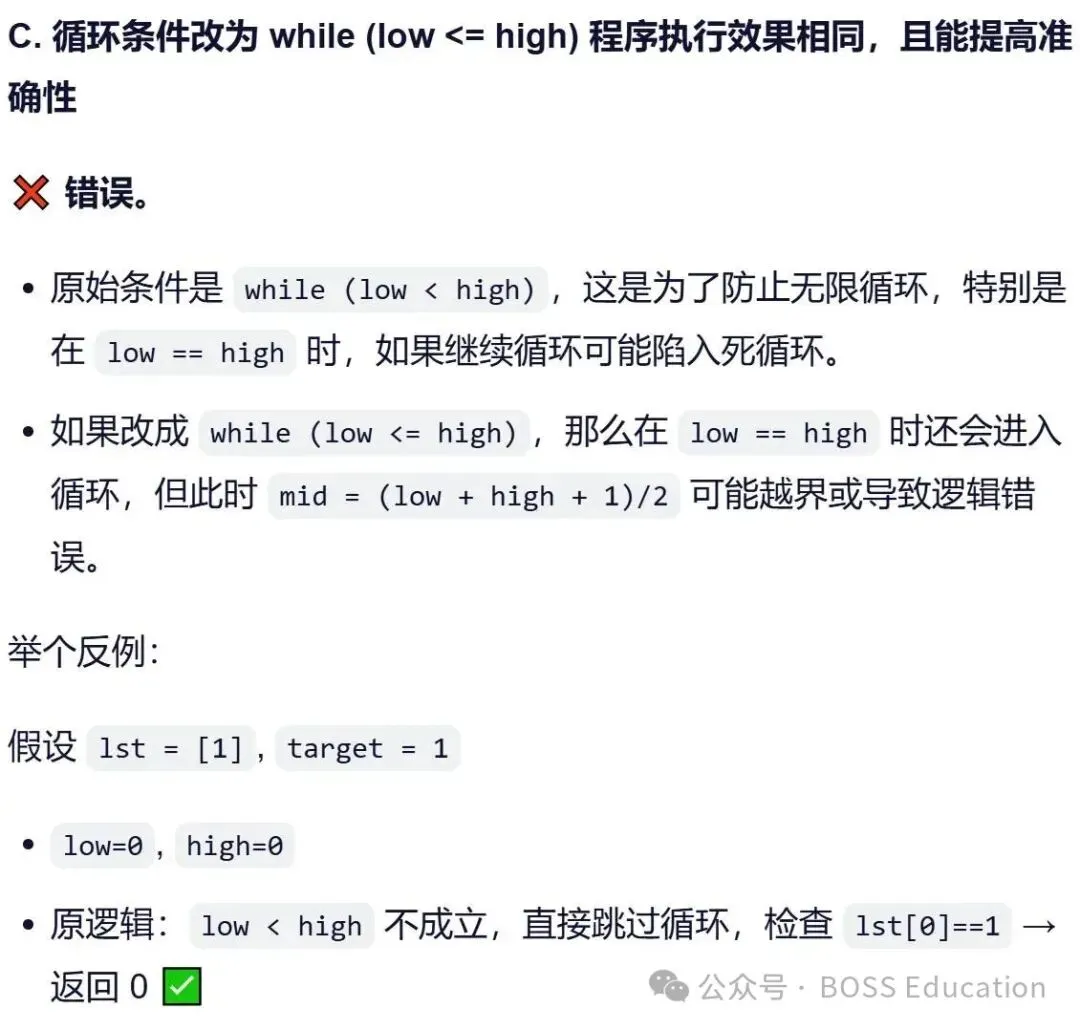
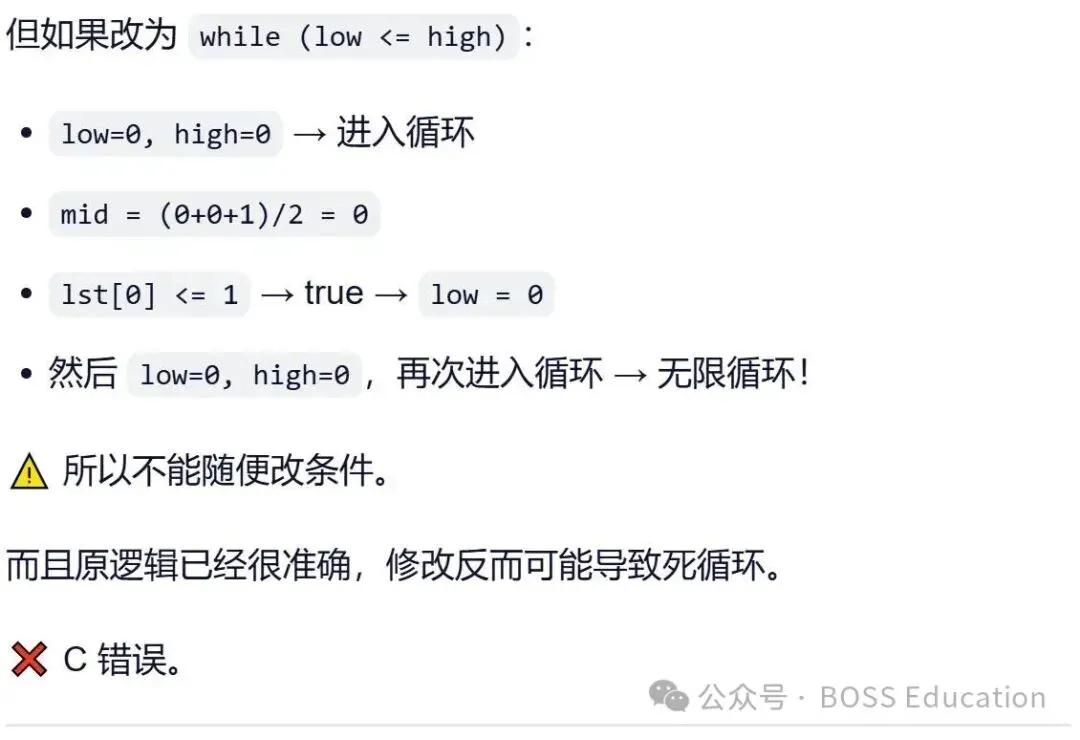
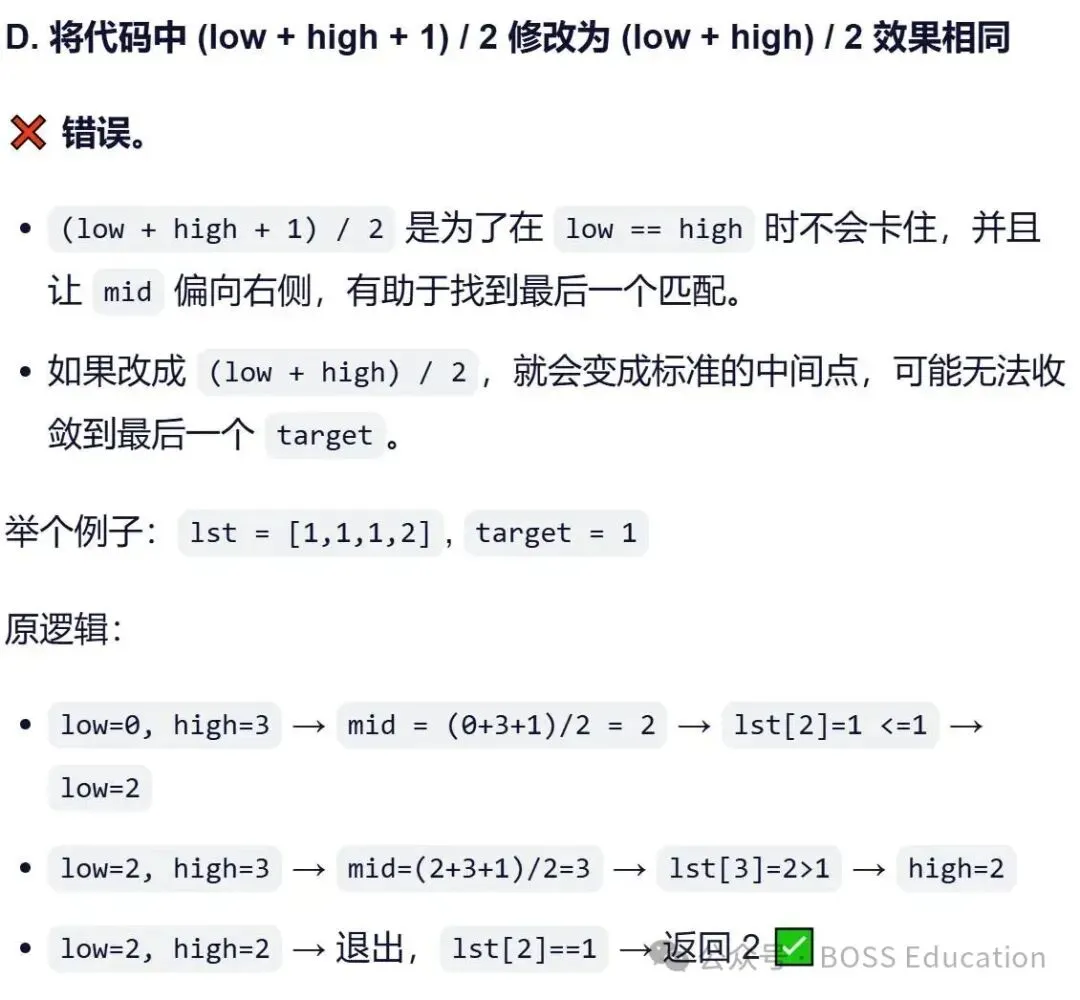
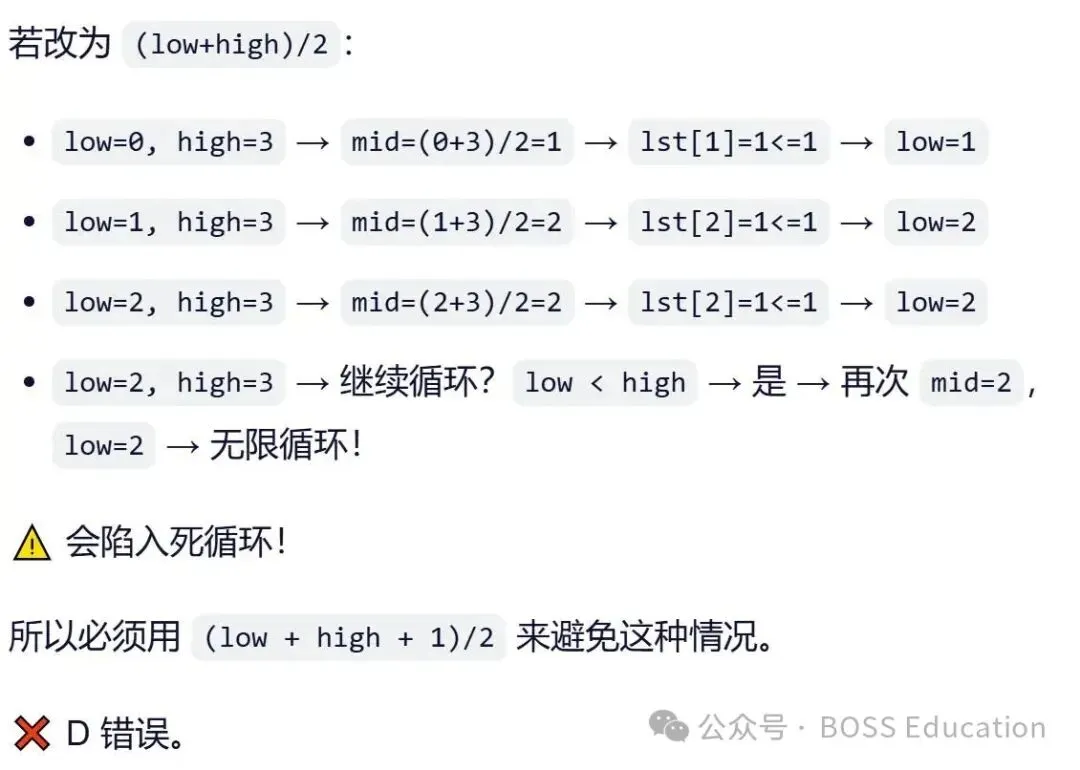
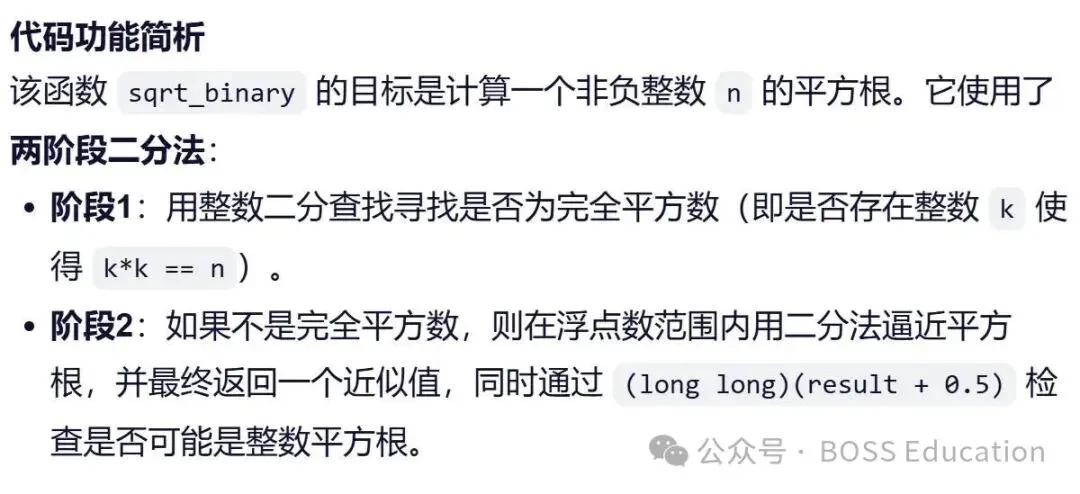
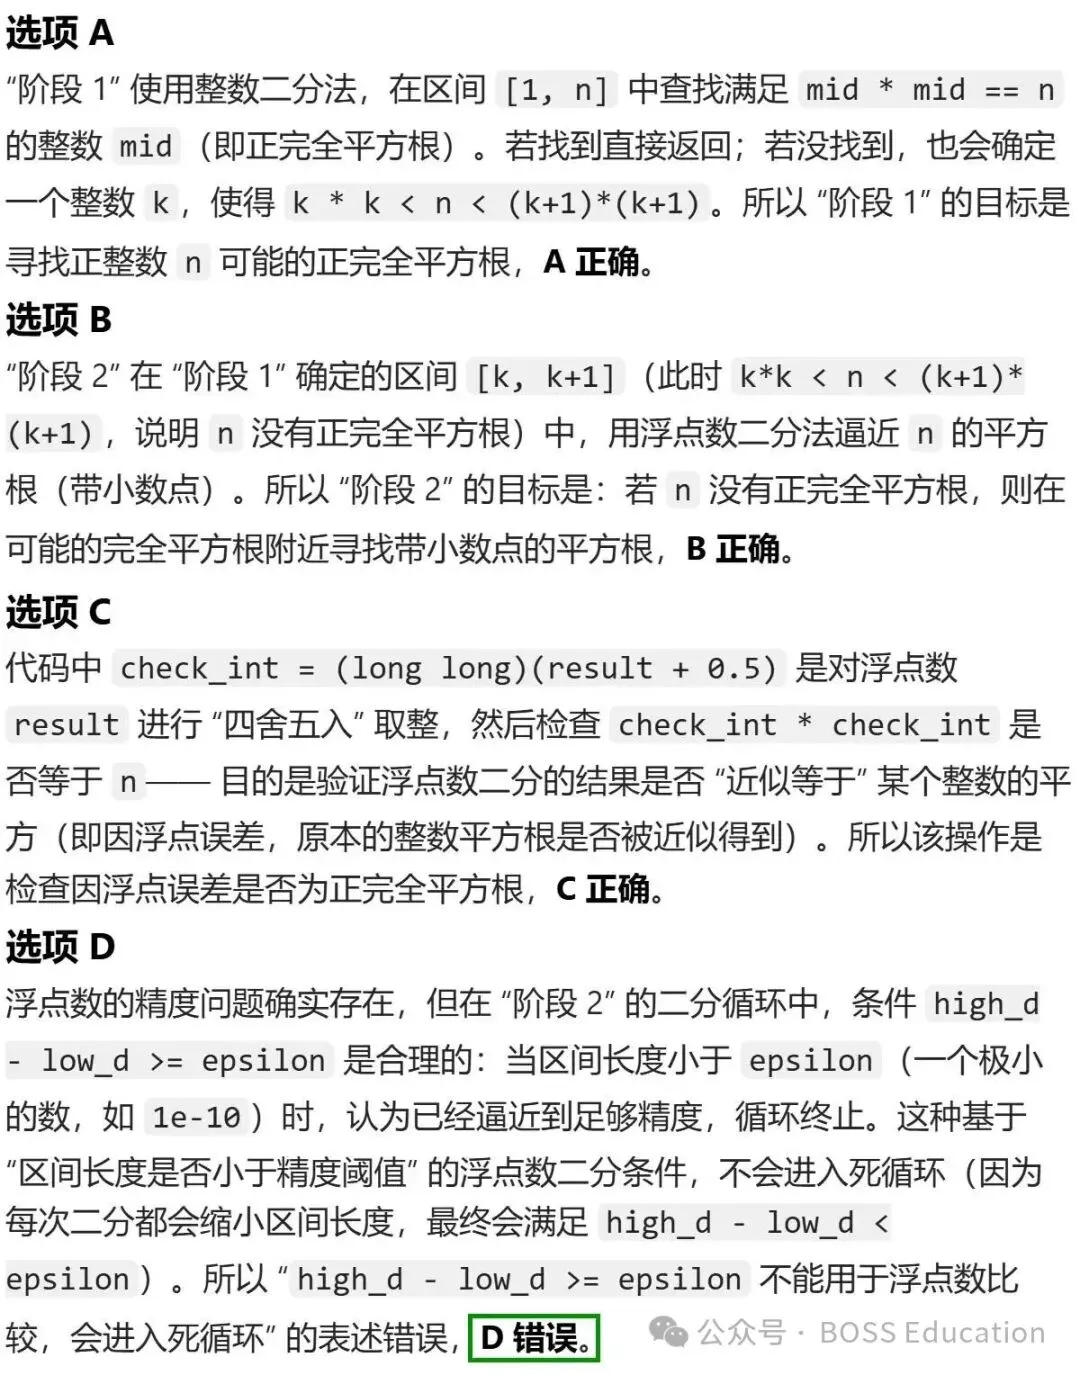
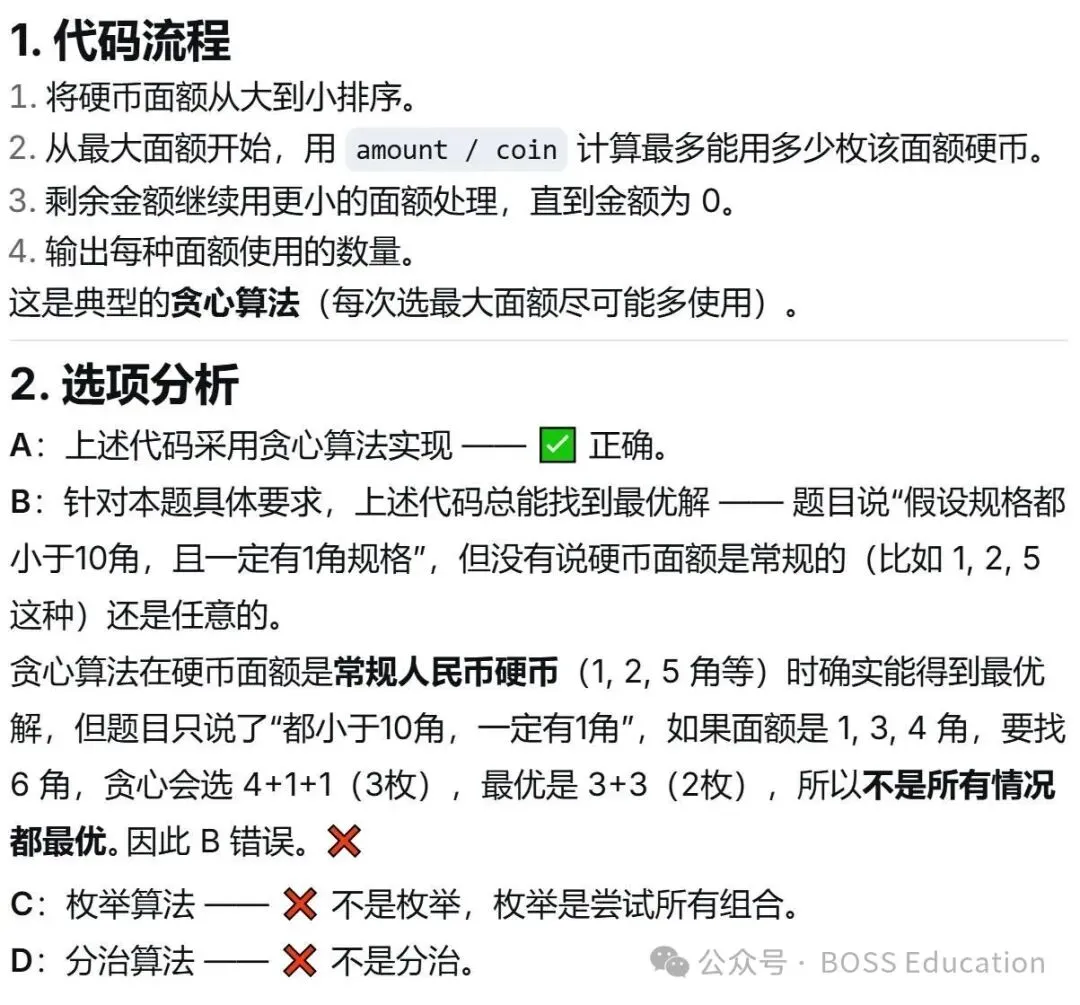
1.解释:答案选C。 链表与数组的特性对比,链表在插入和删除操作上的优势。数组的随机访问效率高(通过索引直接访问),但插入删除需要移动大量元素;链表随机访问效率低(需从头遍历),但在已知位置插入删除只需修改指针,效率更高;遍历和查找效率两者相近。因此,选项C正确。 2.解释:答案选C。 详细解析见下图—— 3.解释:答案选D。 详细解析见下图——
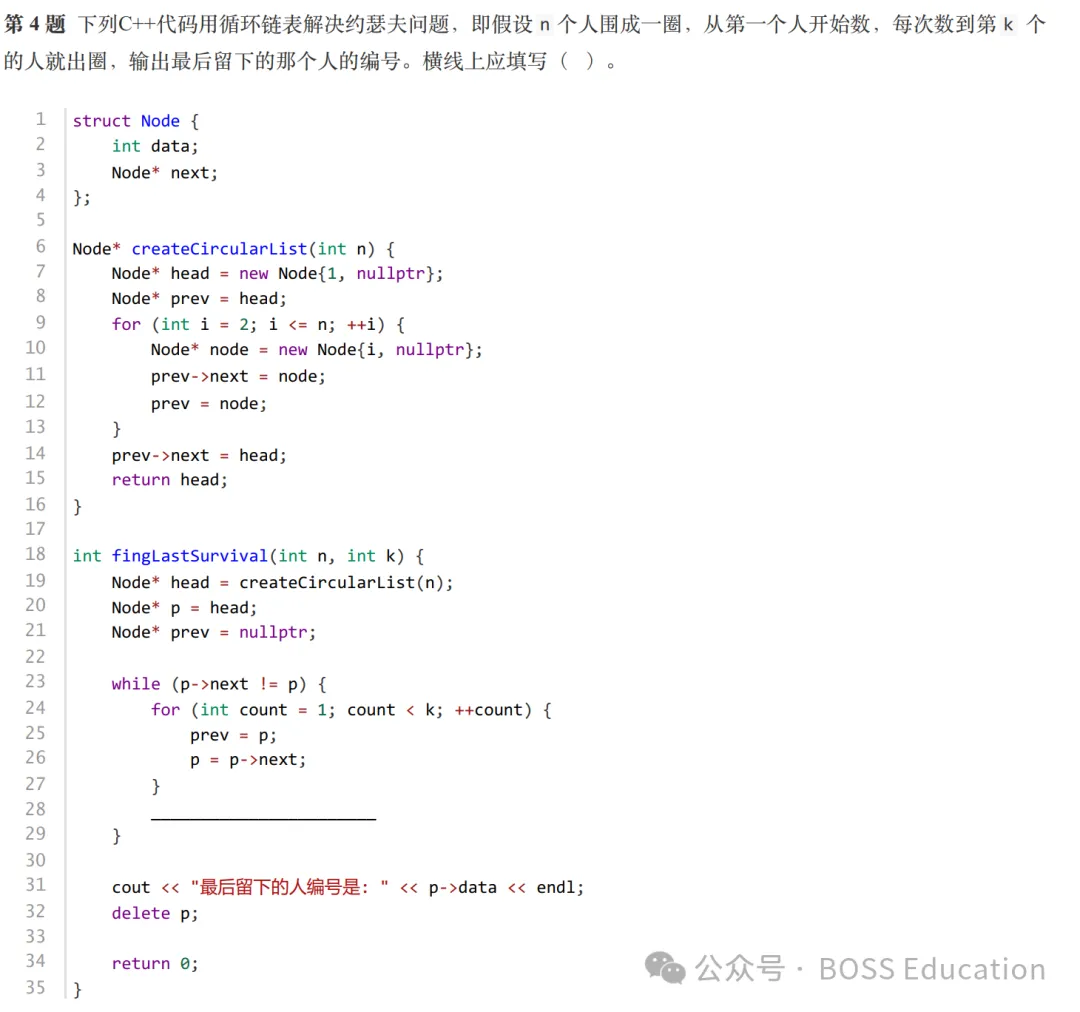
4.解释:答案选A。
详细解析见下图——
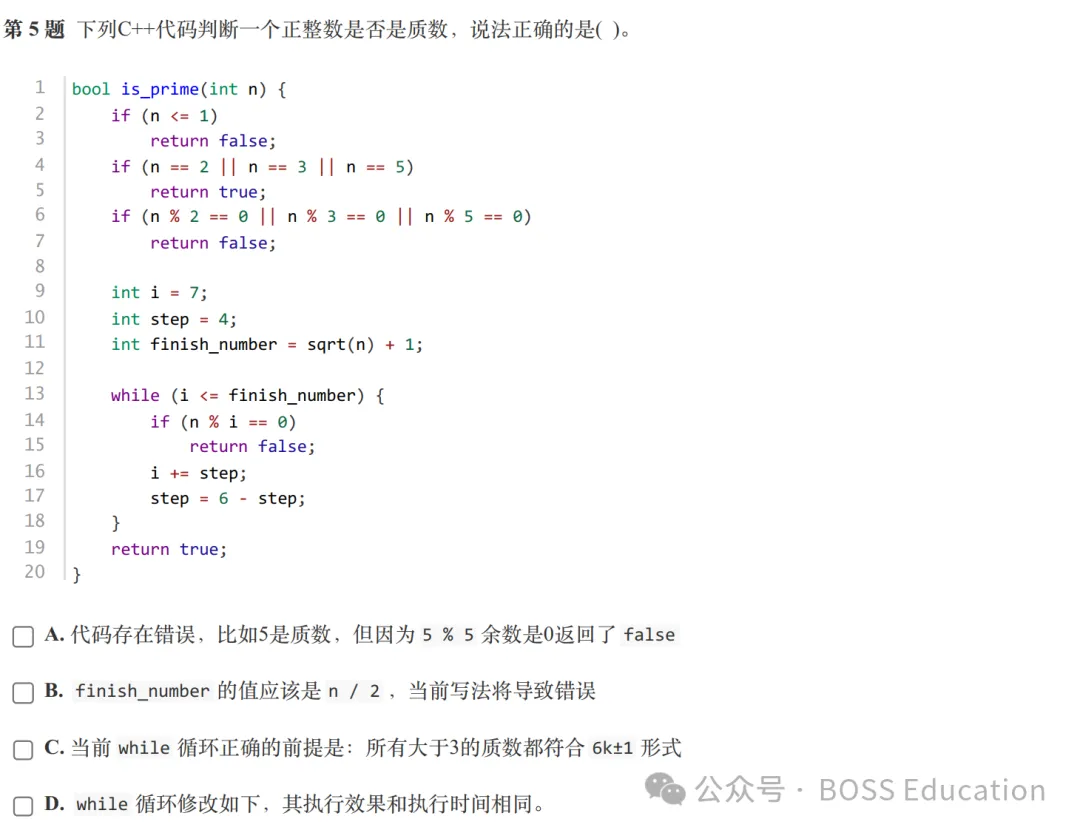
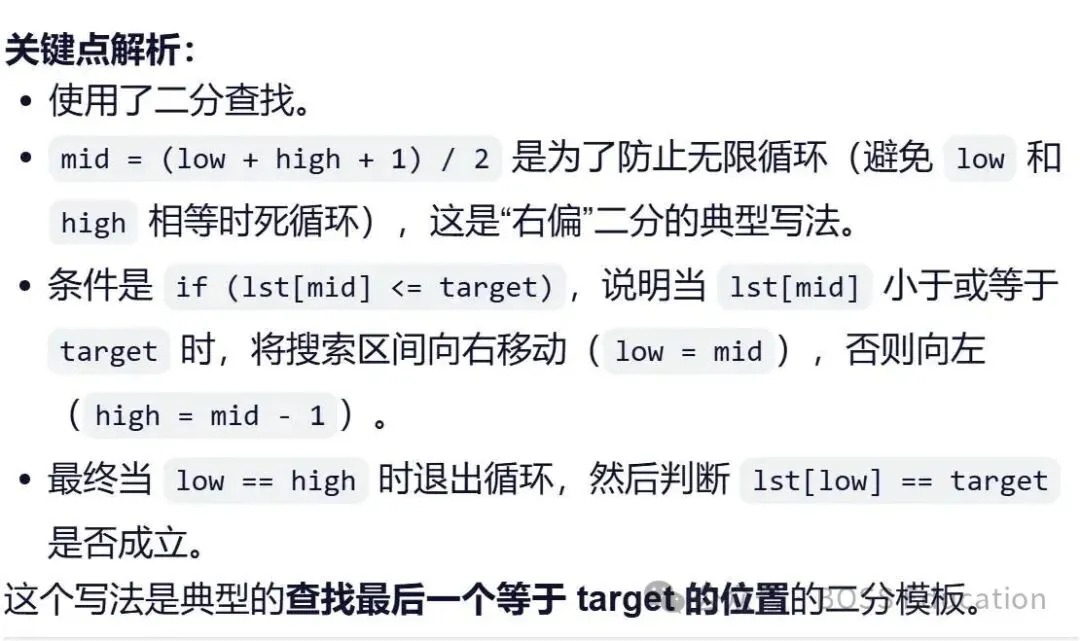
5.解释:答案选C。 详细解析见下图——
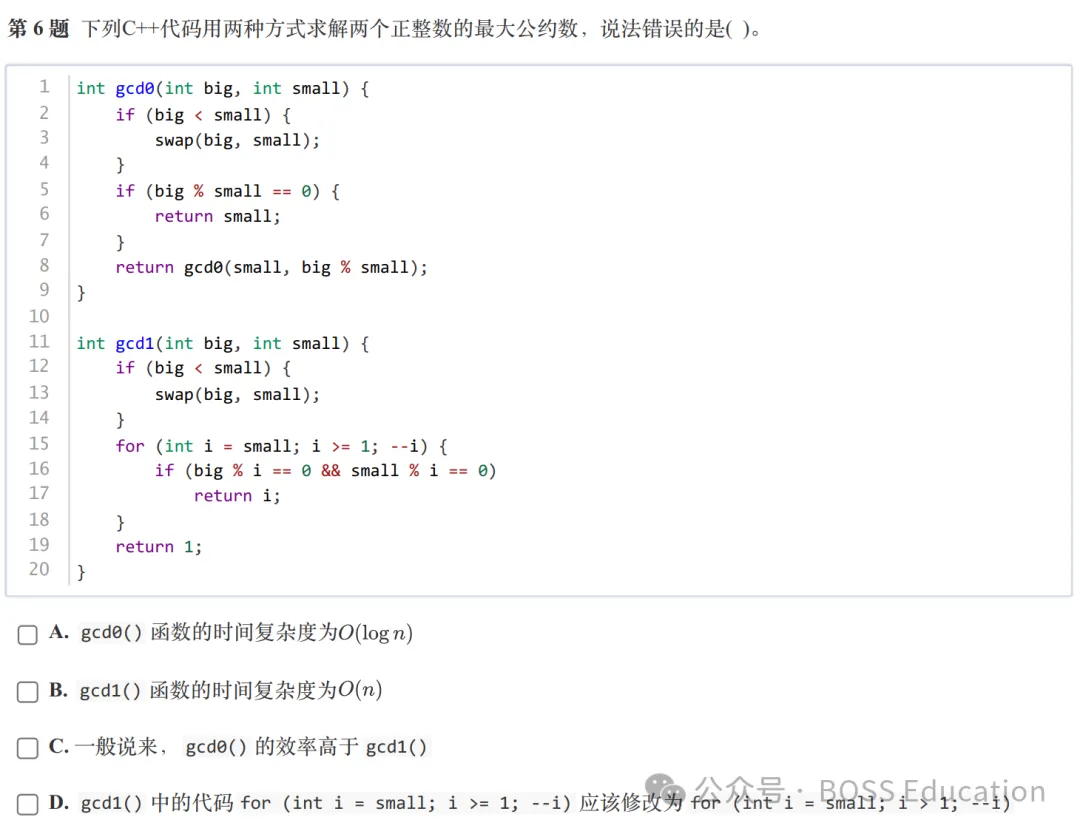
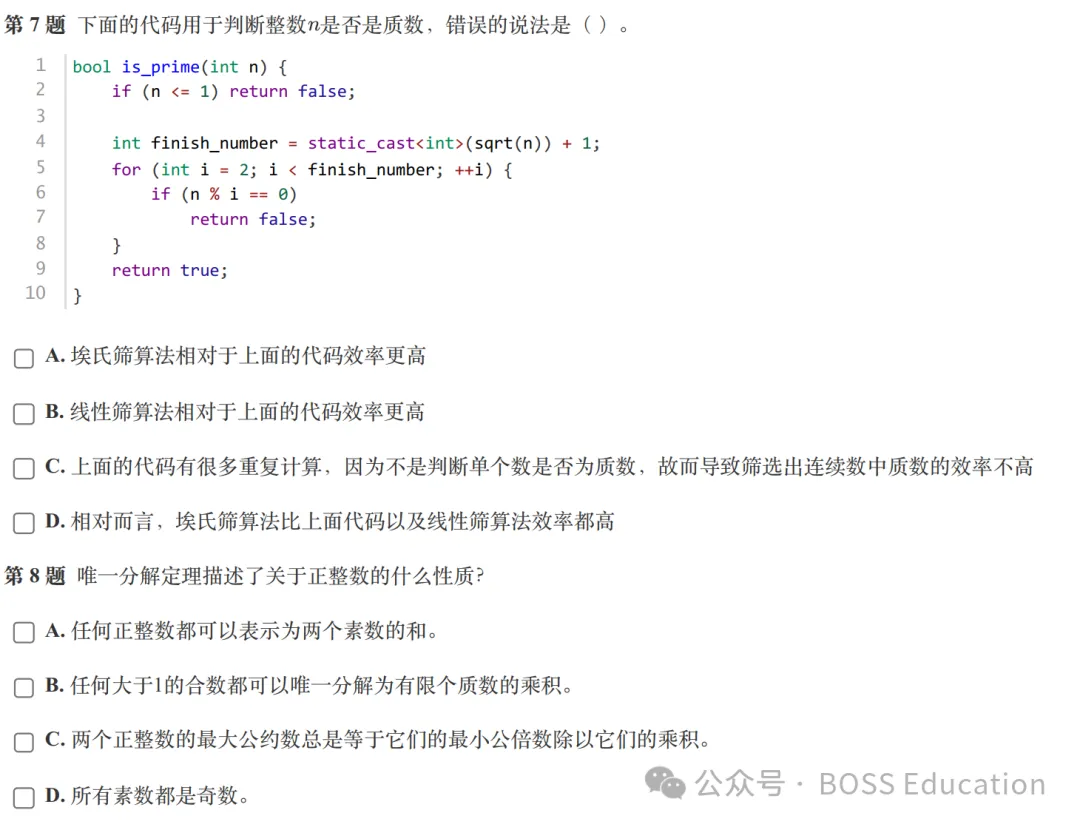
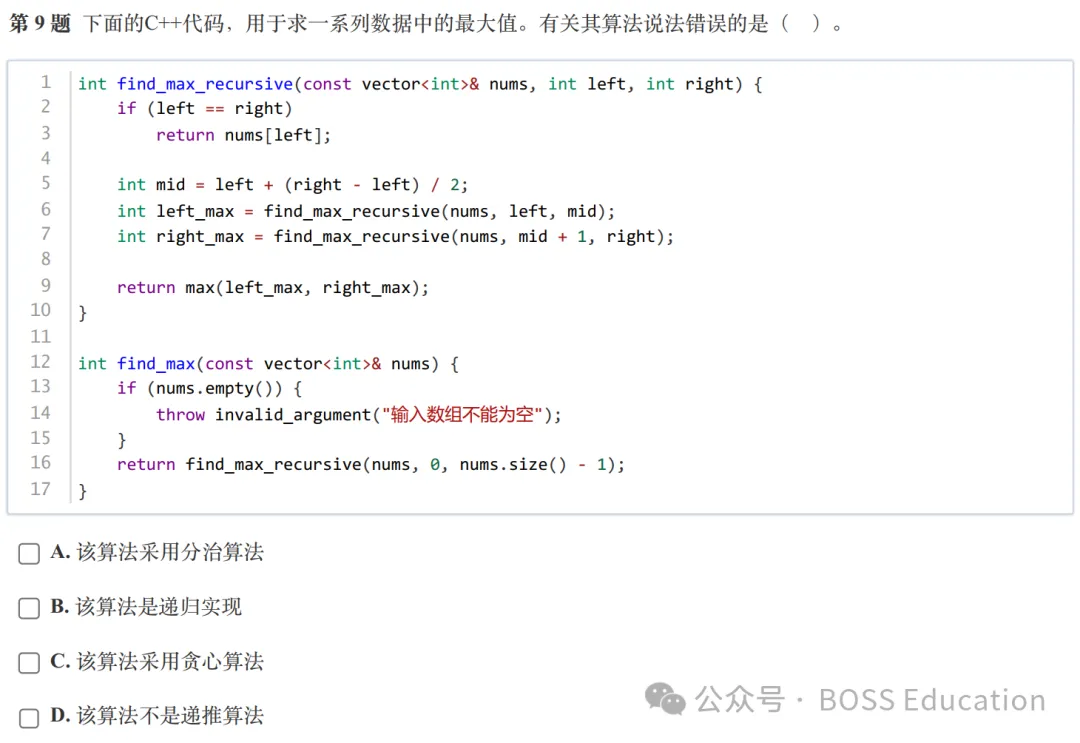
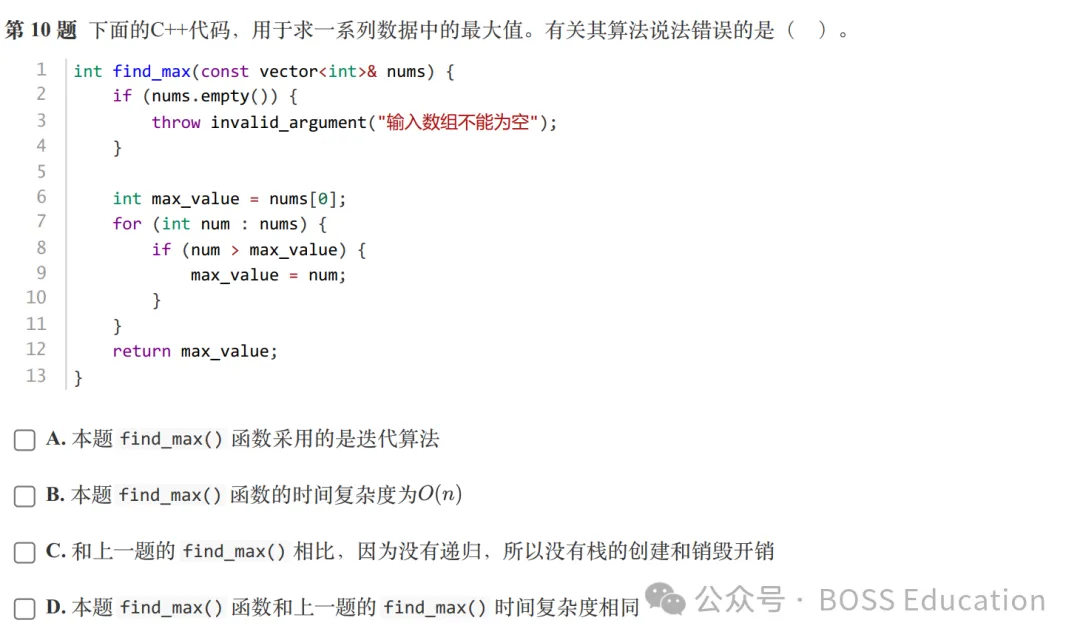
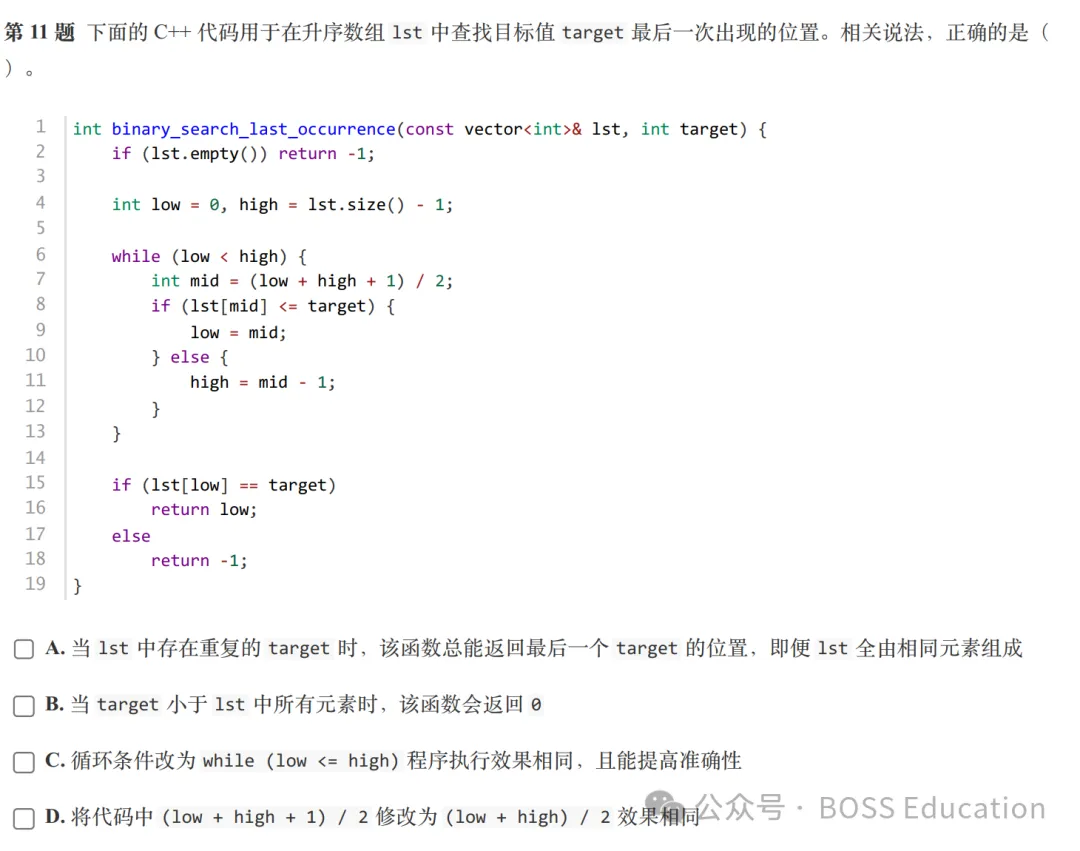
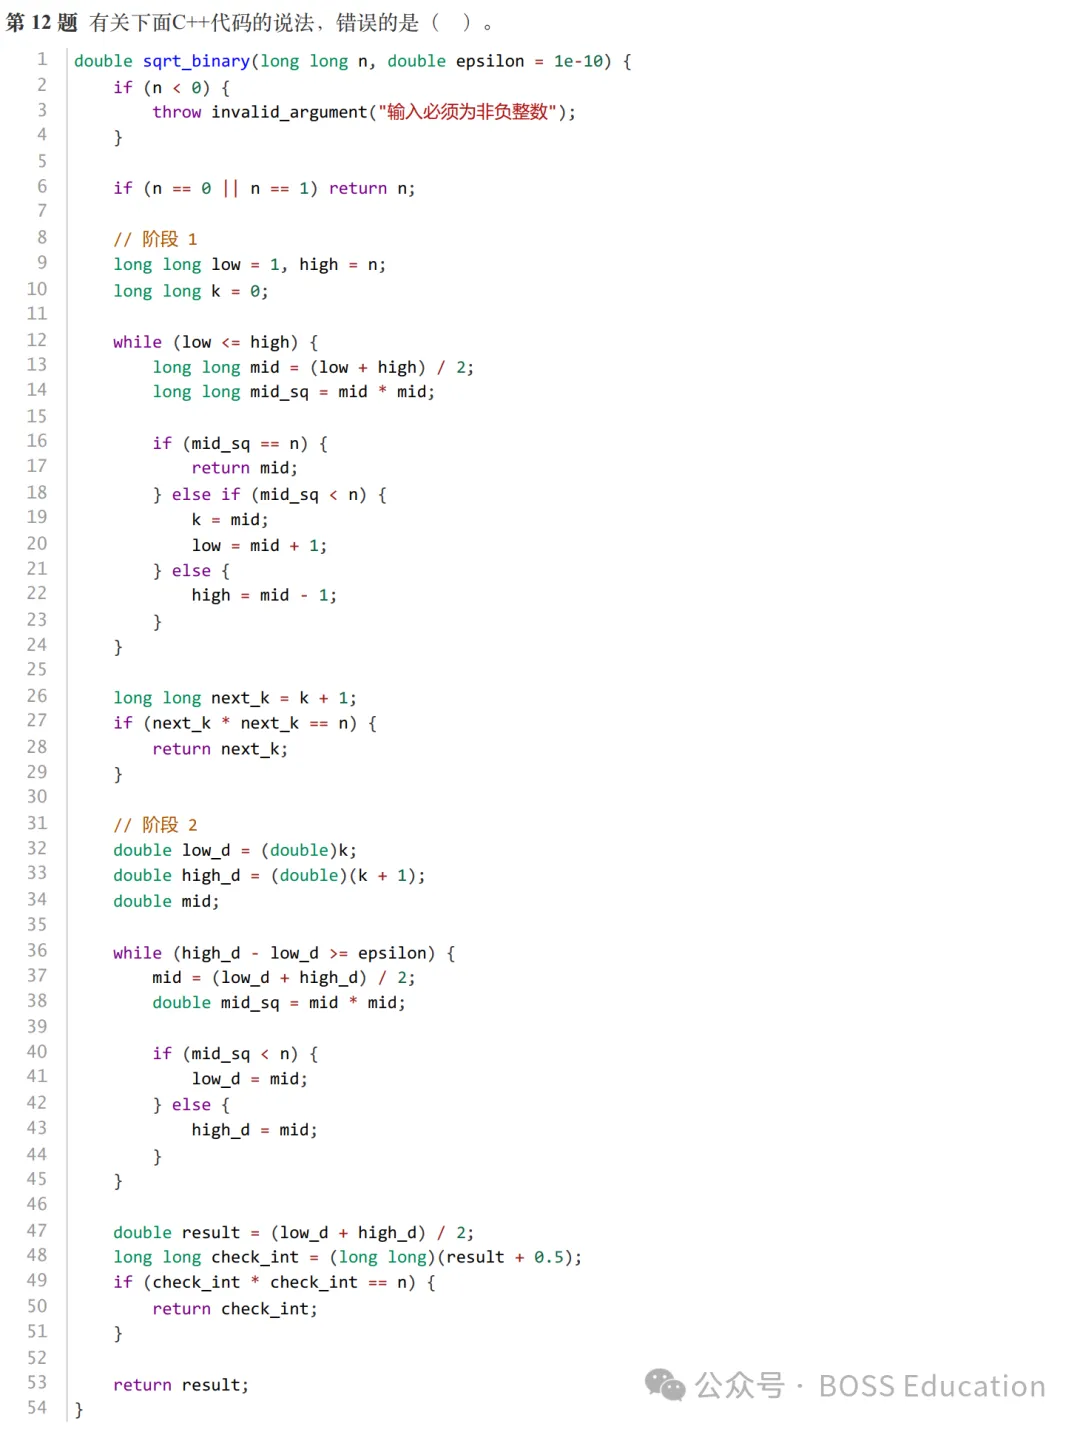
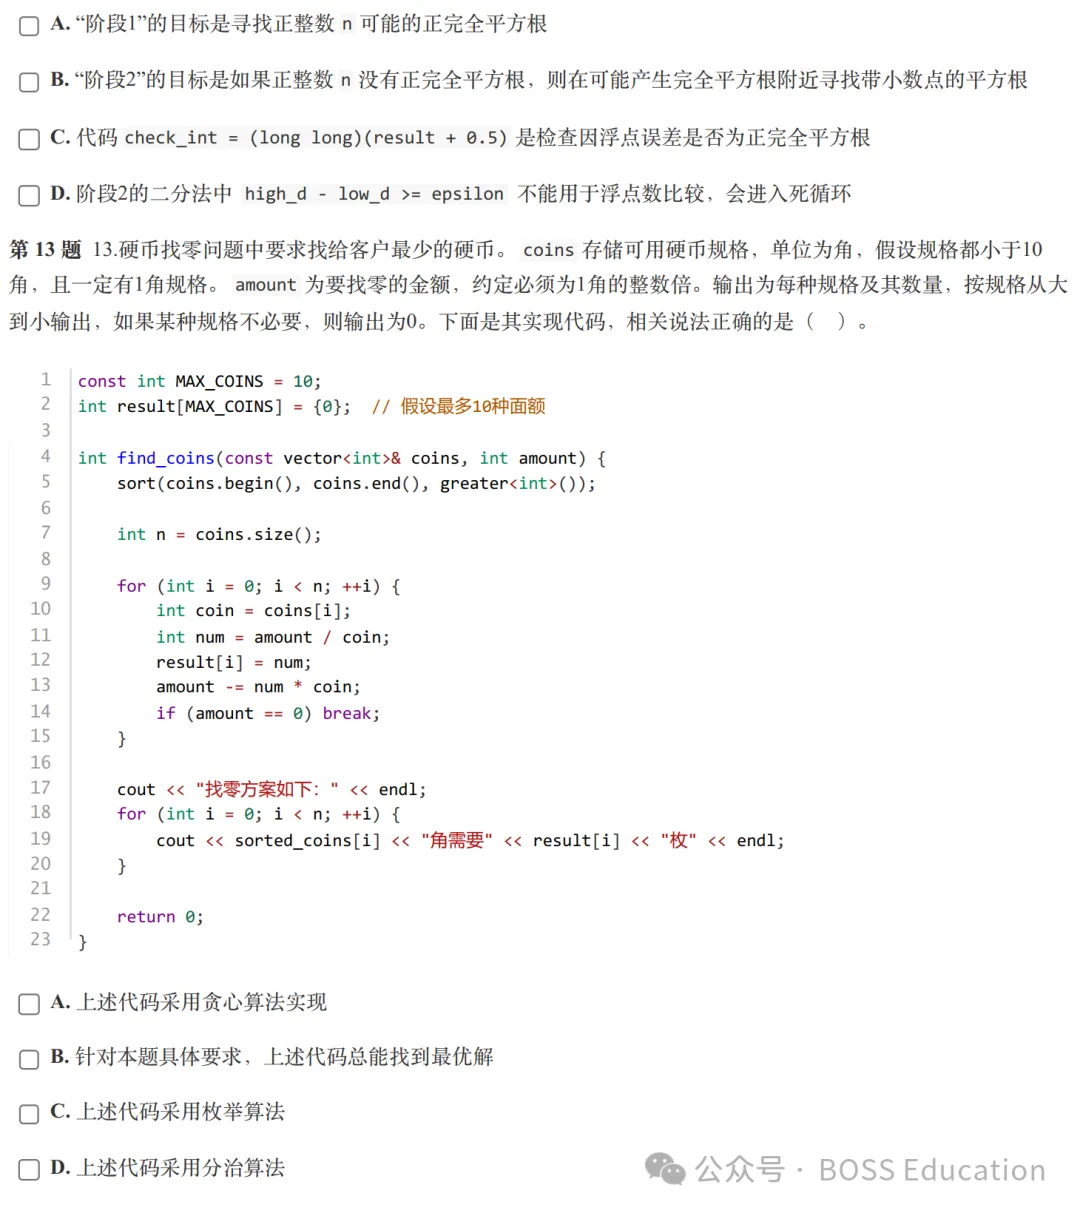
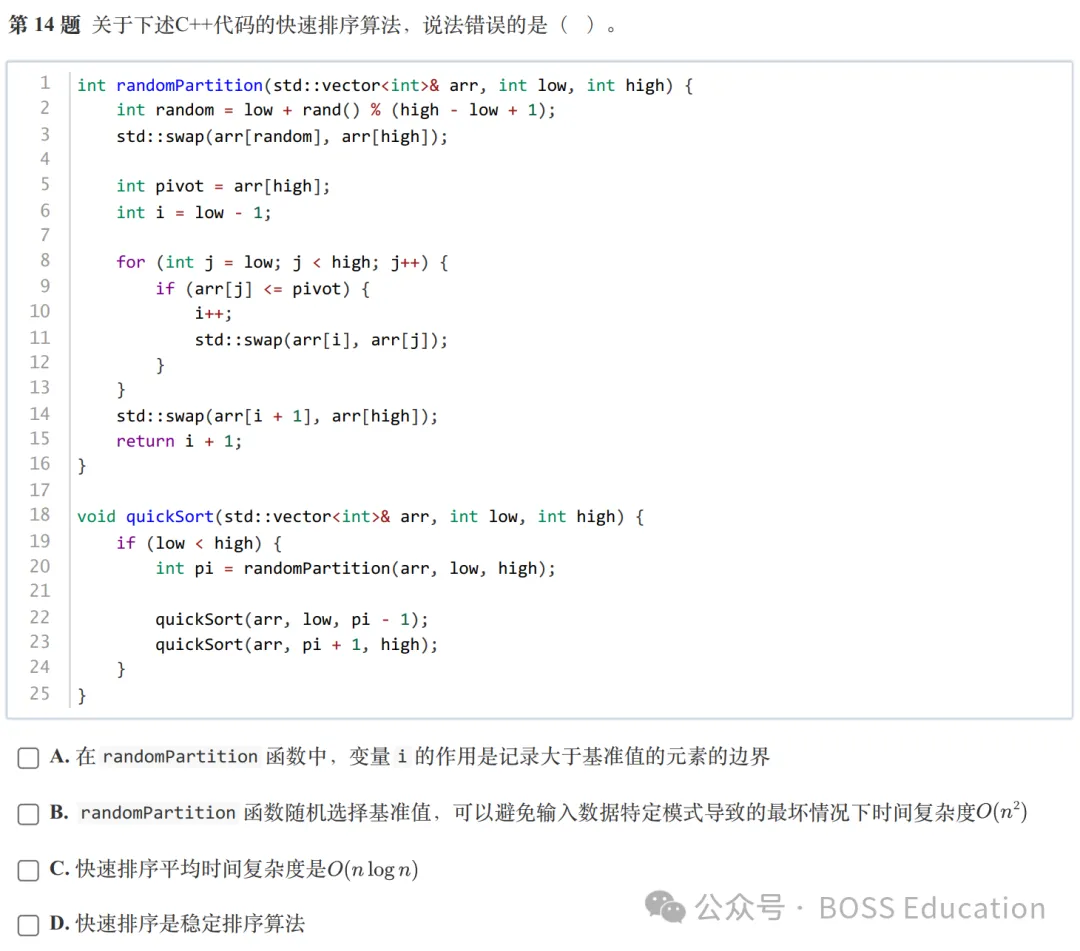
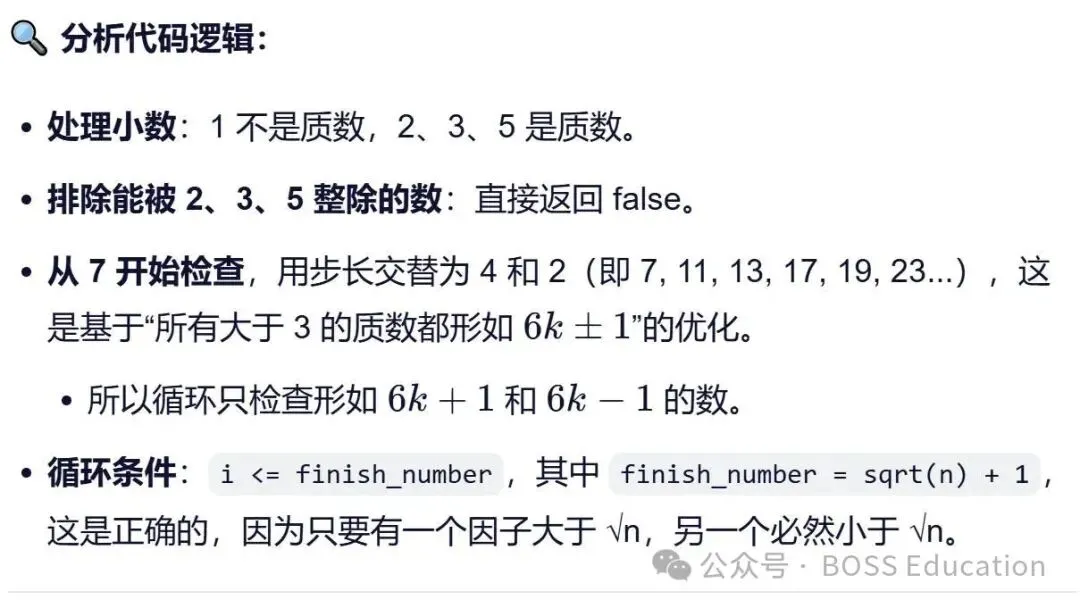
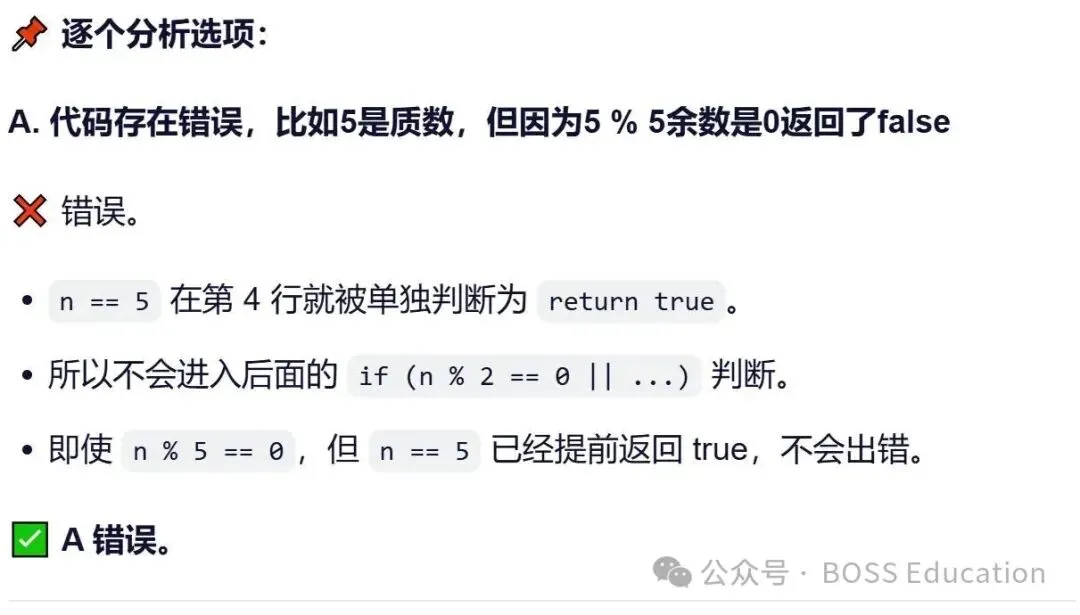
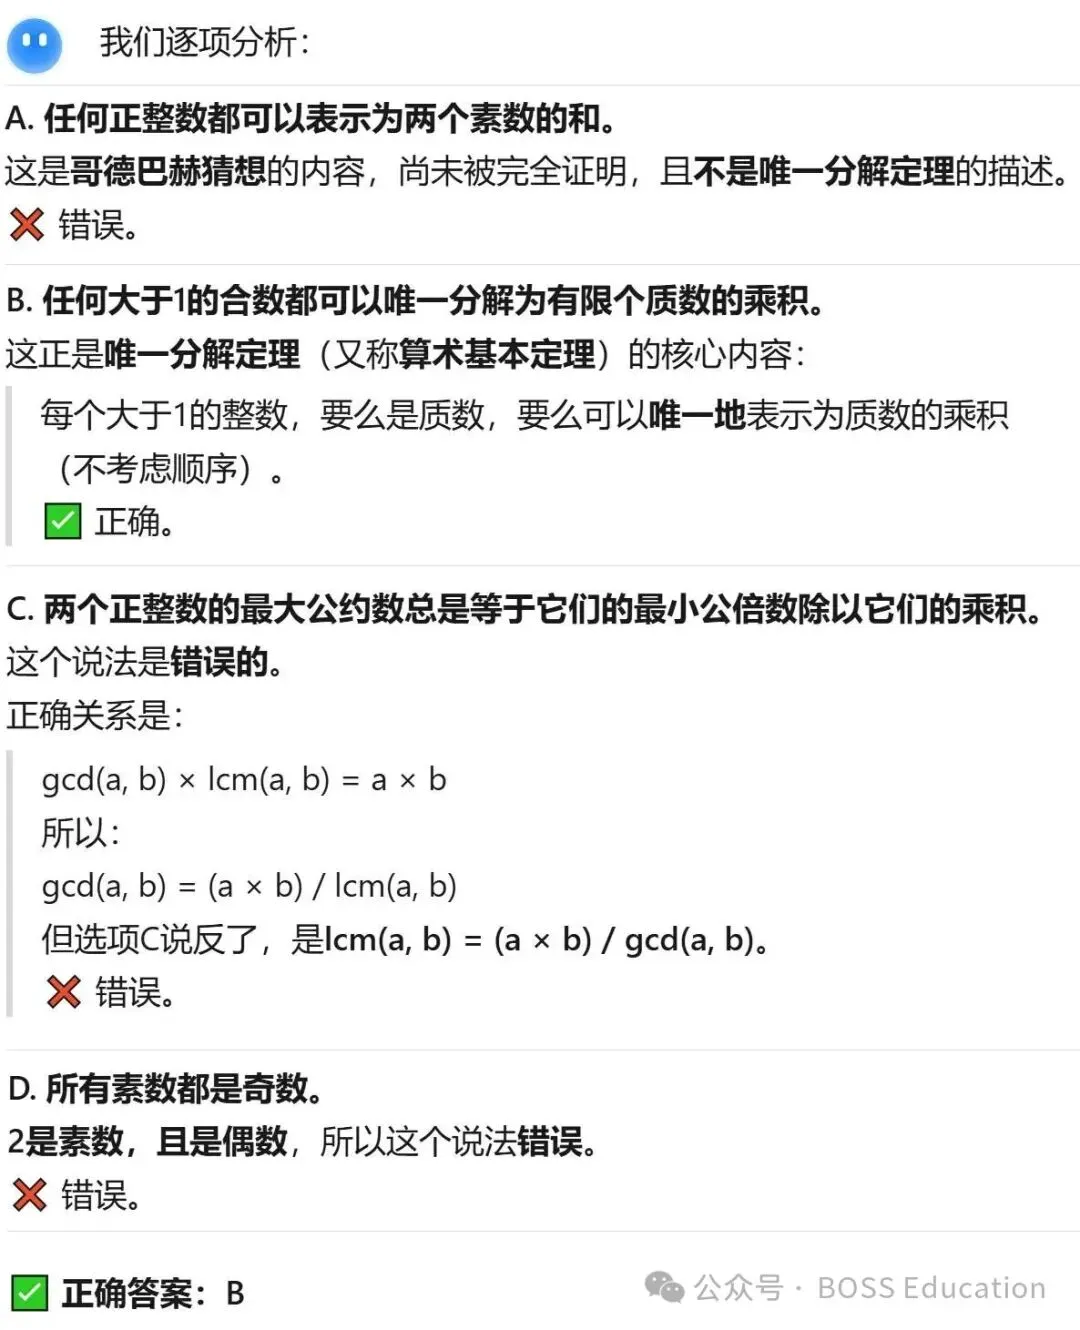
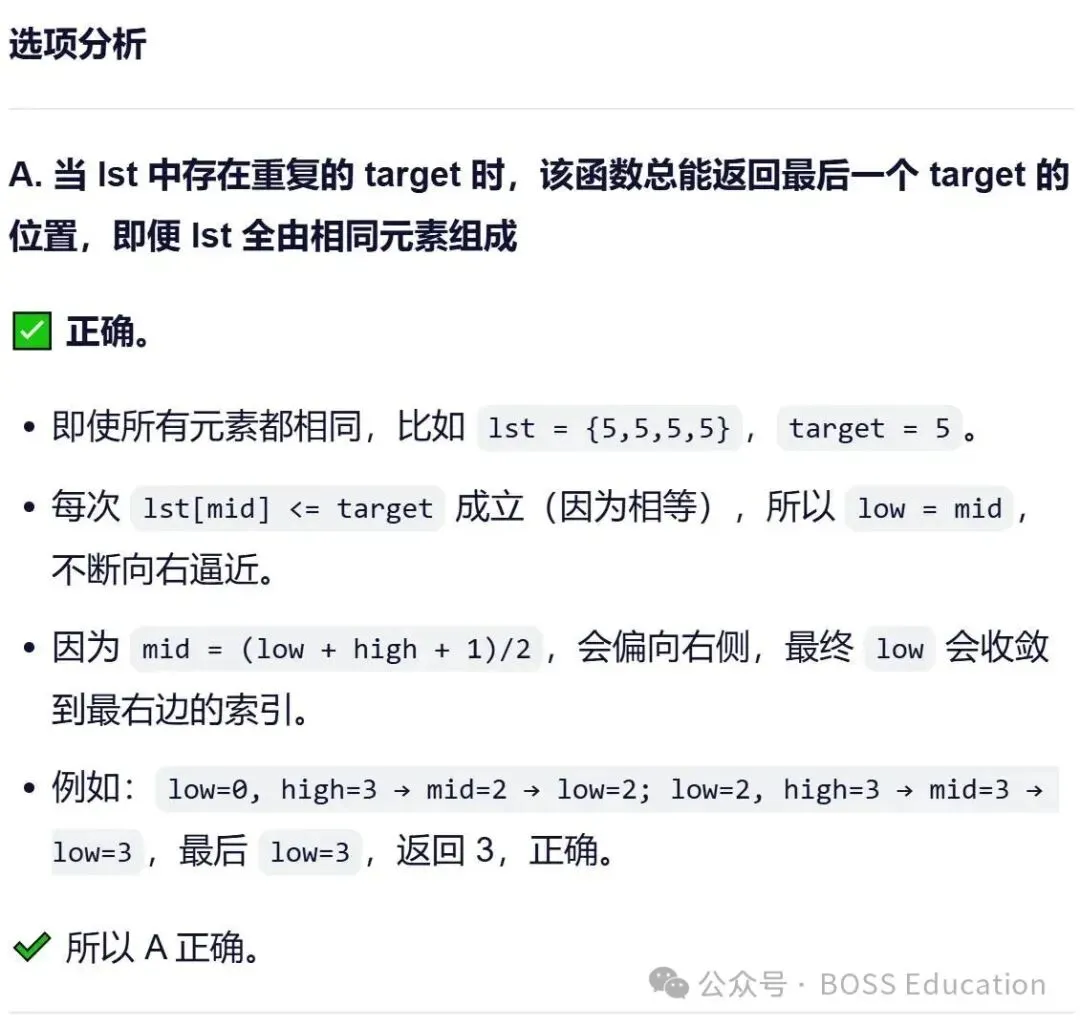
6.解释:答案选D。 详细解析见下图—— 7.解释:答案选D。 详细解析见下图—— 8.解释:答案选B。 详细解析见下图—— 9.解释:答案选C。 详细解析见下图—— 10.解释:答案选D。 详细解析见下图—— 11.解释:答案选A。 详细解析见下图—— 12.解释:答案选D。 详细解析见下图—— 13.解释:答案选A。 详细解析见下图—— 14.解释:答案选D。 本题的官方答案选D,但有待商榷。
首先看标准答案,选项D。快速排序(QuickSort)不是一种稳定的排序算法。在快速排序中,相等元素在排序后可能会交换相对位置,因此它不能保证稳定性。所以选项D的说法确实是错误的。 对于有异议的备选正确,选项A,"变量 i 的作用是记录大于基准值的元素的边界" 字面上讲是不对的,因为 i 是指向"≤ 基准值"的区域的末尾,不是"> 基准值"的起始点。强行解释的话,只能说 i 是分界线,它分隔了"≤"和">"的部分。 相关知识点的复习与拓展:
截至考试当年6月,有关快速排序的实现原理,可以参考下面的视频——
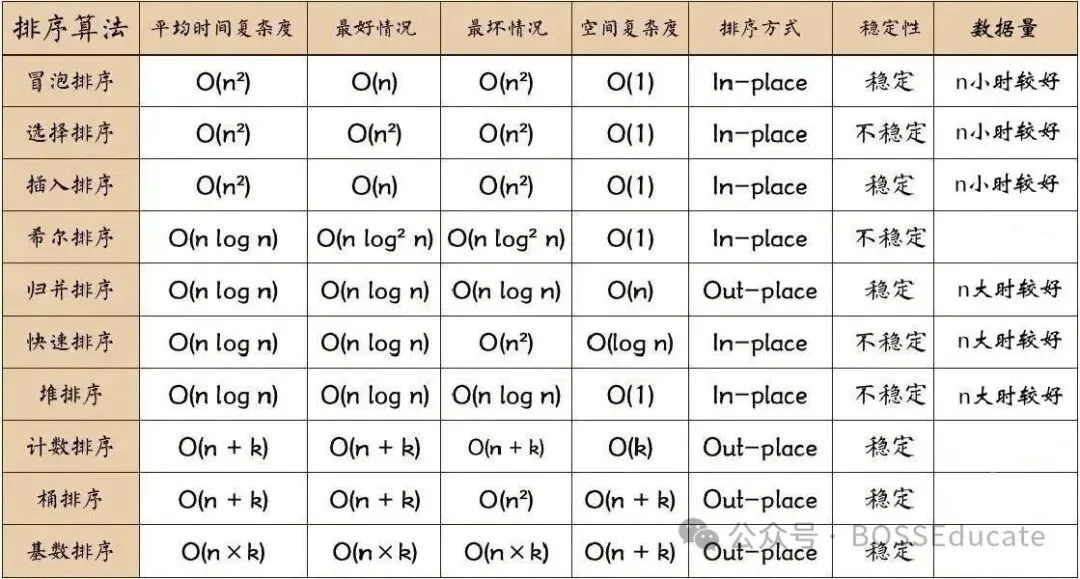
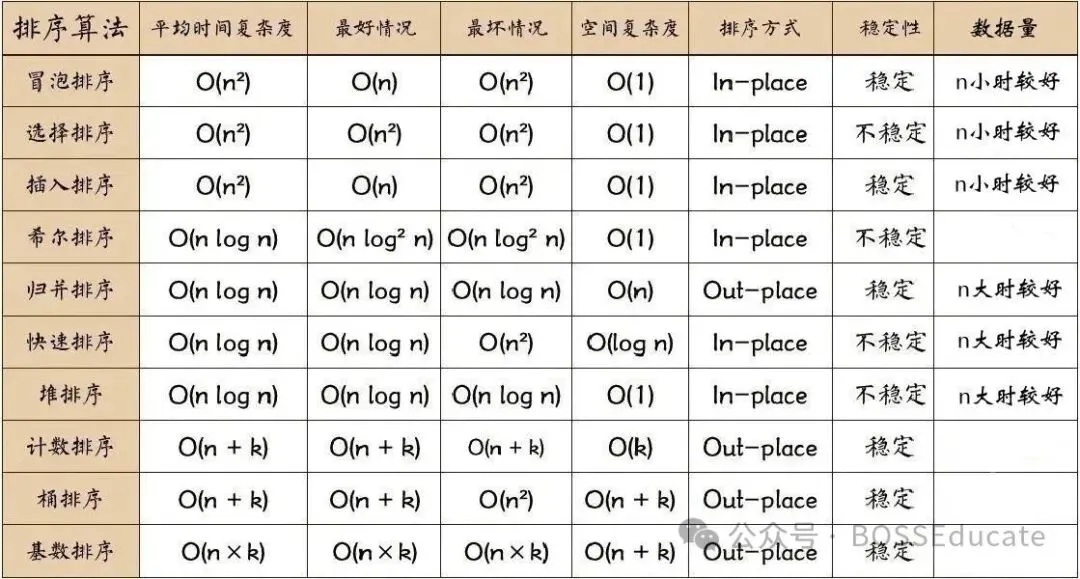
截至考试当年6月,有关十大经典排序的特点对比,可以参考下面的图片——
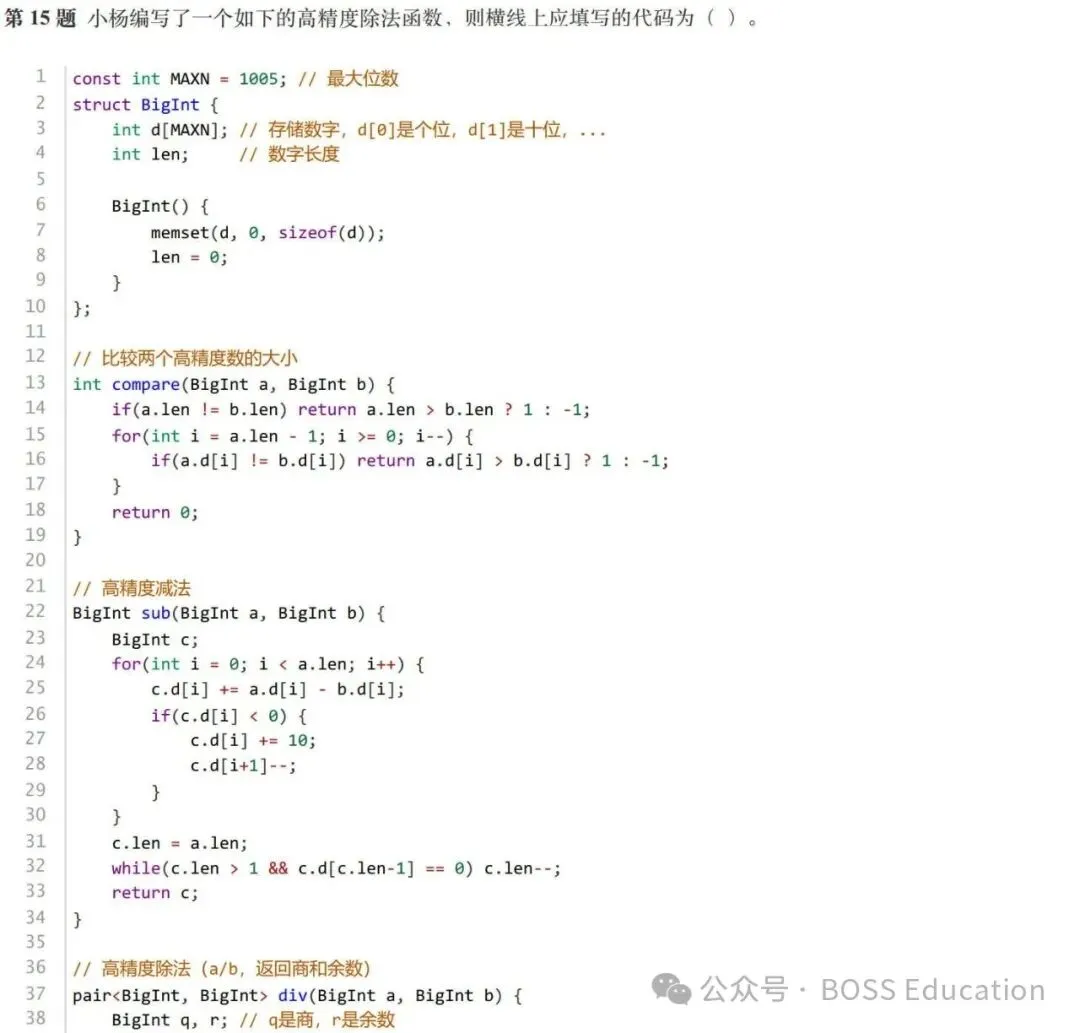
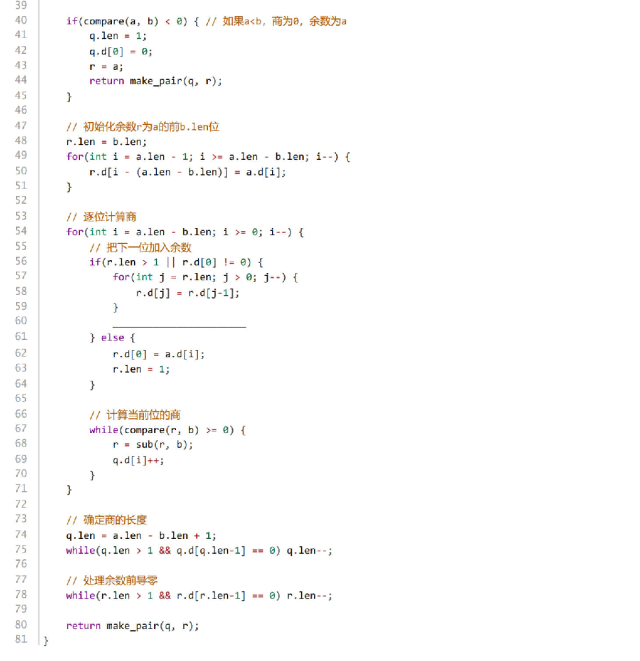
15.解释:答案选A。
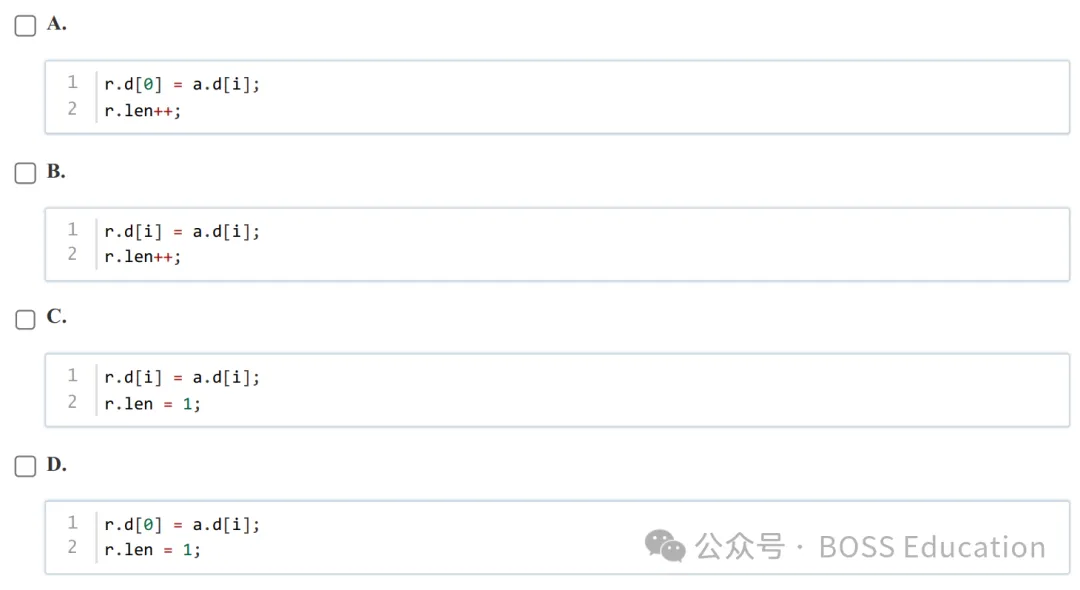
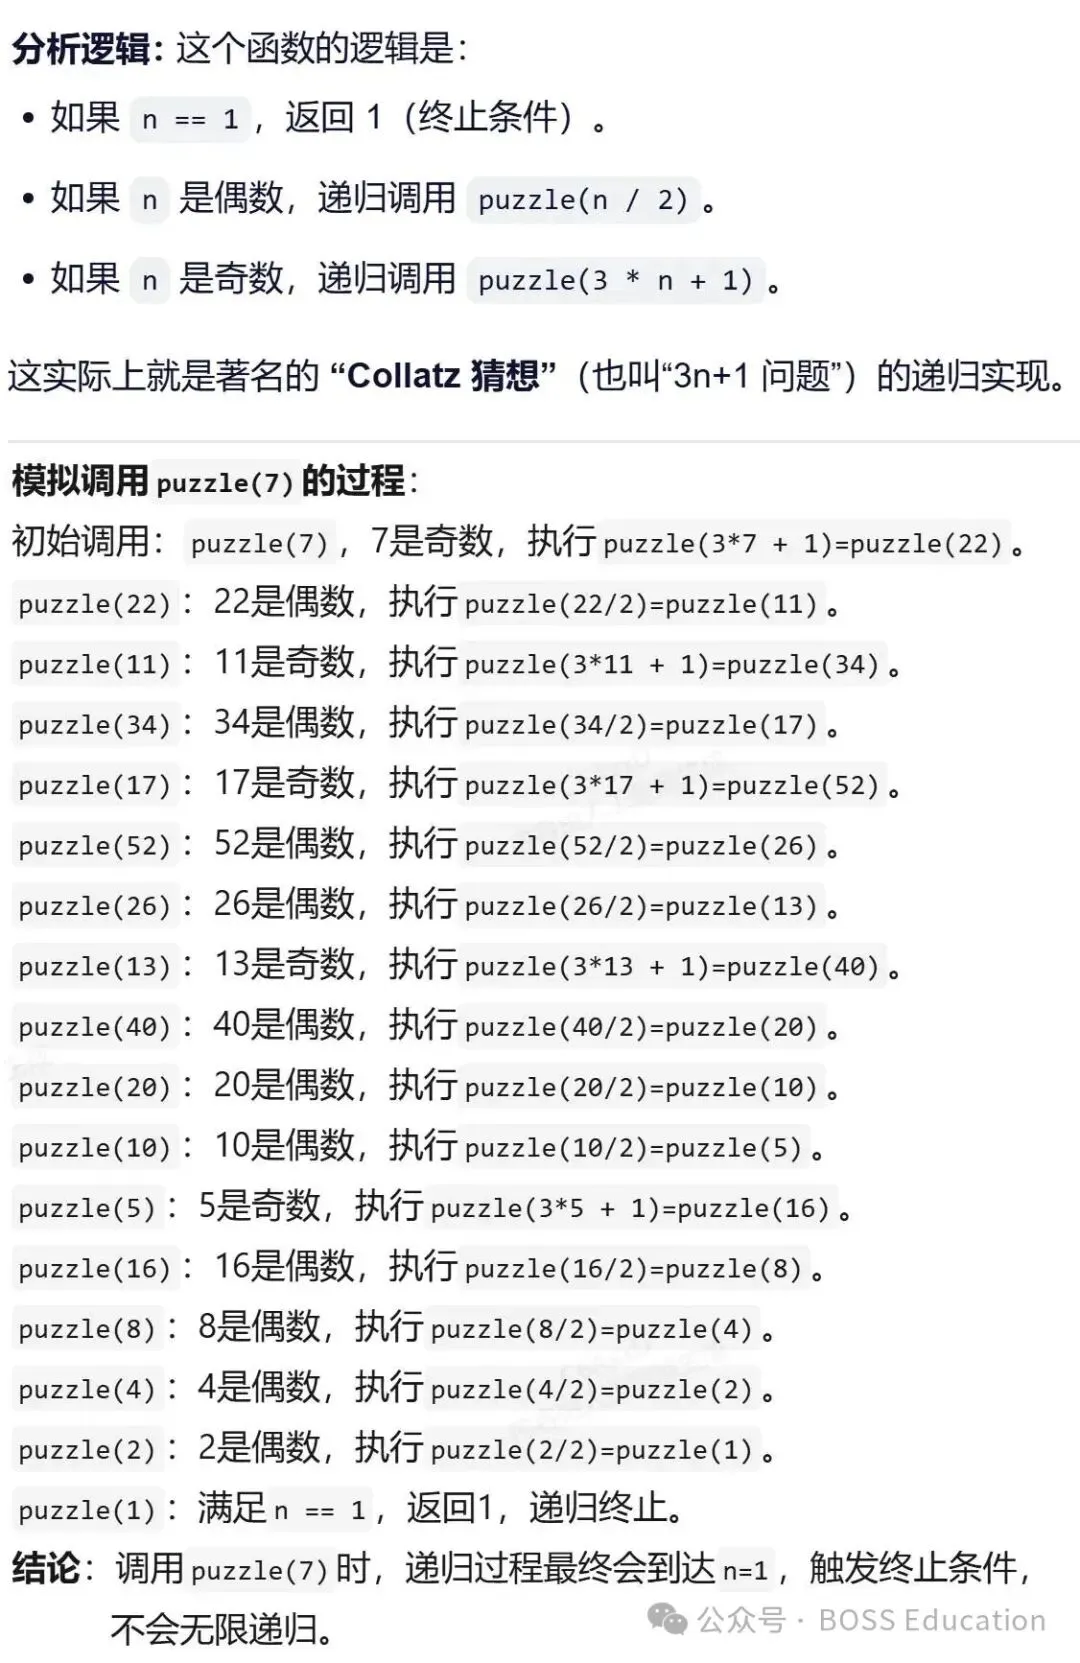
首先我们先来读懂 BigInt 结构体的内容,这个结构体中 d 数组是实际存储数的每一位的,变量 len 是存储数的长度的,便于我们后面进行高精度算法常见的进位或者去前导0,内置的 BigInt 函数用来做初始化。函数 compare 先比数的位数,然后从高位倒序比较每一位,从而确定 a 和 b 哪个更大:如果 a 大那么返回 1 ,否则返回 -1。 读到这里,基本结构体和比较函数就非常清楚了,我们继续阅读理解 sub 函数和 div 函数的意思。sub 函数实现了一个高精度减法,它的核心思想就是从低位考试依此用 a 的每一位对应减 b 的每一位,但是一旦发现当前减完之后结果数组 c 中的第 i 位是一个小于0的数,那么我们进行借位操作,把借位产生的影响在 c 数组的 i+1 位体现出来就行,也就是28行的代码,实际就相当于提前借了10到第 i 位,32行再进行去前导0。 函数 div 是程序的核心,也是我们这个题目考察的点。先特判 a<b 的情况,直接商0,余数为0。接下来模拟除法的过程。在逐位计算商的时候如果 r 非零时需要执行以下操作: 1、移位操作,将余数左移( r.d[j] = r.d[j-1] ),空出 r.d[0] 位置 2、在末尾( r.d[0] )补上下一位数字 a.d[i] 3、余数长度增加1 我们来分析四个选项——选项B和选项C错误使用了 i 作为索引,选项D错误地重置了长度;因此选项A正确。 【答案解析】
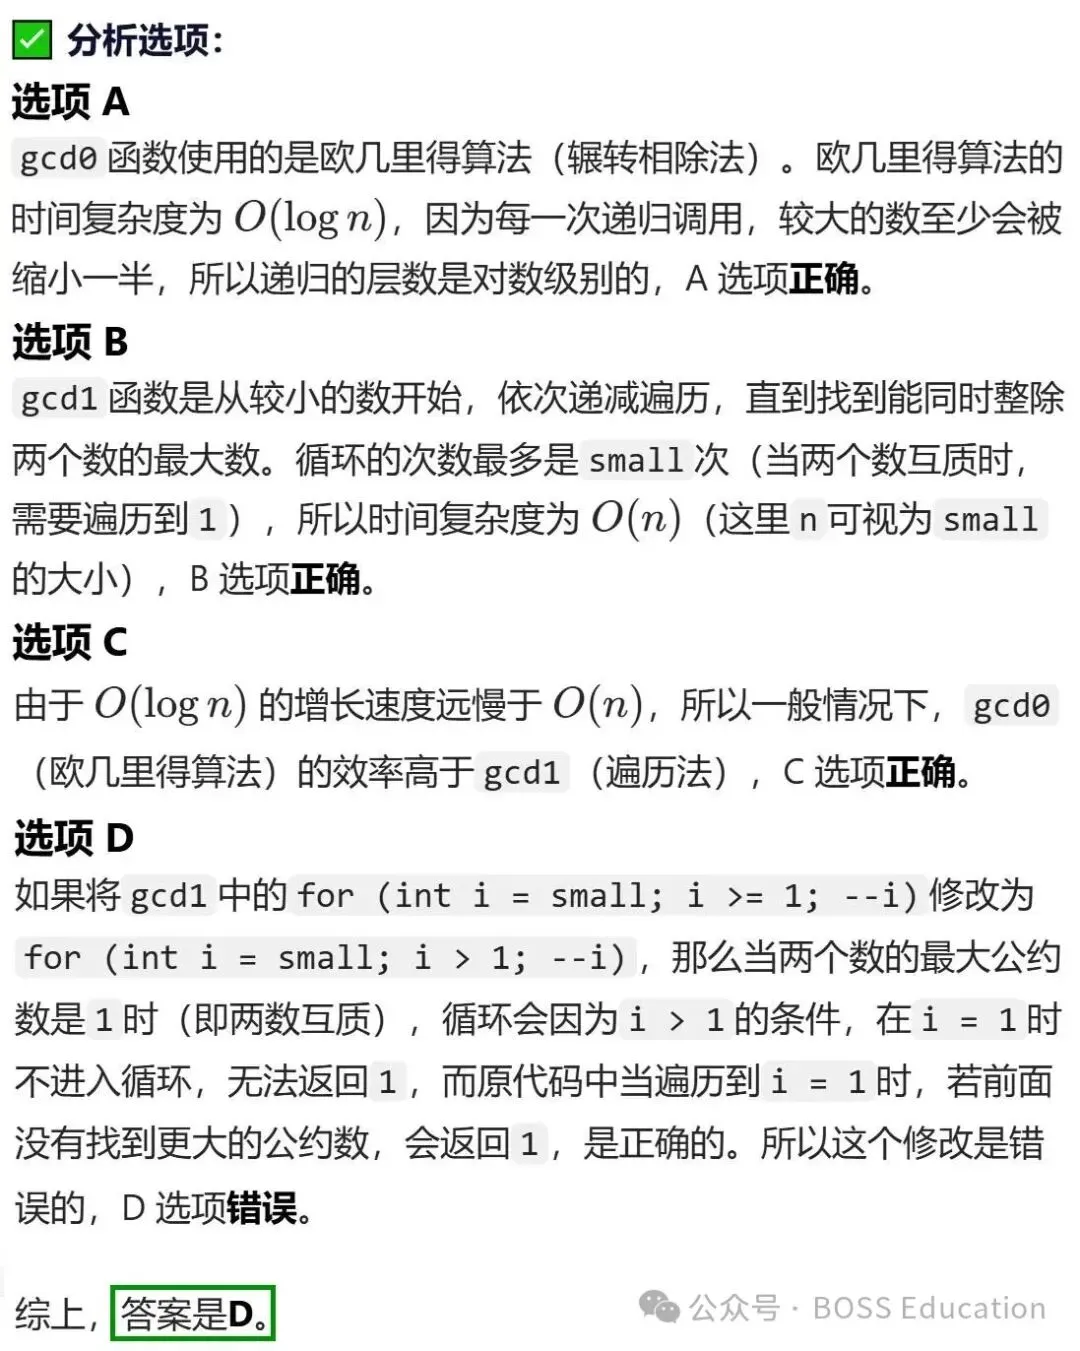
1.解释:正确。
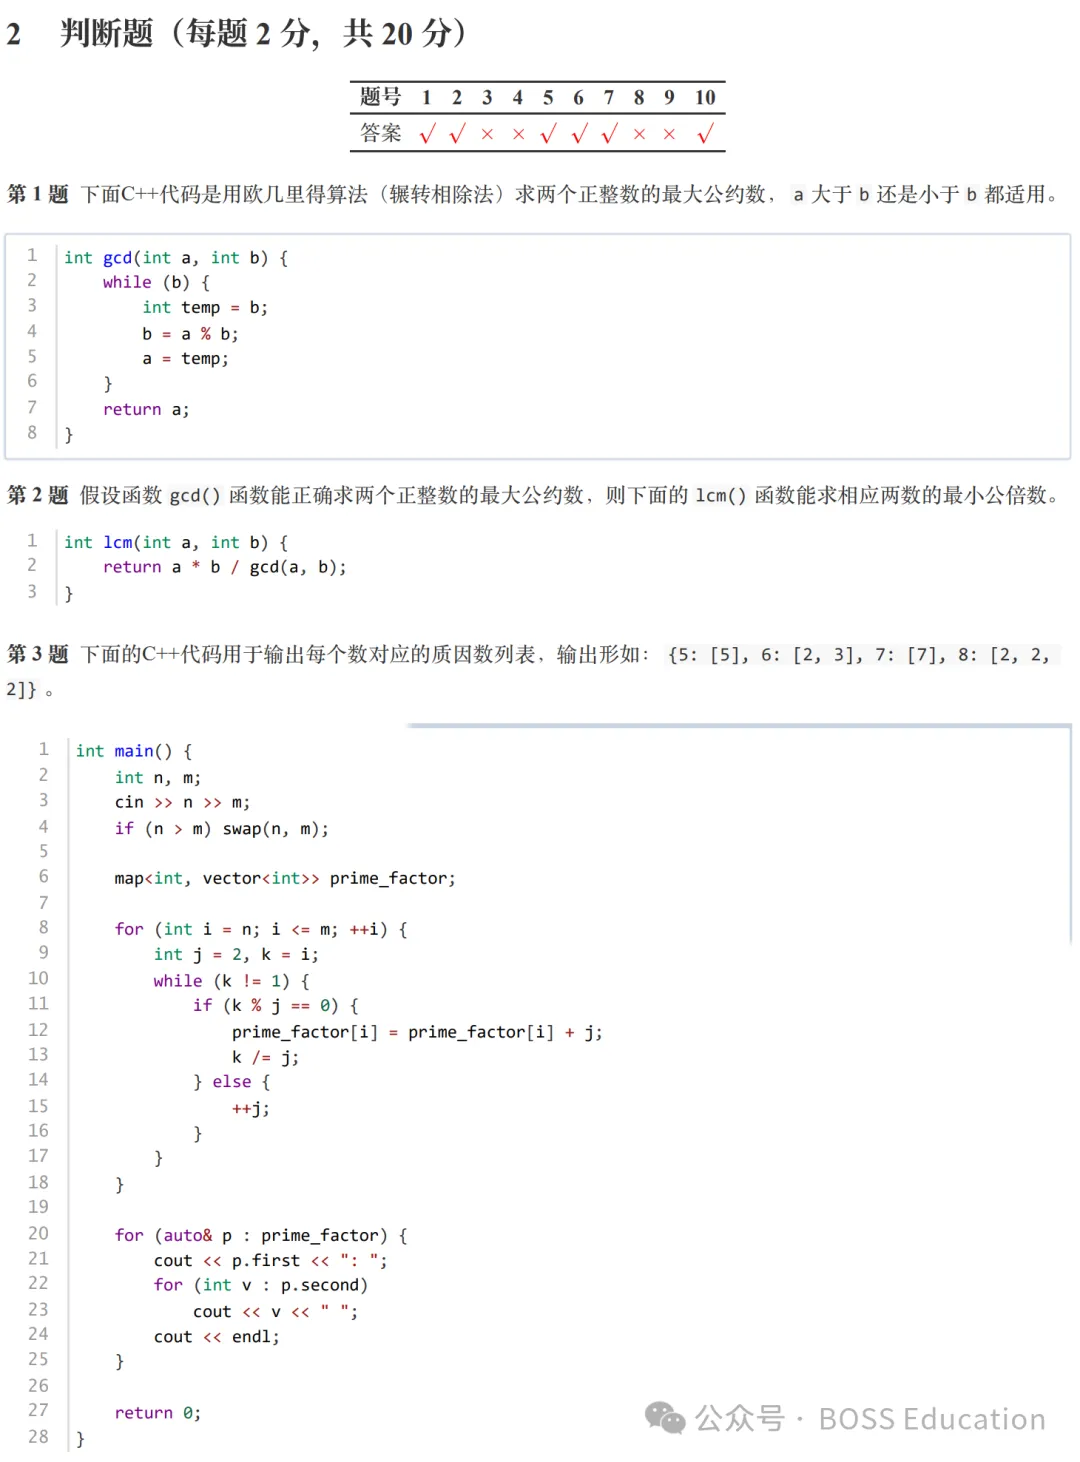
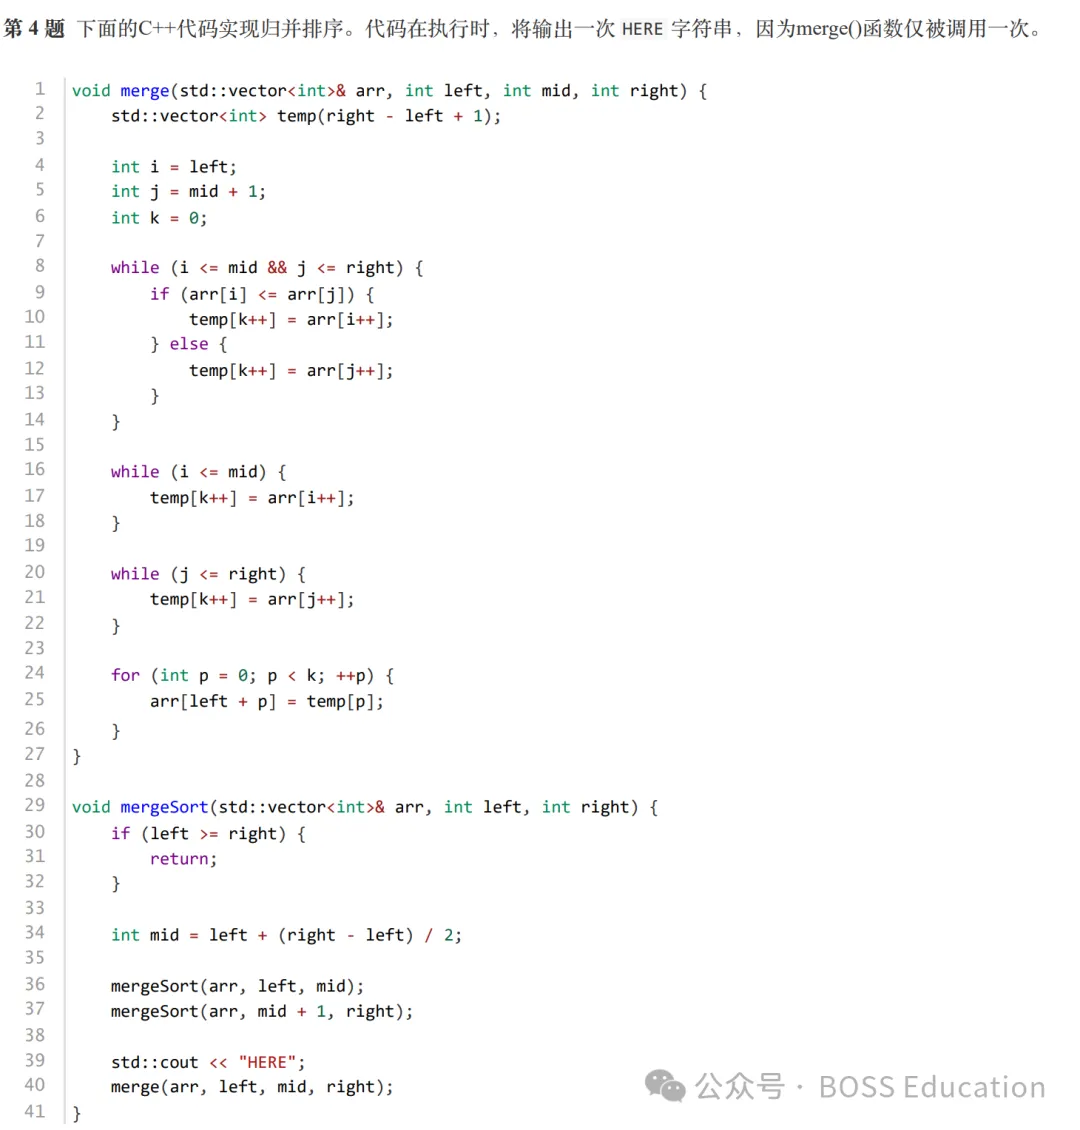
若 a < b ,第一次循环中 a % b 结果为 a ,随后 b 变为 a ,a 变为原 b ,即自动交换大小,因此无论 a 和 b 的初始大小如何,代码均适用。 2.解释:正确。 数学上,两数的最小公倍数等于两数乘积除以最大公约数( lcm(a,b)=a*b/gcd(a,b) ),因此在被调用函数 gcd 正确的前提下,该函数正确。3.解释:错误。 在代码的第 12 行,prime_factor[i] = prime_factor[i] + j; 这一行存在问题。prime_factor[i] 是一个 vector<int> 类型,而 j 是一个 int 类型,不能直接将 int 类型的值与 vector<int> 类型进行这样的加法操作来实现向向量中添加元素。正确的做法应该是使用 prime_factor[i].push_back(j); 来将 j 添加到 prime_factor[i] 这个向量中。 4.解释:错误。 函数 mergeSort 在递归到最底层(left >= right 时)开始返回,然后每次返回时执行 merge 并输出 HERE。对于一个长度为 n 的数组,mergeSort 的递归树如下: ● 第一次分成两半,分别排序,然后合并(输出一次HERE)。 ● 但每个子数组还会继续递归分下去,直到长度为 1。 实际上,最终合并的次数是 n−1 次(在理想归并排序中,每次合并两个有序段,最终合并成整个数组)。 相关知识点的复习与拓展:
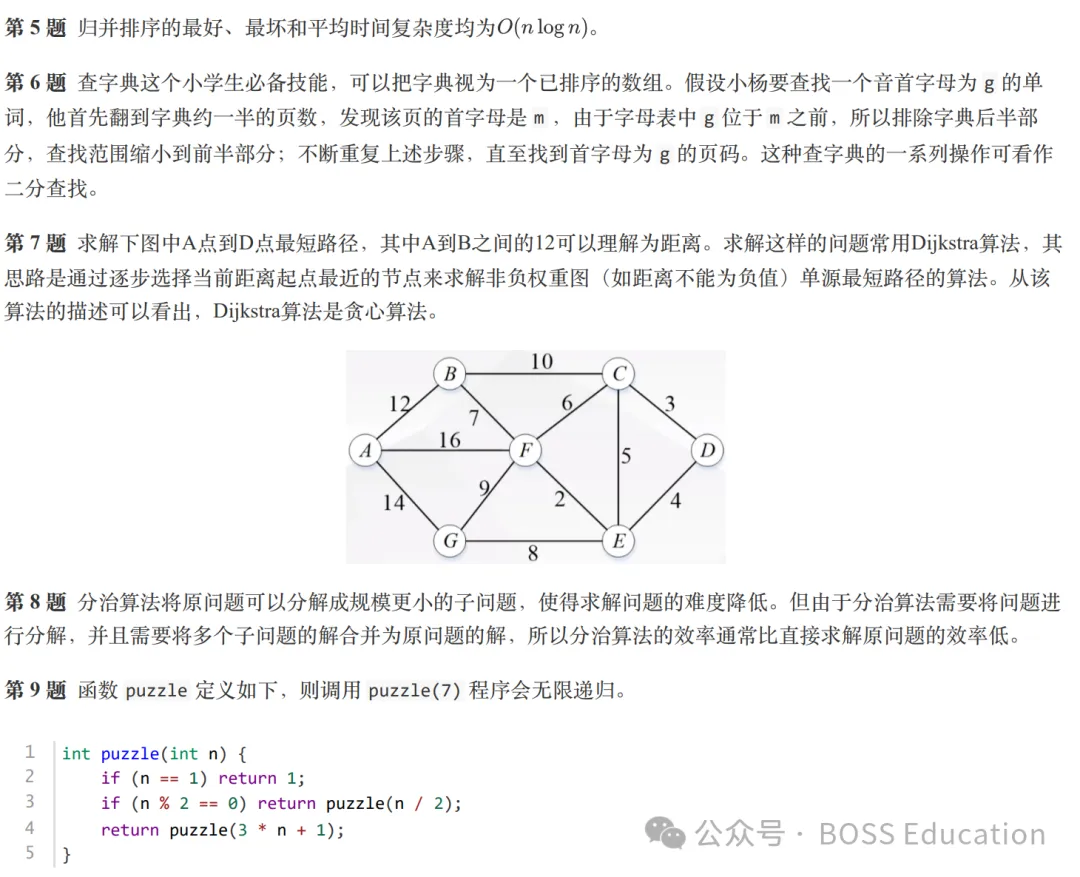
截止考试当年6月,关于归并排序的实现原理,可以参考下面视频所示,加深理解—— 5.解释:正确。 归并排序的时间复杂度不受输入数据顺序影响,无论最好、最坏还是平均情况,均为O(nlogn),这是其相对于快速排序的优势之一。 相关知识点的复习与拓展:
截至考试当年6月,有关十大经典排序的特点对比,可以参考下面的图片——
6.解释:错误。 二分查找的核心是"每次将查找范围缩小一半",题目中描述的查字典过程完全符合这一逻辑,因此可看作二分查找。相关知识点的复习与拓展:
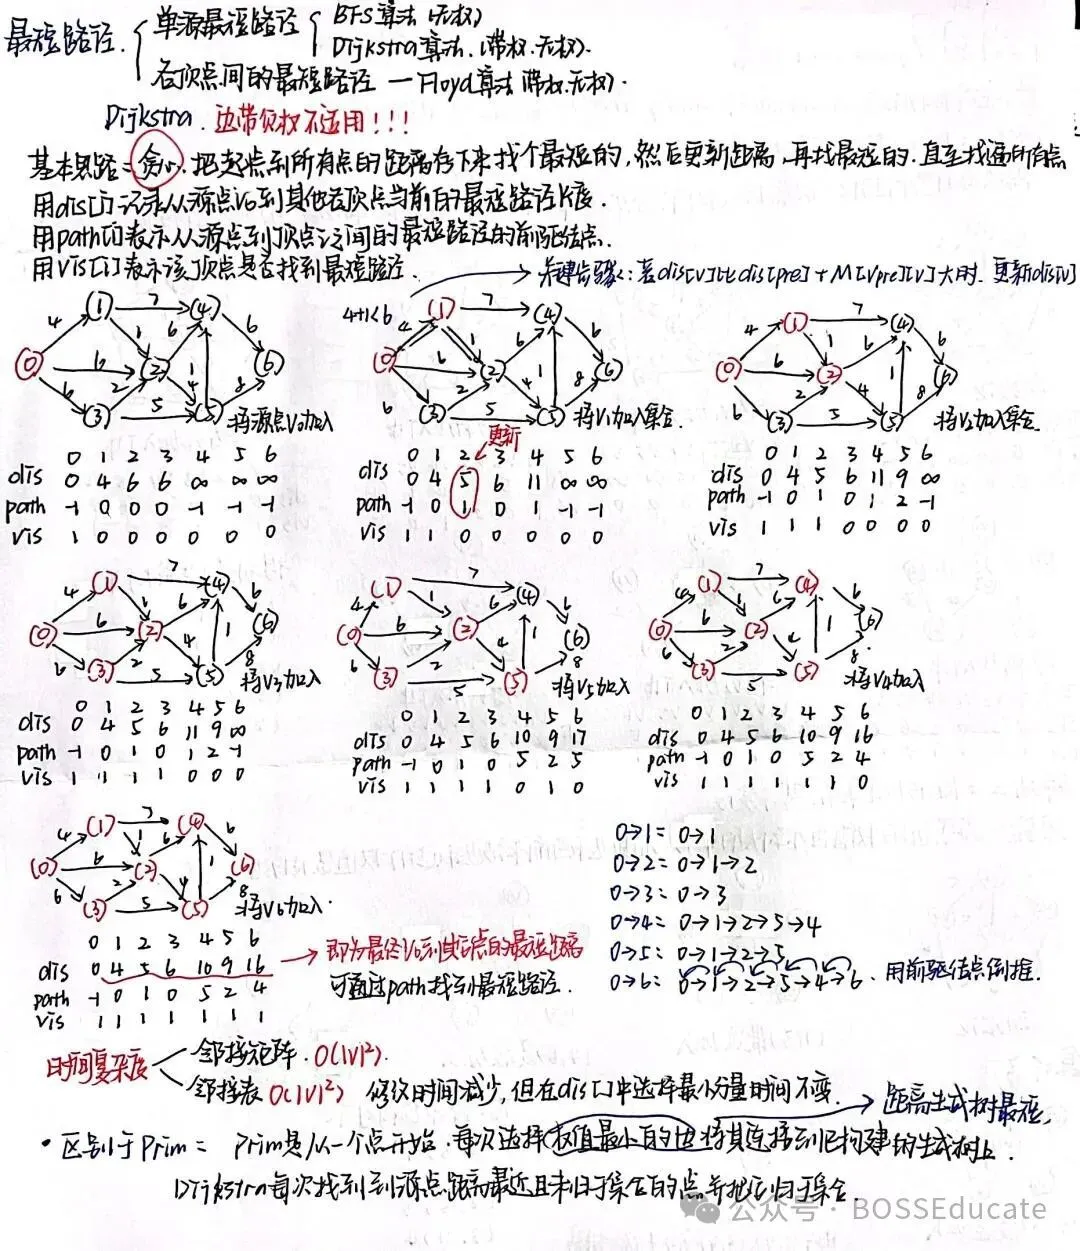
截止考试当年6月,关于二分查找的实现原理,可以参考下面视频所示,加深理解—— 7.解释:正确。Dijkstra算法的核心是每次选择"当前距离起点最近的未访问节点",并基于该节点更新其他节点的距离,这符合贪心算法"局部最优选择"的思想,因此该算法属于是贪心算法。 相关知识点的复习与拓展:
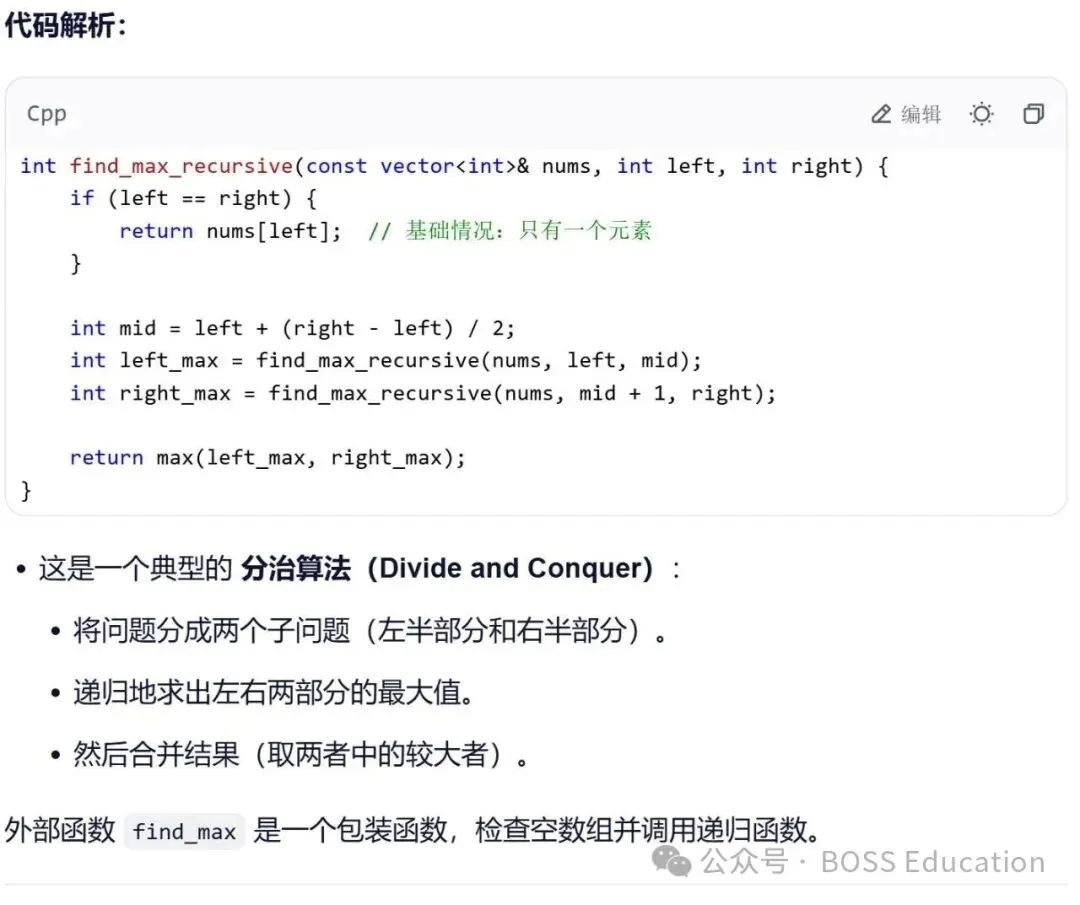
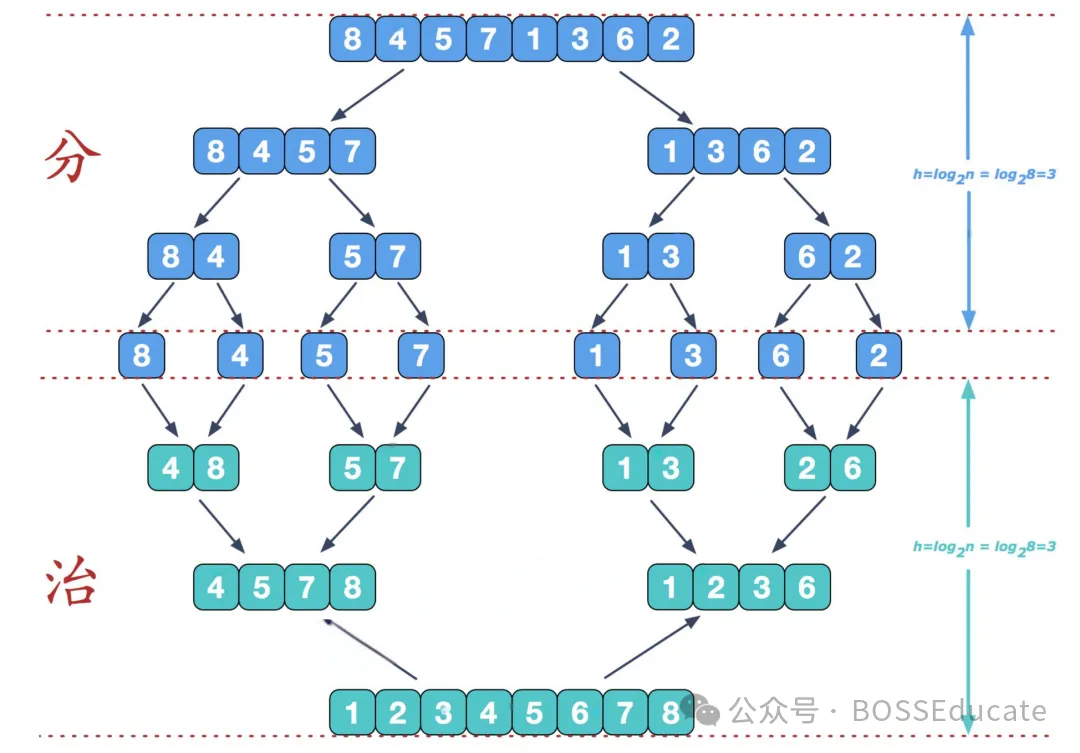
截止考试当年6月,关于Dijkstra算法的实现原理,可以参考下面图片所示,加深理解—— 8.解释:错误。分治算法通过将问题分解为子问题,通常能显著提高效率(如归并排序、快速排序等)。虽然分治有分解和合并的开销,但子问题规模缩小带来的收益往往更大,因此效率通常更高,而非更低,故,题干的表述错误。 相关知识点的复习与拓展:
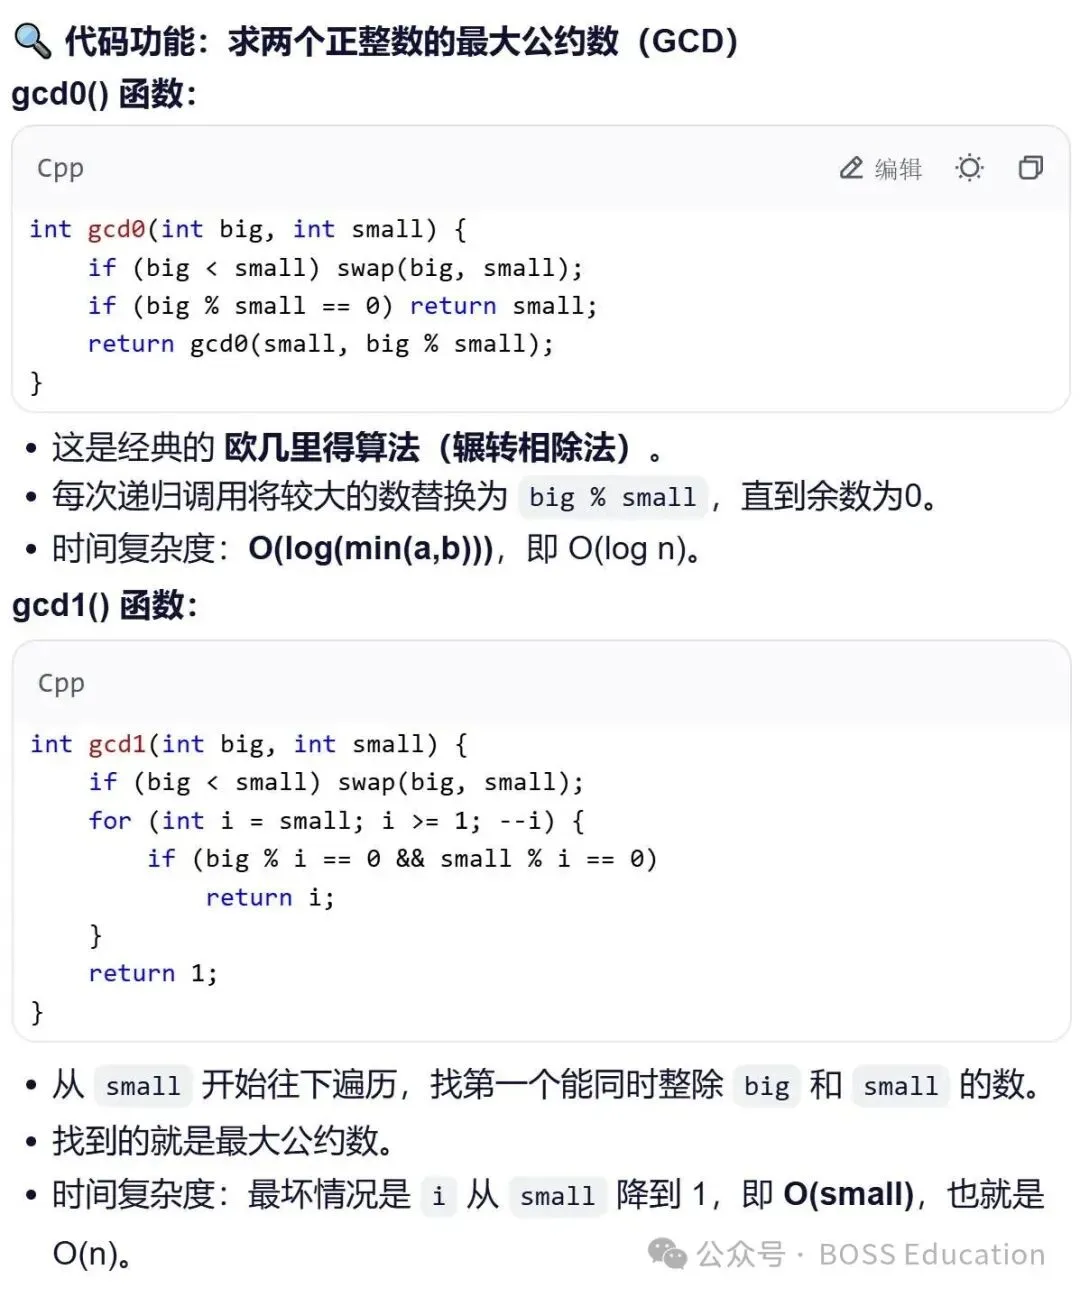
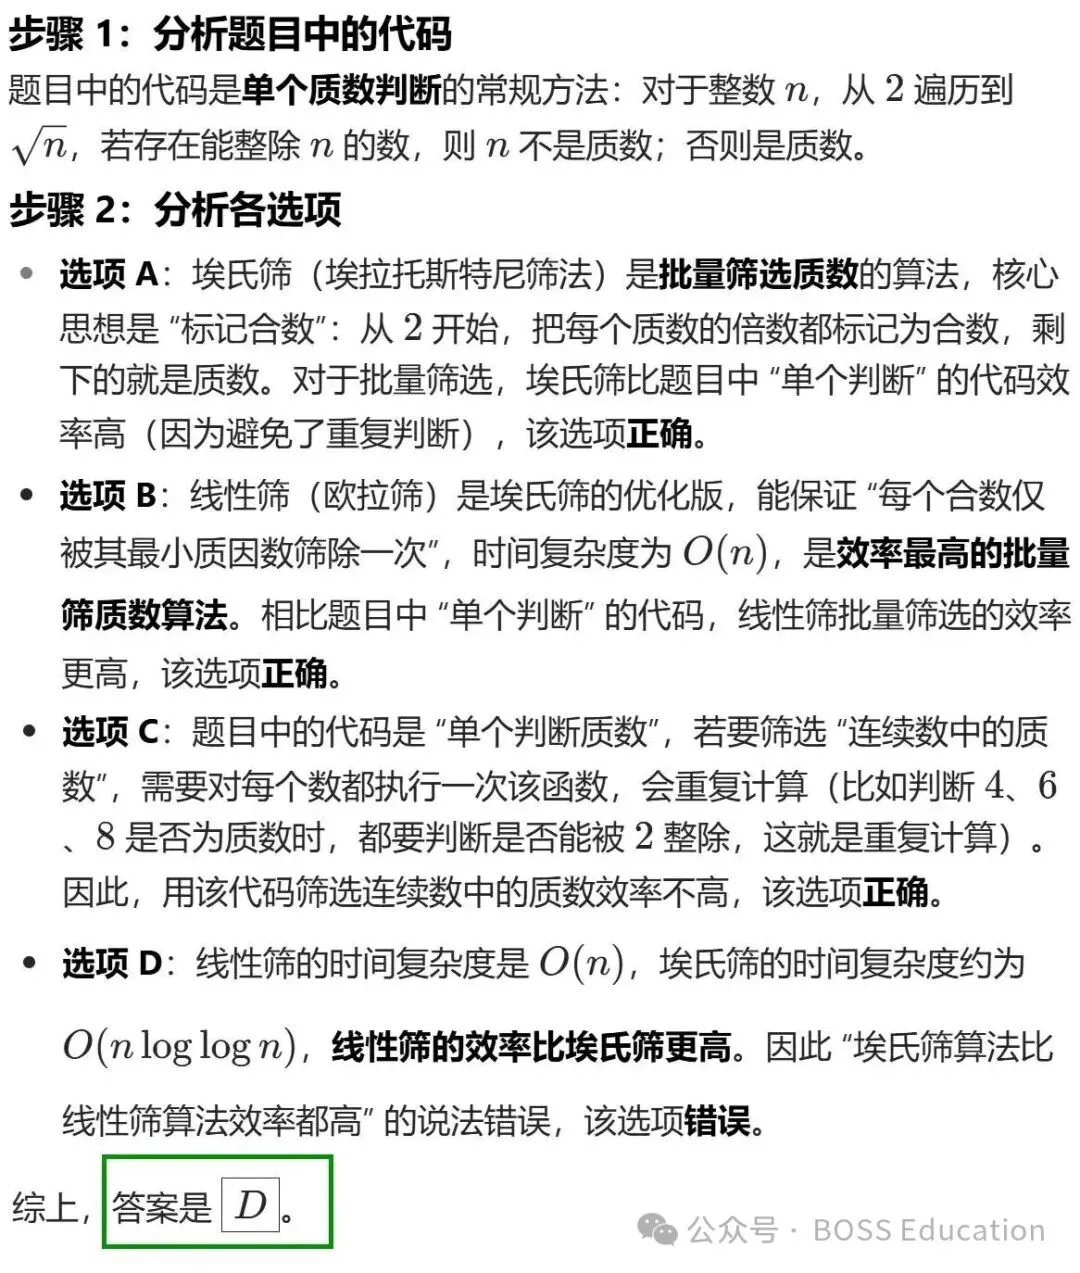
截止考试当年6月,关于分治算法的实现原理,可以参考下面图片,以归并排序为例,加深理解—— 9.解释:错误。 详细解释如下图所示—— 10.解释:正确。
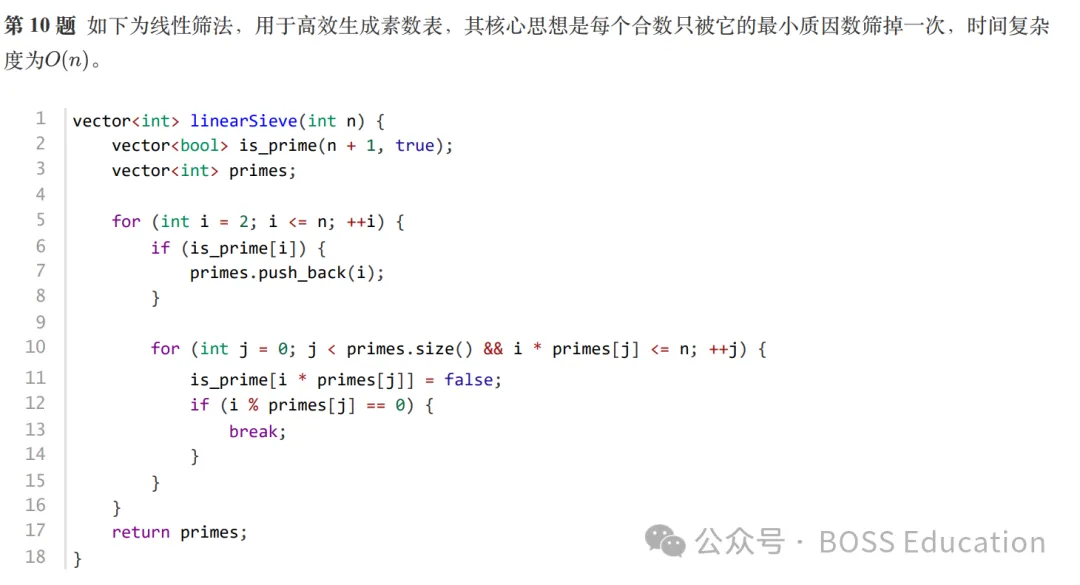
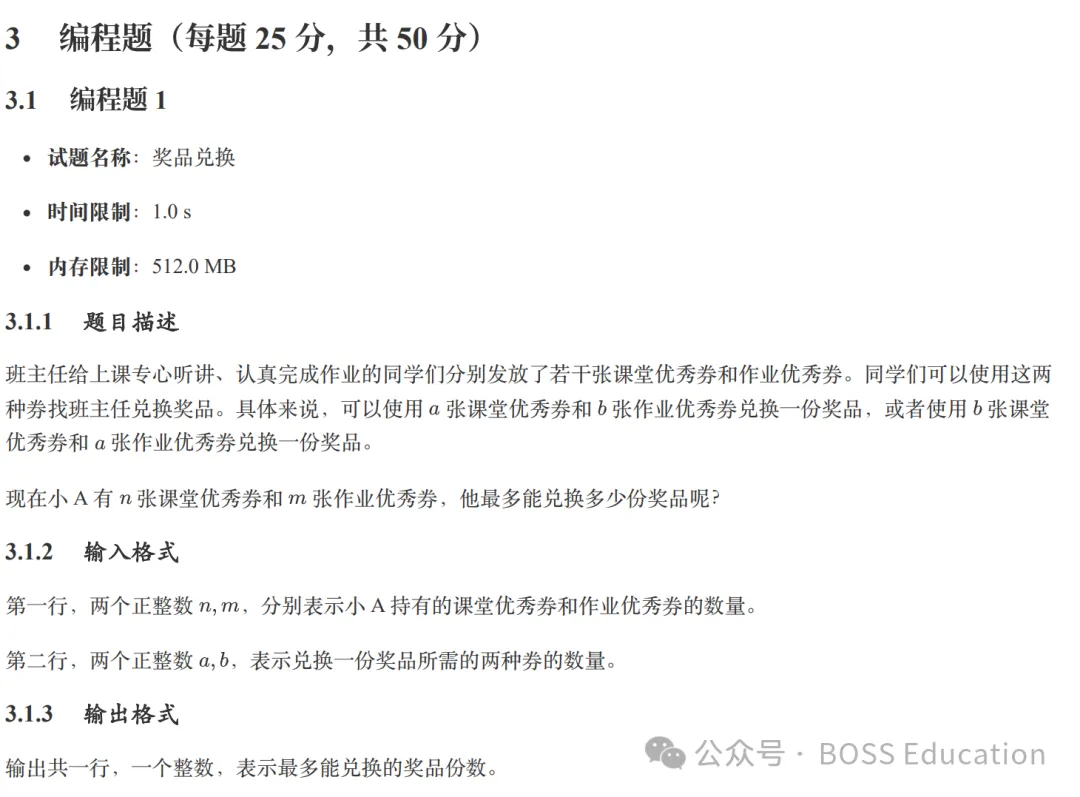
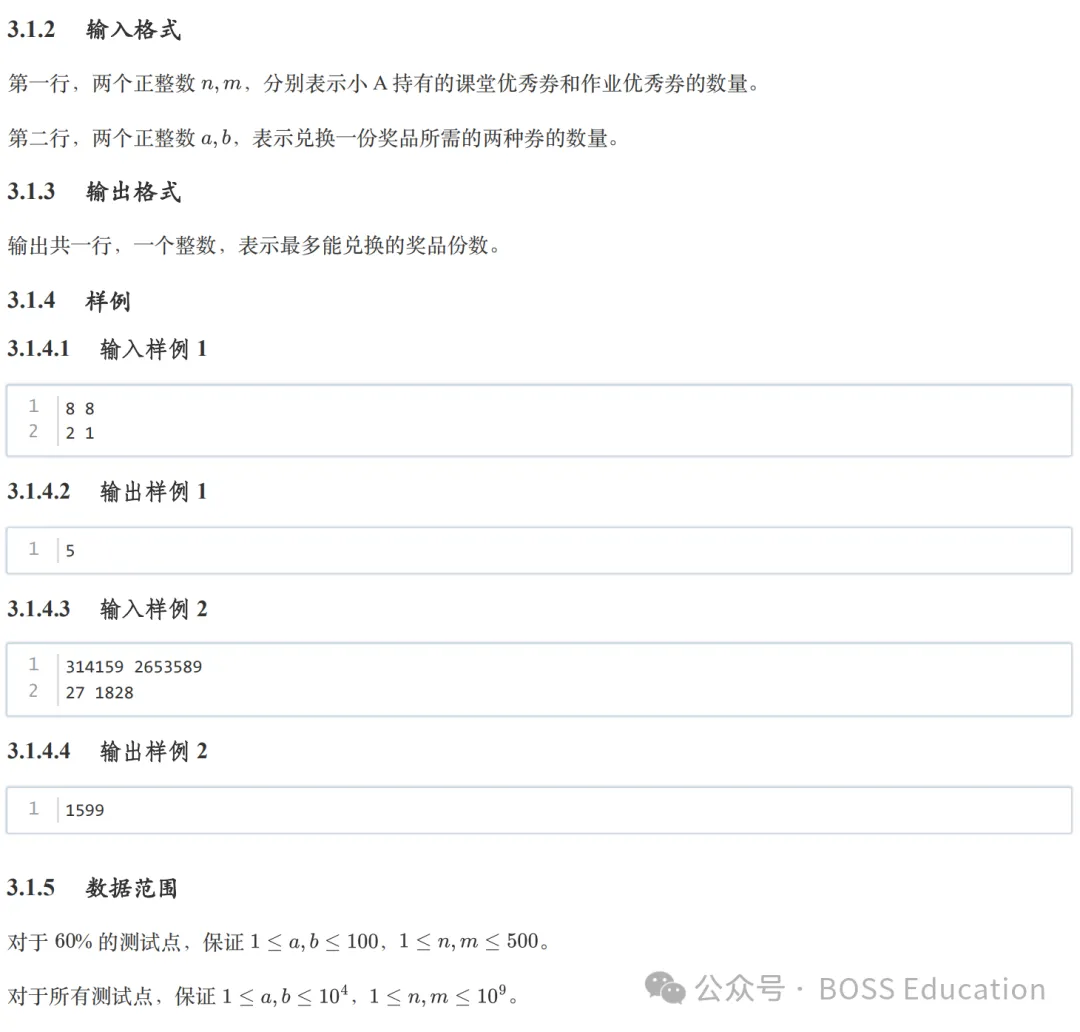
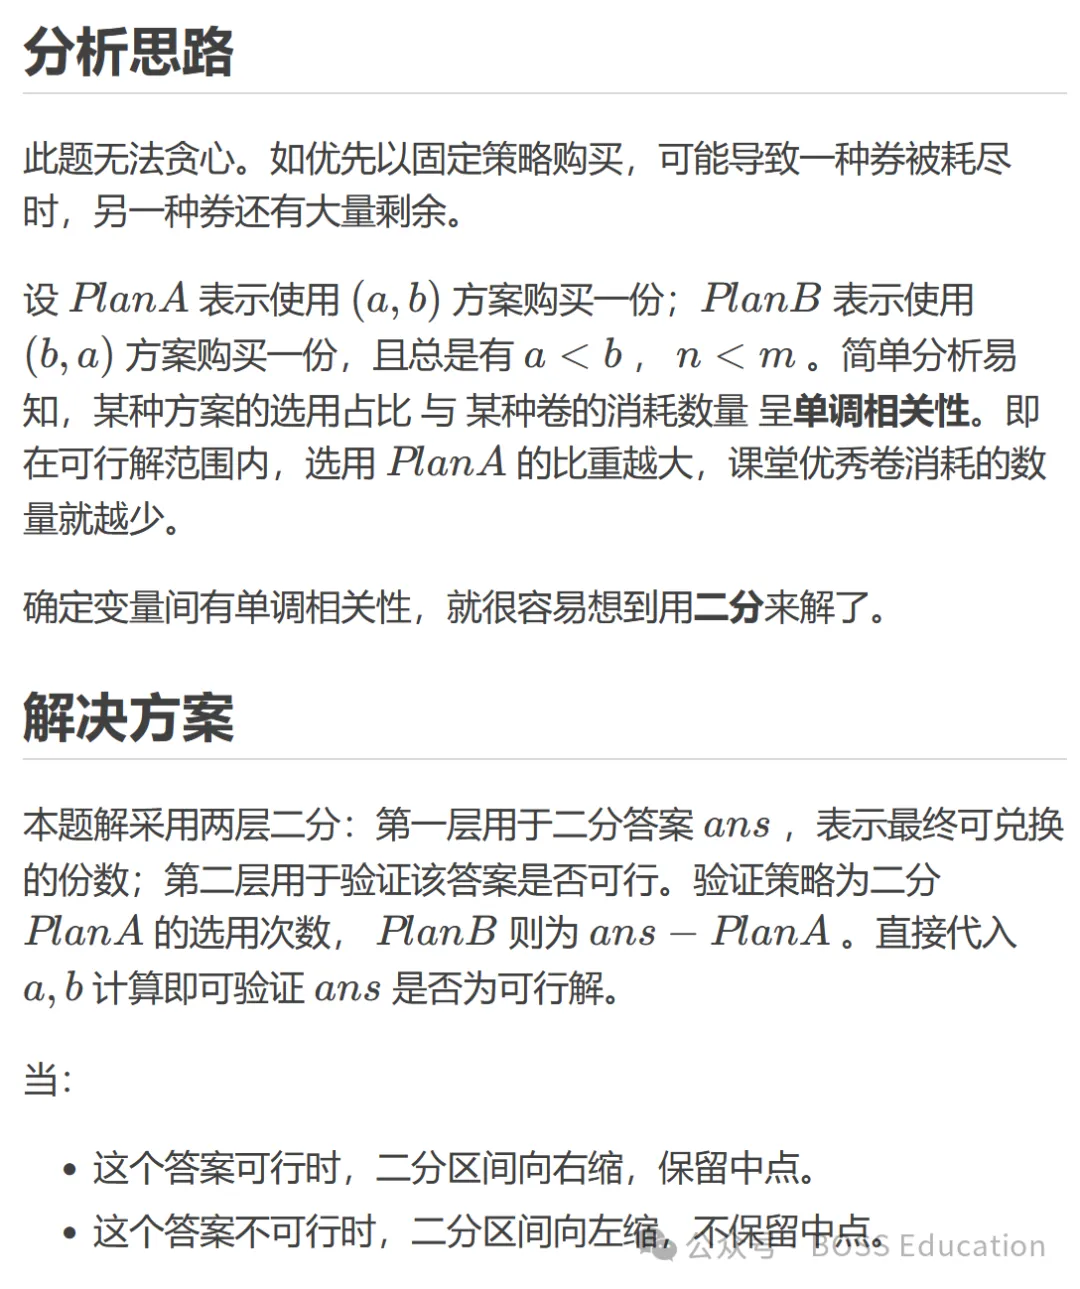
线性筛(欧拉筛)通过"每个合数只被其最小质因数筛除"的机制,确保每个数仅被处理一次,时间复杂度为O(n),是目前效率最高的素数筛法之一。代码实现正确,因此说法正确。 GESP 2025年6月 C++五级 奖品兑换
#include<bits/stdc++.h>using namespace std;intmain(){int n, m;int a, b;cin >> n >> m;cin >> a >> b;// 此题无法贪心。优先以固定策略购买时,可能导致一种券被耗尽时,另一种券还有大量剩余。// 改用在特定范围内二分答案,并二分分配方案验证是否可行。// 预处理:确保前小后大if(n > m){swap(n, m);}if(a > b){swap(a, b);}// 答案范围: n/b ~ m/aint ans_left = n/b;int ans_right = m/a;int ans; // 兑换礼物份数while(ans_left < ans_right){ans = (ans_left + ans_right + 1) / 2;// 验证该答案int a_left = 0; // Plan A左边界int a_right = ans; // Plan A右边界int a_num; // 以Plan A(a,b)策略兑换的份数// 二分验证bool valid = false;while(a_left <= a_right){a_num = (a_left + a_right) / 2;int b_num = ans - a_num; // 以(a,b)策略兑换的份数// 如果这是可行解if(a_num * a + b_num * b <= n && a_num * b + b_num * a <= m){valid = true;break;}else{// 确认偏移策略:// 如果n和m均无剩余,则这是不可能的答案。if(a_num * a + b_num * b > n && a_num * b + b_num * a > m){break;}// 如果n有剩余,则增加b_num(经排序,b比a大),即降低a_numelse if(a_num * a + b_num * b <= n){a_right = a_num - 1;}// 如果m有剩余,则增加a_num,即降低b_numelse{a_left = a_num + 1;}}} // while(a_left < a_right){ 验证循环if(valid){ // 这种答案可行ans_left = ans;}else{ // 这种答案不可行ans_right = ans - 1;}}cout << ans_left;return 0;}代码思路——GESP 2025年6月 C++五级 最大公因数
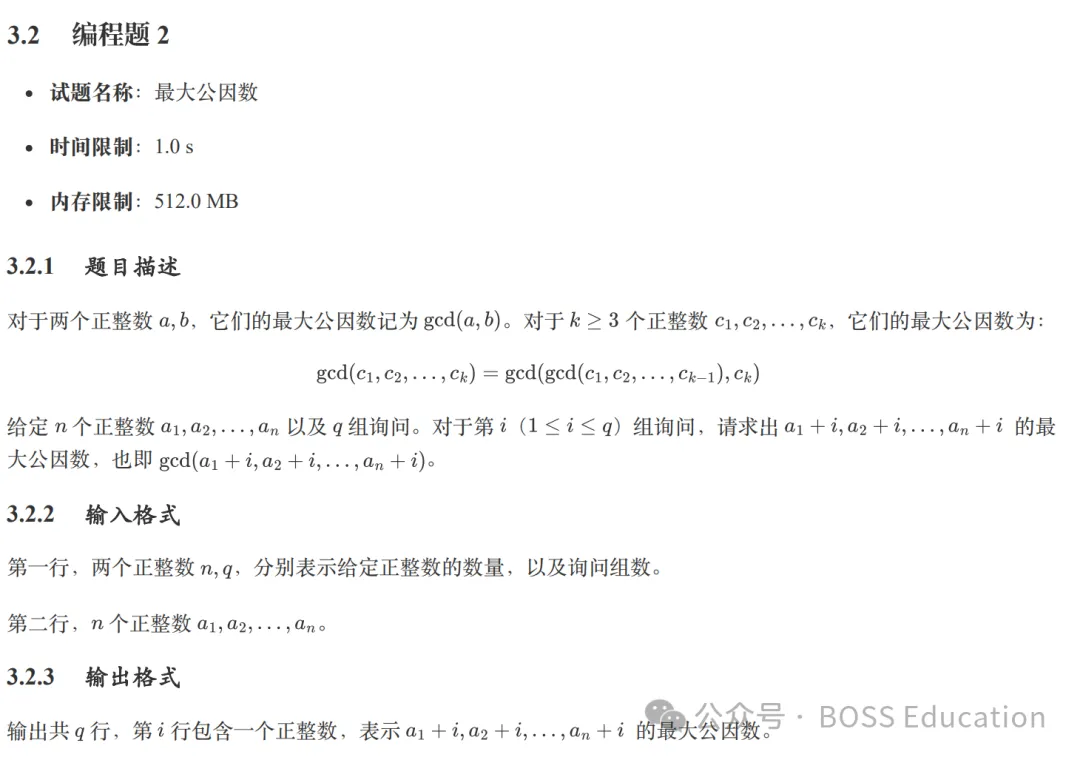
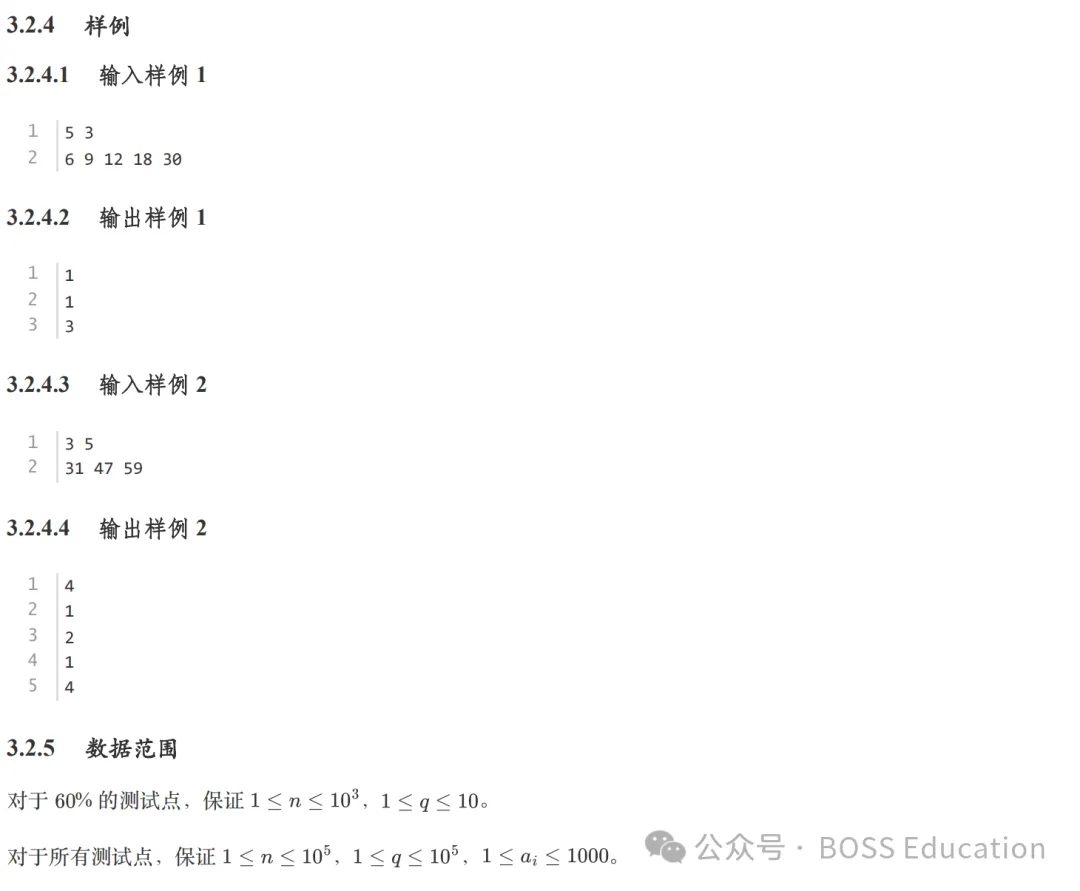
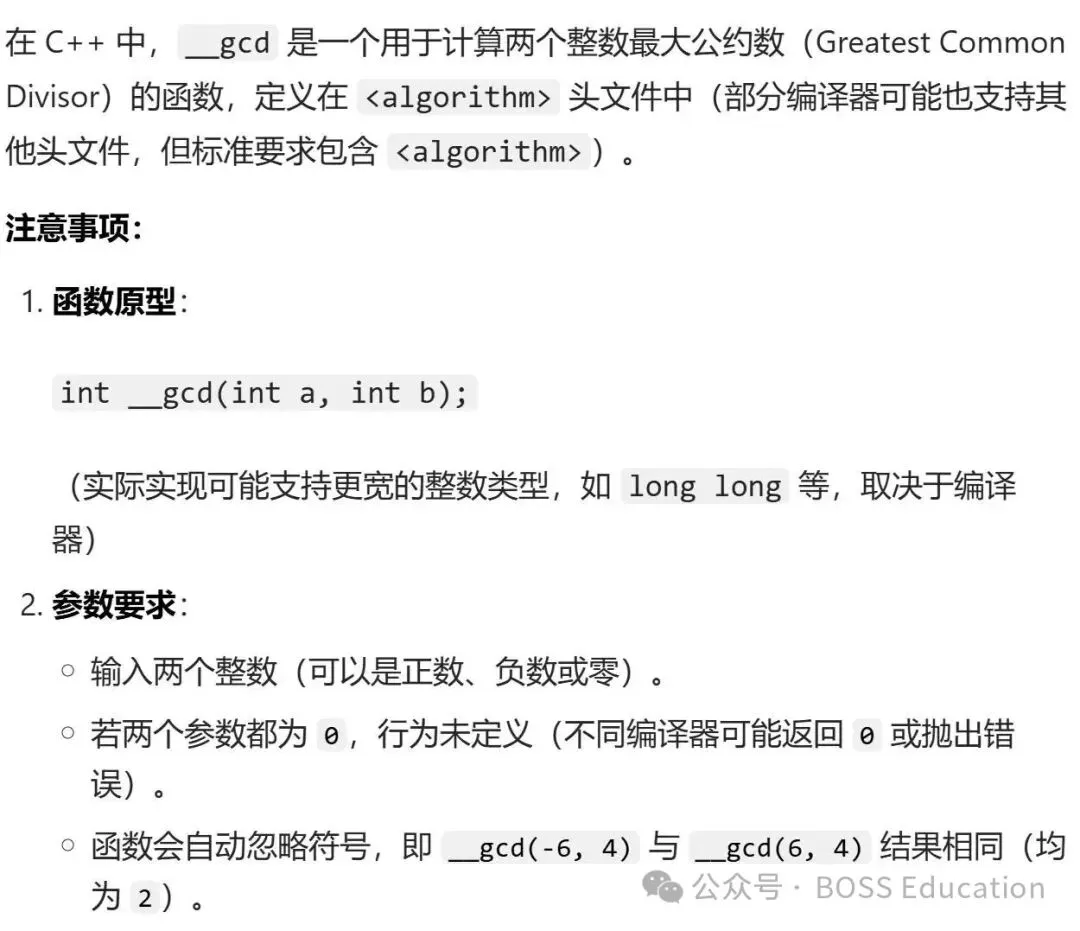
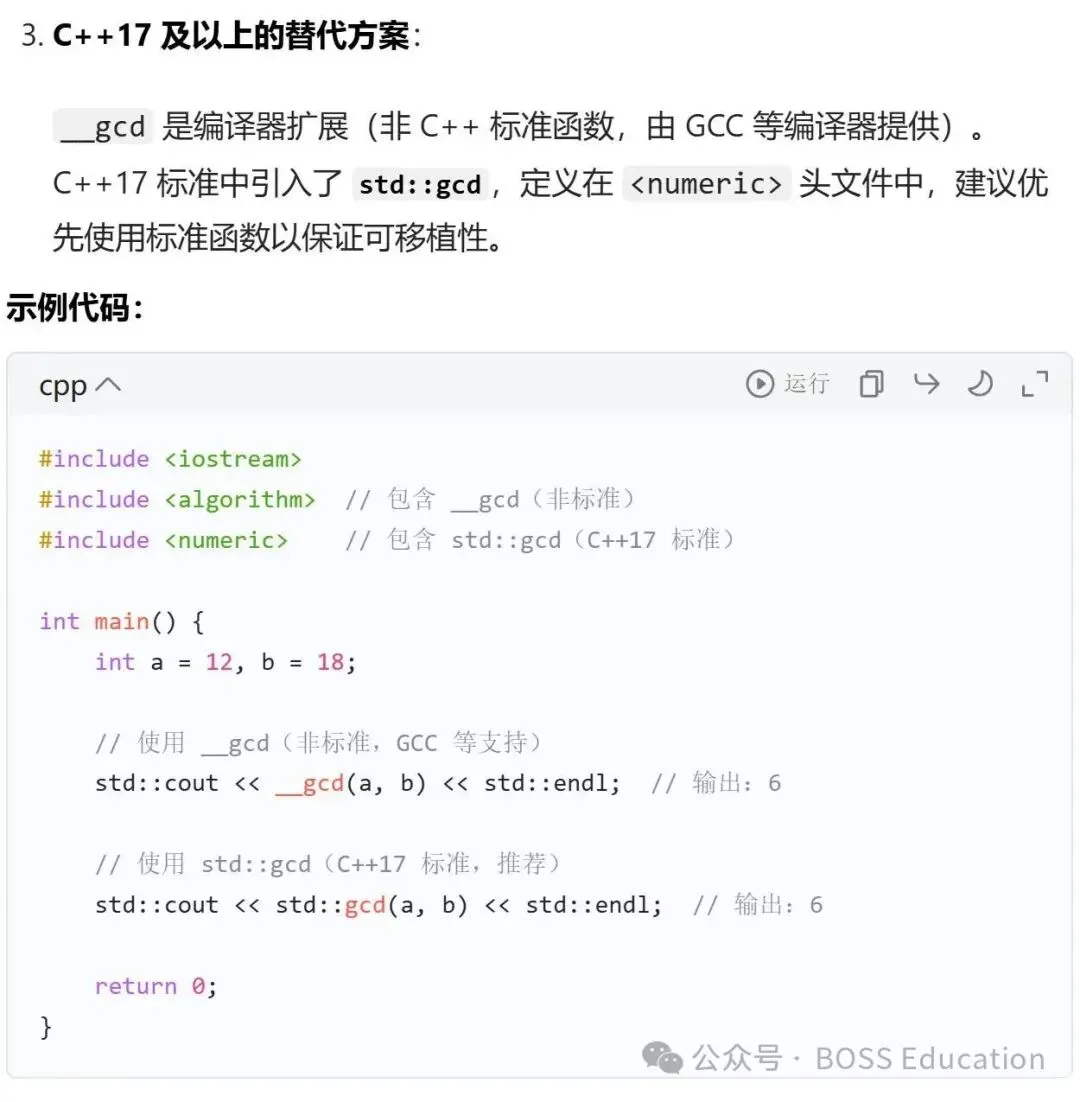
#include<bits/stdc++.h>using namespace std;const int maxn=1e5+1;int n,q,a[maxn],gcd;signedmain(){cin>>n>>q;for(int i=1;i<=n;i++){cin>>a[i];}for(int i=2;i<=n;i++){gcd=__gcd(gcd,abs(a[i]-a[1]));}for(int i=1;i<=q;i++){cout<<__gcd(gcd,a[1]+i)<<endl;}return 0;}代码思路——利用函数 __gcd 可以在对数时间复杂度下计算最大公因数。
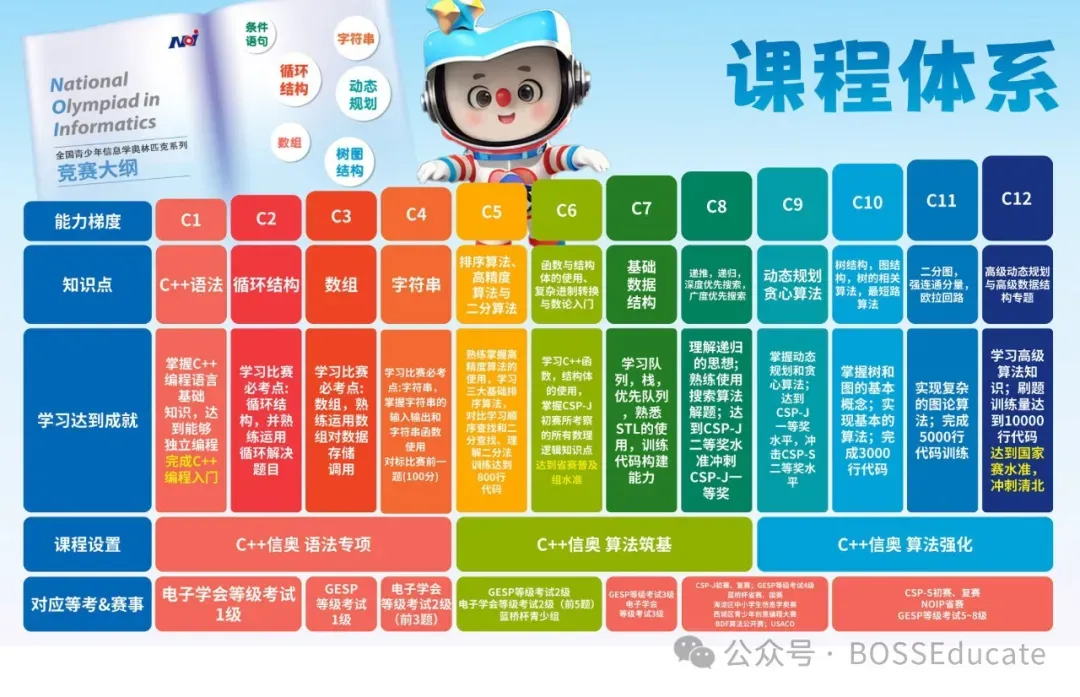
课程体系——
需要无水印PDF格式文件, 或者课程体系咨询, 欢迎扫描下面二维码添加好友垂询。
▍ 声明:本文整理自网络,如有侵权,请联系删除。
本公号刊载此文,是出于合法合理地分享和传播信息,扩大大受众范围,促进学术交流,推动共同进步之目的。公众号持有人郑重声明,本文的发布,将严格遵守相关规定和法律法规,不侵犯任意潜在作者的权益,不改变引用原文(若有)的意图和内容。若有来源标注错误或侵犯了您的合法权益,请随时与我们联系协商,联系(QQ):993225721,我们将及时更正、删除。文章若有幸得到转载,首先,公众号持有人感谢转载人为读者阅读提供了有价值的信息和知识,希望文章能够在被转载的平台上得到更广泛的传播和交流;其次,转载人应充分考虑到转载动作本身所可能带来的相应的风险和责任,包括但不限于侵犯知识产权、侵犯他人权益等行为所引起的法律责任,确保本文的合法传播和使用。同时,本人也极其愿意在转载过程中尽力配合转载人了解、关注、规避、消除相关的潜在风险。若转载人有相任何关疑虑,同样欢迎随时与我们联系协商,联系(QQ):993225721。 喜欢您关注我们哦——


文章来源:
四季读书网
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至23467321@qq.com举报,一经查实,本站将立刻删除;如已特别标注为本站原创文章的,转载时请以链接形式注明文章出处,谢谢!


