

考点分析
备考建议和考试策略
真题详解
前序和后序
问题描述
我们都很熟悉二叉树有前序、中序和后序遍历。
一个很常见的问题就是给定一个二叉树的中序和后序遍历,求它的前序遍历。
或者,给定一个二叉树的前序和中序遍历,求它的后序遍历。
但是,一般来说,给定一个二叉树的前序和后序遍历,则无法确定它的中序遍历。
考虑下面四个二叉树:
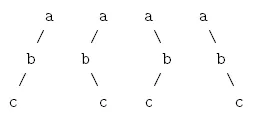
这些树都有相同的前序和后序遍历。
这种现象不仅限于二叉树,同样也适用于普通的 m叉树。
现在,给定一个 m叉树的前序和后序遍历,请你求出具有该前序和后序遍历的 m
叉树的数量。
输入格式
输入包含多组测试数据。
每组数据占一行,首先包含一个整数 m,表示这是 m叉树,然后包含两个字符串 s1和 s2,表示其前序和后序遍历。
输出格式
每组数据输出结果占一行,输出一个整数,表示具有给定前序和后序遍历的 m
叉树的数量。
保证答案大于 0,且不超过 int范围。
数据范围
1≤m≤20,
1≤|s1|=|s2|≤26,
输入前序和后序遍历序列,由前 |s1|个小写字母构成。
每个输入最多包含 60组数据。
输入样例
2 abc cba
2 abc bca
10 abc bca
13 abejkcfghid jkebfghicda
输出样例
4
1
45
207352860
思考
对于当前子树,其前序第一个字符和后序最后一个字符一定是根节点。
根节点后面的森林可以按照孩子子树依次划分:
前序中根节点之后第一个字符,是第一个孩子子树的根;
在后序中找到这个字符的位置,就能确定第一个孩子子树的大小;
递归计算该孩子子树,然后继续处理剩余部分。
设某个根节点最终有 k 个非空孩子。由于这 k 个孩子在遍历中的相对顺序是固定的,但它们可以放在 m 个有序孩子位置中的任意 k 个位置上,因此该节点贡献:C(m, k)种方案。所有节点的方案数相乘即为答案。
时间复杂度为 O(n^2),其中 n≤26
代码
#include<bits/stdc++.h>using namespace std;int m;string pre, post;int posInPost[26];long long C[21][21];// 计算 pre[pl..pr] 和 post[ql..qr] 对应的子树数量longlongdfs(int pl, int pr, int ql, int qr){if (pl > pr) return 1;long long ans = 1;int curPl = pl + 1; // 当前孩子子树在前序中的起点int curQl = ql; // 当前孩子子树在后序中的起点int childCnt = 0; // 根节点的孩子数while (curPl <= pr) {char childRoot = pre[curPl];int pos = posInPost[childRoot - 'a'];int len = pos - curQl + 1; // 该孩子子树的节点数ans *= dfs(curPl, curPl + len - 1, curQl, pos);curPl += len;curQl = pos + 1;childCnt++;}// 根节点有 childCnt 个非空孩子,// 它们可以占据 m 个有序孩子位置中的任意 childCnt 个位置ans *= C[m][childCnt];return ans;}intmain(){ios::sync_with_stdio(false);cin.tie(nullptr);// 预处理组合数for (int i = 0; i <= 20; i++) {C[i][0] = C[i][i] = 1;for (int j = 1; j < i; j++) {C[i][j] = C[i - 1][j - 1] + C[i - 1][j];}}while (cin >> m >> pre >> post) {int n = pre.size();// 记录后序遍历中每个字符的位置for (int i = 0; i < n; i++) {posInPost[post[i] - 'a'] = i;}cout << dfs(0, n - 1, 0, n - 1) << '\n';}return 0;}
棋盘游戏
问题描述
有一个 6×6的棋盘,棋盘的每个位置上都有一个数值,现在有一个起始位置和终止位置,请找出一个从起始位置到终止位置代价最小的路径:
只能沿上下左右四个方向移动。
总代价是每走一步的代价之和。
每步(从 (a,b)到 (c,d))的代价是 (c,d)上的数值与其在 (a,b)上的状态的乘积。
初始状态为 1,每走一步,状态按如下公式变化:(走这步的代价mod4)+1。
输入格式
每组数据一开始为 6×6的矩阵,然后四个整数表示起始坐标和终止坐标。
横纵坐标均从 0 开始,矩阵的左上角为 (0,0),右下角为 (5,5)。
输出格式
输出最小代价。
数据范围
矩阵内数值的取值范围 [1,10]。
输入样例
1 1 1 1 1 1
1 1 1 1 1 1
1 1 1 1 1 1
1 1 1 1 1 1
1 1 1 1 1 1
1 1 1 1 1 1
0 0 5 5
输出样例
23
思考
把每个位置和当前状态一起看成一个点,即状态为:(x, y, state)
其中 state ∈ {1,2,3,4},共 6×6×4=144 个状态。
每一步转移:从(x,y) 走向上下左右相邻格子 (nx,ny);
代价为:g[ny][nx] * state;
新状态为:(代价 % 4) + 1;
边权均为正,因此使用 Dijkstra 最短路 即可。
最终答案是到达终点 (tx,ty) 的任意状态中的最小总代价。
代码
#include<bits/stdc++.h>using namespace std;struct Node {int x, y; // x 表示列,y 表示行int st; // 当前状态 1~4int d; // 当前总代价bool operator>(const Node &o) const {return d > o.d;}};intmain(){ios::sync_with_stdio(false);cin.tie(nullptr);int g[6][6];while (cin >> g[0][0]) {for (int i = 0; i < 6; i++) {for (int j = 0; j < 6; j++) {if (i == 0 && j == 0) continue;cin >> g[i][j];}}int sx, sy, tx, ty;cin >> sx >> sy >> tx >> ty;// 输入坐标是 (行,列)// 代码内部 x 表示列,y 表示行,所以交换swap(sx, sy);swap(tx, ty);int dist[6][6][5];memset(dist, 0x3f, sizeof(dist));// 初始状态为 1,总代价为 0dist[sy][sx][1] = 0;priority_queue<Node, vector<Node>, greater<Node>> pq;pq.push({sx, sy, 1, 0});int ans = INT_MAX;int dx[4] = {1, -1, 0, 0}; // 列方向int dy[4] = {0, 0, 1, -1}; // 行方向while (!pq.empty()) {Node cur = pq.top();pq.pop();int x = cur.x;int y = cur.y;int st = cur.st;int d = cur.d;if (d != dist[y][x][st]) continue;if (x == tx && y == ty) {ans = d;break;}for (int k = 0; k < 4; k++) {int nx = x + dx[k];int ny = y + dy[k];if (nx < 0 || nx >= 6 || ny < 0 || ny >= 6) continue;// 从 (x,y) 走到 (nx,ny)// 注意这里 ny 是行,nx 是列int cost = g[ny][nx] * st;int ns = (cost % 4) + 1;int nd = d + cost;if (nd < dist[ny][nx][ns]) {dist[ny][nx][ns] = nd;pq.push({nx, ny, ns, nd});}}}cout << ans << '\n';}return 0;}
后缀子串排序
问题描述
对于一个字符串,将其后缀子串进行排序。
例如 grain 其子串有: grain rain ain in n。
然后对各子串按字典顺序排序,即: ain grain in n rain。
输入格式
一行,一个由小写字母构成的字符串。
输出格式
将排好序的子串依次输出,每行输出一个。
数据范围
输入字符串长度不超过 1000。
输入样例
grain
输出样例
ain
grain
in
n
rain
思考
直接枚举所有起点,用 s.substr(i) 得到所有后缀,然后调用 sort 按字典序排序,最后逐行输出即可。
输入长度不超过 1000,直接使用字符串排序完全可以通过。
代码
#include<bits/stdc++.h>using namespace std;intmain(){ios::sync_with_stdio(false);cin.tie(nullptr);string s;cin >> s;int n = s.size();vector<string> v;// 生成所有后缀子串for (int i = 0; i < n; i++) {v.push_back(s.substr(i));}// 按字典序排序sort(v.begin(), v.end());// 每行输出一个for (const string &t : v) {cout << t << '\n';}return 0;}
数组划分
问题描述
一个数组中有若干正整数,将此数组划分为两个子数组,使得两个子数组的各元素之和 a,b的差最小。
输入格式
共一行,包含若干个正整数,表示给定数组。
输出格式
以降序的顺序,输出两个子数组的各元素之和。
数据范围
给定数组的元素个数范围 [2,1000]。
给定数组的元素取值范围 [1,1000000]。
输入样例
10 20 30 10 10
输出样例
40 40
思考
当总和很大(如 10^9)时,half/64 约等于 7.8×10^6个 word,每个元素都要遍历全部 word,1000 个元素就是 7.8×10^9次操作,无法在时限内完成。
优化:
gcd 归一化
把所有元素和 half 同时除以所有元素的公因数 g。如果数据中元素有较大的公因数,target 会大幅缩小。
过滤大于 half 的元素大于一半总和的元素不可能出现在较小和的子集中,直接从 DP 中移除。
把相同值的多个元素合并成少数几个打包物品(如 5 个值为 3 的物品变成 3, 6, 12),大幅减少物品数量。
当物品数 ≤ 40 时,使用折半枚举:分别枚举前后两半的所有子集和,排序后二分匹配。复杂度约 O(2^20log),非常快。
动态宽度 bitset,维护 maxBit = 当前可达到的最大和,bitset 只处理到 maxBit 范围。这样在处理小元素阶段只操作很少的 word。
超 target 位清理,每次更新后清除超过 target 的位,避免污染结果。
代码
#pragma GCC optimize("O3")#pragma GCC optimize("unroll-loops")#include<bits/stdc++.h>using namespace std;typedef unsigned long long ull;intmain(){ios::sync_with_stdio(false);cin.tie(nullptr);vector<long long> a;long long x;while (cin >> x) a.push_back(x);long long total = 0;for (auto v : a) total += v;long long half = total / 2;// 1) gcd 归一化long long g = 0;for (auto v : a) g = __gcd(g, v);// 2) 过滤掉 > half 的元素(它们必然属于较大一侧)vector<long long> usable;for (auto v : a) {if (v <= half) usable.push_back(v / g);}long long target = half / g;if (usable.empty() || target == 0) {cout << total << ' ' << 0 << '\n';return 0;}long long usableSum = 0;for (auto v : usable) usableSum += v;if (usableSum < target) target = usableSum;// 3) 二进制分组(合并相同值,减少物品数)sort(usable.begin(), usable.end());vector<long long> items;int i = 0, n = usable.size();while (i < n) {int j = i;while (j < n && usable[j] == usable[i]) j++;long long cnt = j - i;long long v = usable[i];long long k = 1;while (cnt >= k) {items.push_back(v * k);cnt -= k;k <<= 1;}if (cnt > 0) items.push_back(v * cnt);i = j;}// 过滤超大的物品{vector<long long> t;for (auto v : items) if (v <= target) t.push_back(v);items = t;}sort(items.begin(), items.end());int m = items.size();long long best = 0;if (m <= 40) {// 4a) meet in the middleint h = m / 2;int nL = h, nR = m - h;vector<long long> L, R;L.reserve(1LL << nL);R.reserve(1LL << nR);for (long long mask = 0; mask < (1LL << nL); mask++) {long long s = 0;for (int b = 0; b < nL; b++)if (mask >> b & 1) s += items[b];if (s <= target) L.push_back(s);}for (long long mask = 0; mask < (1LL << nR); mask++) {long long s = 0;for (int b = 0; b < nR; b++)if (mask >> b & 1) s += items[h + b];if (s <= target) R.push_back(s);}sort(L.begin(), L.end());sort(R.begin(), R.end());for (auto l : L) {long long rem = target - l;auto it = upper_bound(R.begin(), R.end(), rem);if (it != R.begin()) {--it;best = max(best, l + *it);}}} else {// 4b) bitset DP,动态宽度int maxBit = 0;vector<ull> dp(target / 64 + 2, 0);dp[0] = 1;for (long long v : items) {if (v > target) continue;int newMax = (int)min((long long)maxBit + v, target);int needW = newMax / 64 + 1;if (needW > (int)dp.size()) dp.resize(needW, 0);int curW = needW;int ws = (int)(v / 64);int bs = (int)(v % 64);if (bs == 0) {for (int k = curW - 1; k >= ws; k--) {dp[k] |= dp[k - ws];}} else {for (int k = curW - 1; k > ws; k--) {dp[k] |= (dp[k - ws] << bs) | (dp[k - ws - 1] >> (64 - bs));}if (ws < curW) {dp[ws] |= dp[0] << bs;}}// 清理超出 target 的位int tw = target / 64, tb = target % 64;if (tw < curW) {if (tb != 63) {dp[tw] &= (1ULL << (tb + 1)) - 1;}for (int k = tw + 1; k < curW; k++) dp[k] = 0;}maxBit = newMax;}for (int k = target; k >= 0; k--) {if ((dp[k / 64] >> (k % 64)) & 1) {best = k;break;}}}long long bVal = best * g;long long aVal = total - bVal;if (aVal < bVal) swap(aVal, bVal);cout << aVal << ' ' << bVal << '\n';return 0;}
阶乘的末尾0
问题描述
给定一个整数 n,求 n的阶乘末尾连续 0的个数。
输入格式
一个整数 n。
输出格式
一个整数,表示 n的阶乘末尾连续 0的个数。
数据范围
1≤n≤10^9
输入样例
5
输出样例
1
思考
n! 末尾连续 0 的个数,取决于 n! 中因子 10 的个数,而:
10=2×5
在阶乘中,因子 2 的数量远多于因子 5,因此只需要统计 n! 中因子 5 的个数。
公式为:
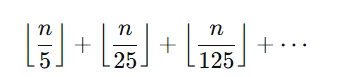
代码
#include<bits/stdc++.h>using namespace std;intmain(){ios::sync_with_stdio(false);cin.tie(nullptr);long long n;cin >> n;long long ans = 0;// 统计 n! 中因子 5 的个数while (n > 0) {n /= 5;ans += n;}cout << ans << '\n';return 0;}