

如果你是数据业务人员,每天最怕的就是多类数据开发工具零散割裂、实时离线任务管理混乱,数据源接入繁琐,跨系统数据流转需要多平台来回切换。
业务场景:每天既要处理交易流水实时对账、又要跑每日离线报表,还要对接十多类异构数据库,工具分散、运维复杂,问题定位耗时漫长。 |
AIIData数据中台分2篇解析这6大功能,看整套数据开发平台如何一站式解决这个老问题!现在先看实时开发IDE、实时开发平台、离线开发平台解析。
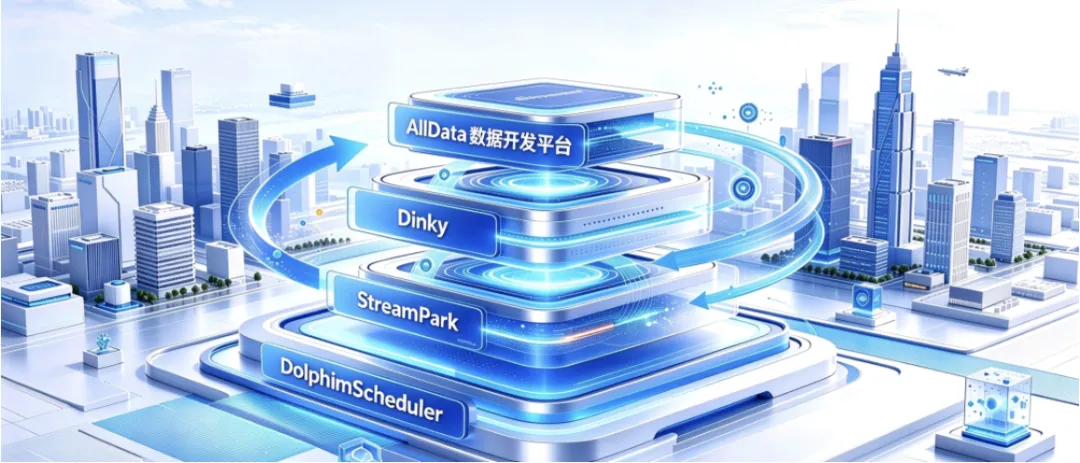
数据开发平台模块,6大功能拆解 |
注:离线开发IDE(AirFlow)、可视化数据开发(NIFI)和数据中枢平台(DataCap)在数据开发平台(二) 中介绍。
一、实时开发IDE (Dinky)
实时开发IDE基于Dinky构建,是AllData数据中台内置、面向Apache Flink的Web一站式实时计算平台。浏览器直接访问,低代码完成实时任务开发调试、发布与运维监控,统一纳管数据源、集群、告警与权限,支持实时同步、流式计算、数据血缘,降低Flink使用门槛,支撑IoT、实时监控、风险预警场景。
Dinky开源项目:https://github.com/DataLinkDC/dinky
Dinky文档地址:https://www.dinky.org.cn
1、轻量化Web低代码IDE,降低Flink实时开发门槛
浏览器开箱即用,采用B/S架构,无需本地安装客户端与部署复杂开发环境,统一账号鉴权,上手快。IDE内置 SQL智能提示、自动补全、语法校验、智能纠错。
支持可视化逻辑编排,大幅减少代码编写工作量;配套行业预配置解决方案包,仅修改业务参数,即可快速搭建实时监控、数据同步业务;同时支持在线数据预览、即席查询,开发调试阶段直观查看实时数据结果,业务人员也可参与实时任务搭建。
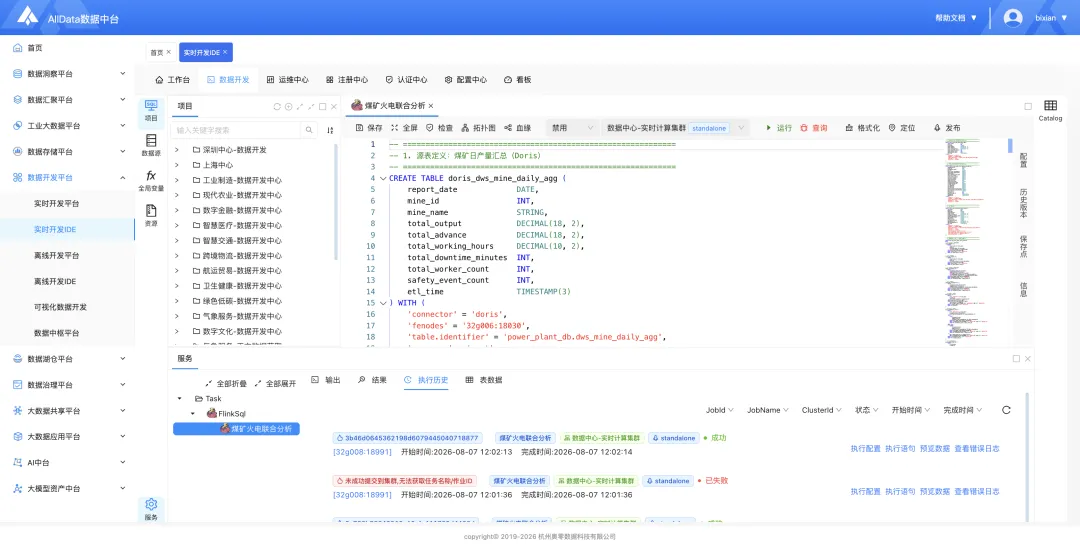
数据开发页面:浏览器端Web IDE开箱即用,内置SQL智能辅助与可视化能力,支持在线编写、调试Flink SQL并预览实时数据,业务人员也能参与实时任务搭建
2、全生命周期任务管控+企业级中台生态集成,保障稳定落地
覆盖实时任务开发-测试-发布-监控-优化完整闭环,运维中心统一管理全部实时作业,可查看任务状态、运行日志、资源消耗、SQL数据血缘;支持任务版本管理与一键回滚,一键诊断自动识别性能瓶颈并输出优化建议;内置完整告警体系,支持自定义告警策略,依托Savepoint/Checkpoint状态管理保障故障可恢复,提升业务稳定性。
平台内置注册中心与企业级权限体系,统一纳管 Flink 集群、数据源、UDF、资源,数据源一次注册多任务复用;支持UDF自定义函数、资源包与Git托管,扩展计算能力;支持多租户、角色、行级权限、API令牌管控,满足集团分级隔离;
可与AllData中台组件打通,实时结果输出至Doris、IoTDB、RustFS等存储,无缝融入企业数据中台,构建端到端数据链路。
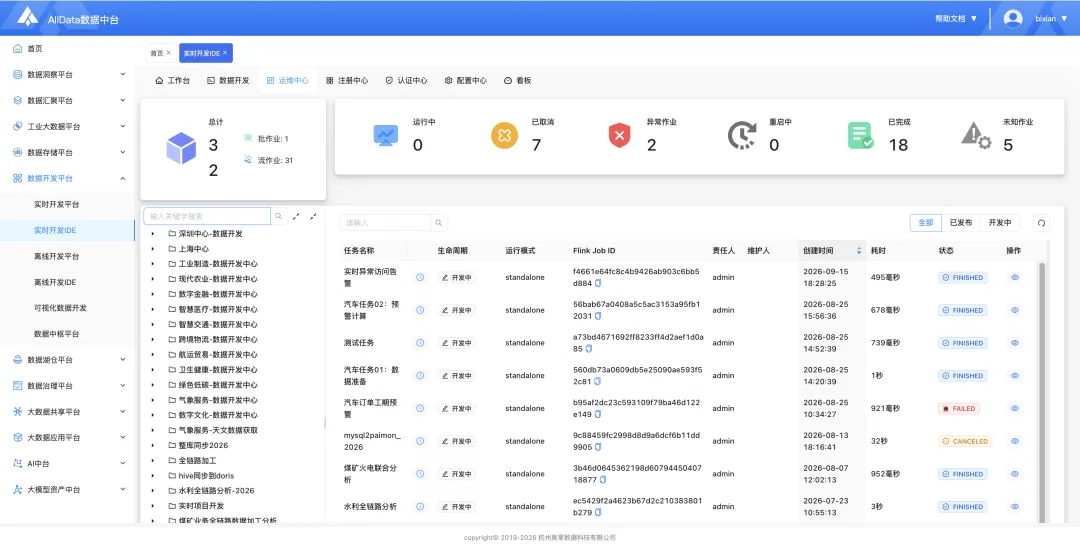
运维中心页面:运维中心集中管理全部Flink实时作业,统一展示任务运行状态、统计大盘,一站式承载任务发布、监控、异常告警全流程
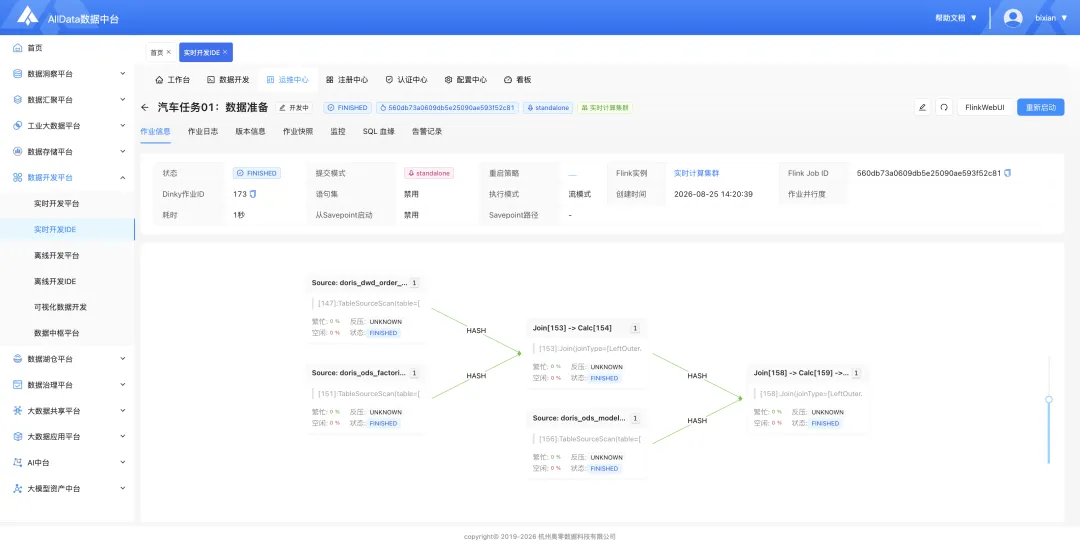
运维详情页面:单任务详情页可查看作业基础信息、SQL执行血缘链路,支持性能诊断、Savepoint状态管理,快速定位数据流转与任务瓶颈
二、实时开发平台 (StreamPark)
实时开发平台把复杂的流批计算技术封装,实现实时任务快速开发、智能化运维、企业级安全治理,帮助业务快速拿到实时数据洞察,保障生产级实时业务稳定运行。
1、可视化低代码实时开发,降低实时计算落地门槛
基于Web端IDE实现 “搭积木” 式实时任务开发,支持Flink/Spark SQL在线编写、语法校验与调试预览,无需复杂本地环境;通过可视化配置即可快速搭建实时流计算任务,业务人员也可参与业务开发,有效缩短实时项目交付周期。
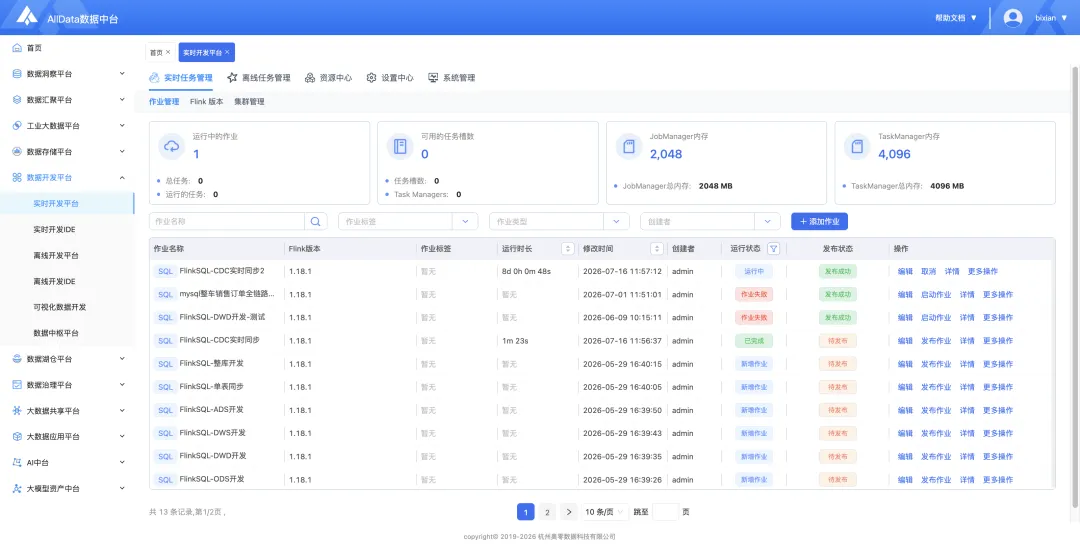
实时任务管理页面:实时任务管理页集中展示 Flink 实时作业资源指标与任务清单,可对实时作业进行编辑、启停、状态查看等统一管控
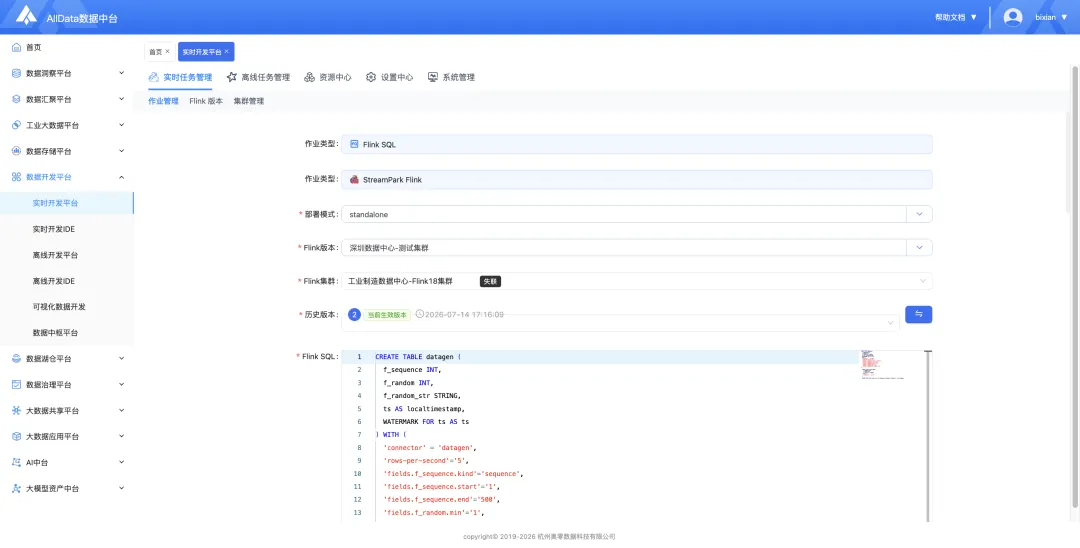
实时任务详细页面:支持在线配置Flink集群、部署模式与版本,编写Flink SQL脚本,快速完成实时计算作业的开发配置
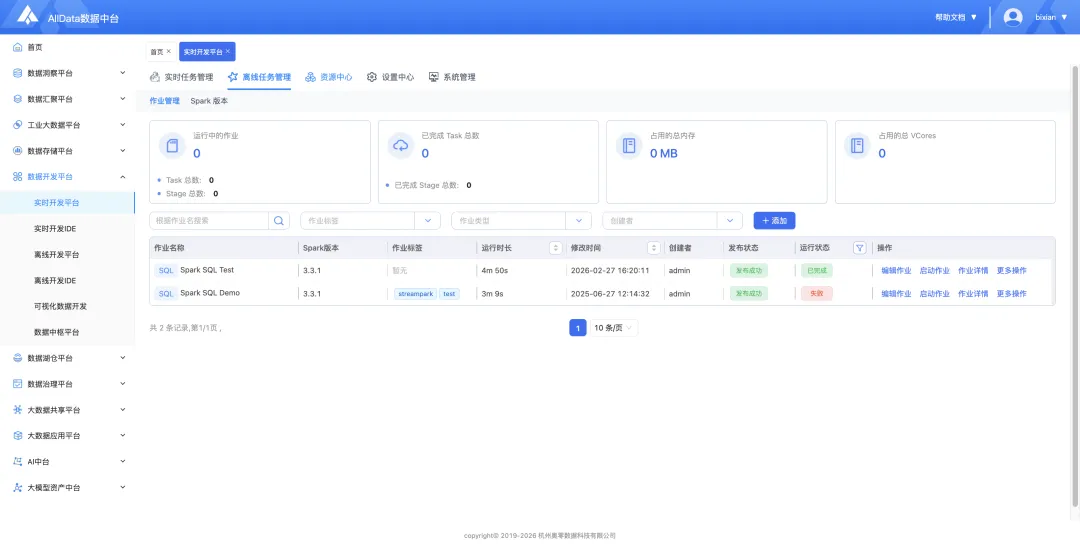
离线任务管理页面:离线任务管理页统一纳管Spark离线作业,展示任务资源、运行状态列表,实现离线任务集中运维
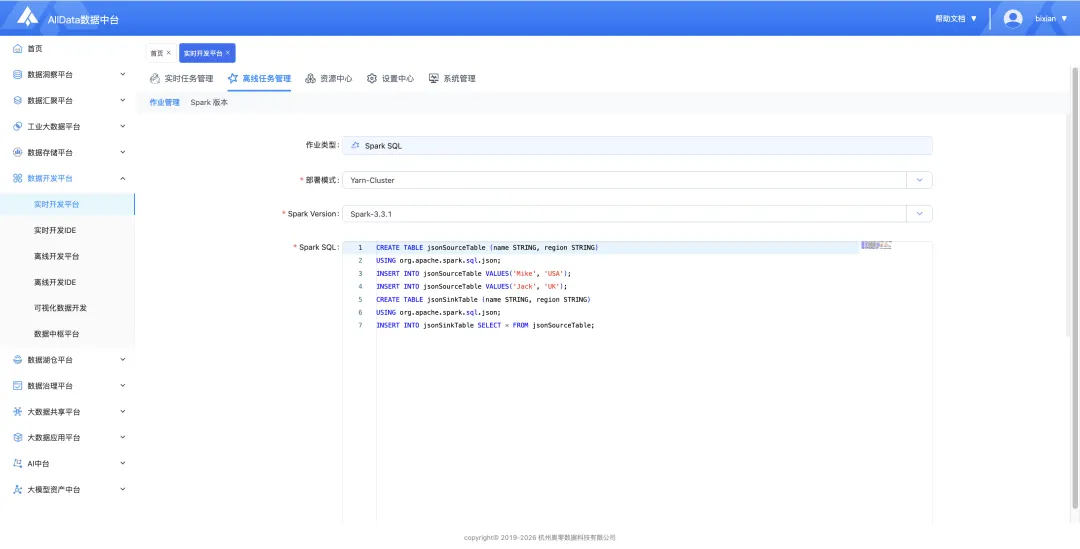
离线任务详情页面:支持选择Yarn等部署模式与Spark版本,在线编写Spark SQL,完成离线计算任务开发
2、全生命周期智能运维管控,保障实时业务稳定运行
覆盖实时作业开发‑发布‑监控‑告警‑故障恢复完整闭环,支持任务版本管理、一键回滚、数据血缘溯源;具备故障自愈、弹性伸缩、多渠道告警能力,同时配套企业级多租户、权限、资源管理,适配生产环境7×24小时稳定运行要求。
三、离线开发平台 (DolphinScheduler)
离线开发平台基于Apache DolphinScheduler构建,面向大批量周期性离线数据处理调度模块。支持多数据源接入,可视化拖拽编排工作流;
定时 + 依赖调度自动执行任务,配套监控、告警、失败重跑、版本回滚、审计日志,多租户细粒度权限管控,完成数据清洗、同步、周期加工,稳定产出离线数据支撑业务分析。
DolphinScheduler开源项目:https://github.com/apache/DolphinScheduler
DolphinScheduler文档地址:https://dolphinscheduler.apache.org/zh-cn/docs/3.2.1/guide/homepage
1、可视化工作流编排,快速构建离线处理流程
支持拖拽式零/低代码搭建数据处理工作流,可对接多类型异构数据源,可视化配置任务依赖关系,快速完成离线数据的抽取、清洗、同步与周期性加工开发。
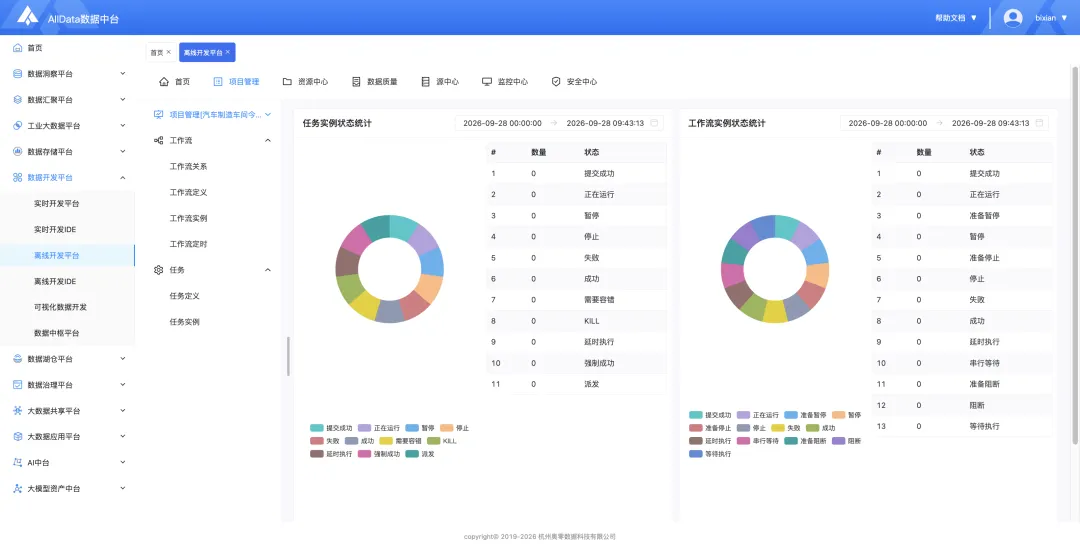
离线项目管理页面:离线开发平台首页提供任务实例、工作流实例的运行状态统计大盘,直观展示各类任务运行情况,便于运维人员整体监控项目任务
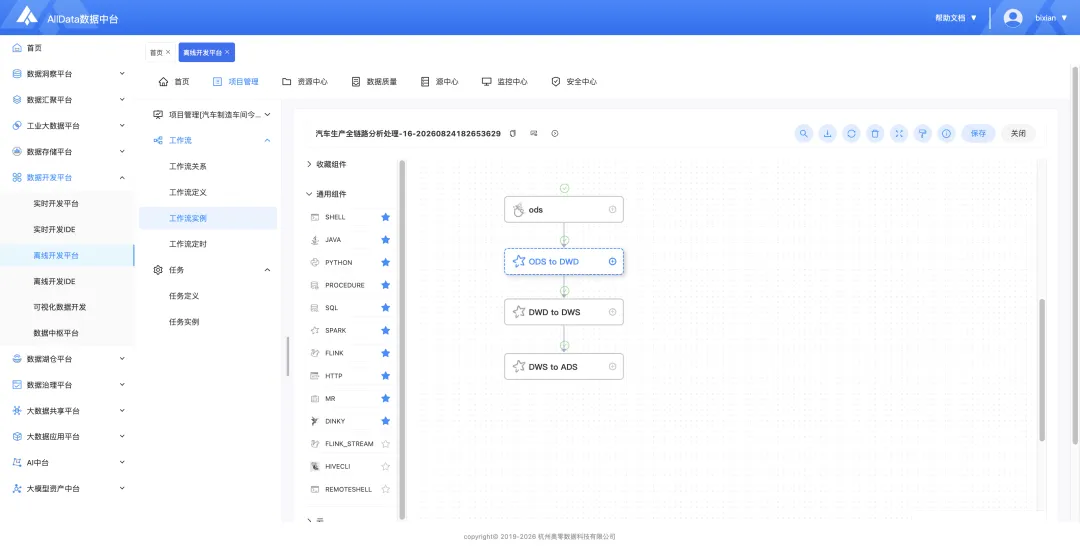
工作流详细页面:可视化画布支持拖拽组件搭建ODS-DWD-DWS-ADS分层数据加工链路,配置节点上下游依赖,快速构建离线数据处理工作流
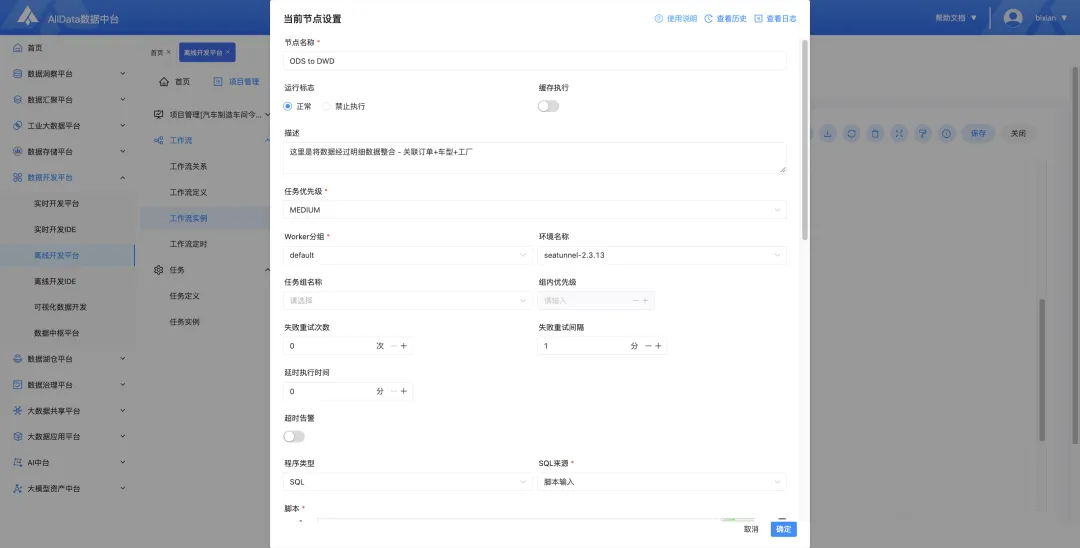
工作流节点设置弹窗:支持对工作流节点进行精细化参数配置,可设置任务优先级、失败重试、超时告警、脚本内容等,灵活管控单任务执行策略
2、分布式智能调度与全链路运维管控
支持定时触发、任务依赖联动自动调度,提供任务运行监控、异常告警、失败重试、历史数据重跑与版本回滚能力,搭配多租户细粒度权限管控,保障大批量离线任务稳定可靠运行。
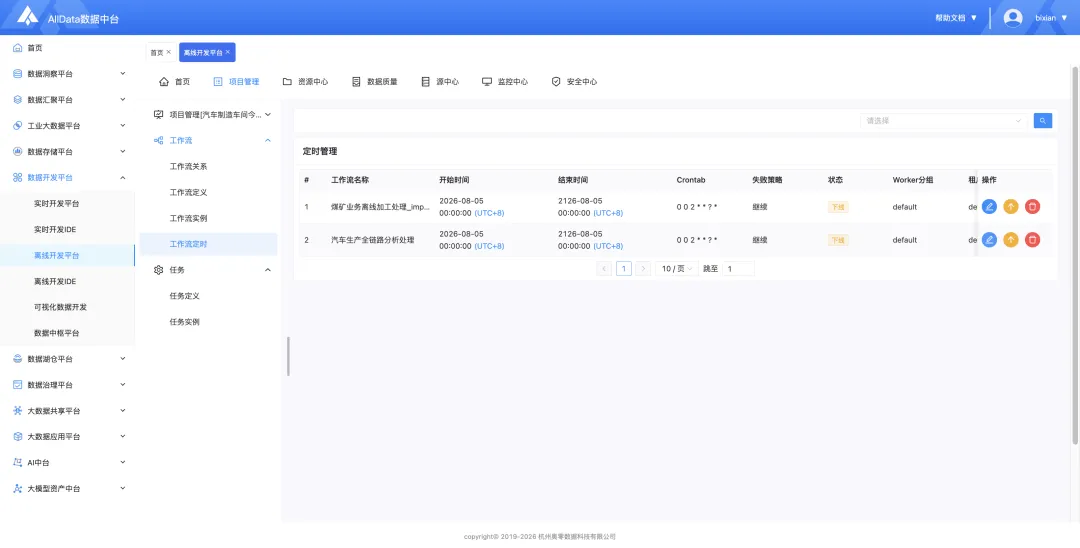
工作定时页面:工作流定时管理页面集中展示各业务工作流的定时调度信息,包含Crontab表达式、执行时段、失败策略与运行状态,支持对调度任务进行启停维护
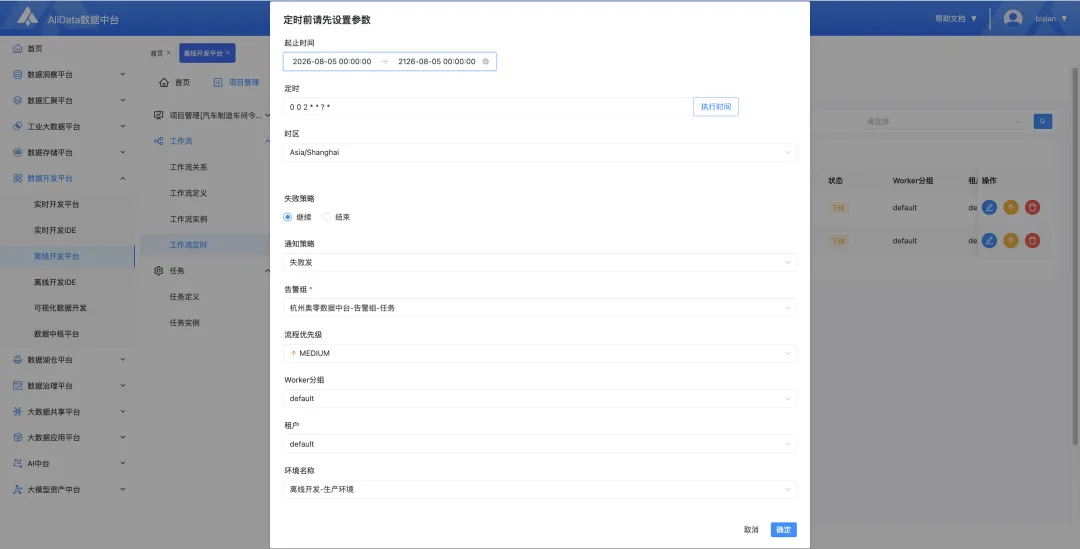
定时设置弹窗:支持配置工作流的起止执行时间、Crontab调度周期、失败处理策略、告警分组、资源分组与运行环境,完成离线工作流定时调度规则定义
3大功能核心定位与场景选型 |
1、实时开发IDE (Dinky)
核心定位:专注Flink任务编写、调试、运维、参数管理,轻量实时任务开发工作台,支持FlinkCDC。
适合场景:需要写Flink SQL实时计算,开发调试实时流任务;小批量、高频迭代实时开发;实时任务快速排错。
汽车制造产线实时监控场景(场景举例):用Dinky编写FlinkSQL 读取产线设备IoT数据流,实时清洗、统计设备告警,快速调试SQL逻辑,实时产出设备状态指标。
核心定位:Flink全生命周期管理平台,侧重Flink集群、作业资源、版本、多集群运维管理,侧重大规模生产级 Flink 任务调度与运维。
适合场景:大规模Flink实时任务集群管理;多Flink集群、大量流作业运维;生产环境稳定长驻流任务,少频繁调试。
数字政务交易流水实时对账场景(场景举例):StreamPark托管上百个 Flink 长任务,统一管理资源、故障重启、版本发布,7×24小时不间断实时对账。
3、离线开发平台(DolphinScheduler)
核心定位:大数据离线工作流调度平台,负责离线任务编排、定时调度、依赖管理、告警,离线批任务运维中心。
适合场景:T+1离线数据加工;多任务依赖DAG编排;定时跑批、跨节点任务依赖;离线报表、数仓分层调度。
火电行业日指标统计场景(场景举例):每日凌晨调度DolphinScheduler,依次执行ODS→DWD→DWS离线任务,计算昨日发电、能耗指标,生成日报。
选型快速总结 |
▶ 写FlinkSQL、调试实时任务 → 选用Dinky
▶ 大规模生产 link集群运维管理 → 选用StreamPark
▶ 常规离线数仓DAG定时调度 → 选用DolphinScheduler


