

如果你问一个数据工程师或分析师,日常工作中最耗时的环节是什么?大概率不是写复杂的SQL,也不是调参跑模型,而是“找数据”。
AllData数据中台搭建统一数据源入口,所有数据从这里接入,支撑数仓分层建设,核心分为三大能力:
1、统一纳管:打破数据库壁垒,一个列表看清全域数据资产,让源头可寻、可管、可控。
2、智能问数:告别繁琐的SQL编写,用大白话就能“问”出数据答案,让业务人员也能自助分析。
3、模数共建:在接入阶段就对齐业务语义,让模型和数据“说同一种语言”,为下游数仓分层打下坚实的语义基础。
接下来我们将逐一拆解数据源平台、AI多模态数据库、模数共建数据源三个功能,如何成为你数仓分层的第一块基石。
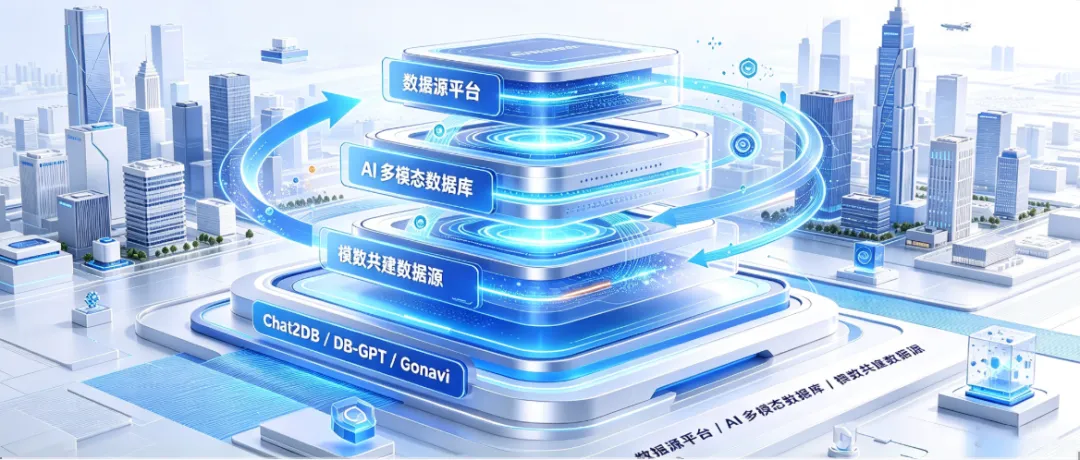
一、数据源平台 (Chat2DB)
数据源平台 (Chat2DB) 是异构数据统一接入与探查工作台,是ODS‑DWD‑DWS‑ADS数仓分层底座。解决数据源分散、配置繁琐、入口不统一、权限管控难问题,实现单页面统览全部数据资产。
Chat2DB项目地址:https://github.com/CodePhiliaX/Chat2DB
Chat2DB官方文档:https://chat2db-ai.com/resources/docs/start-guide/getting-started
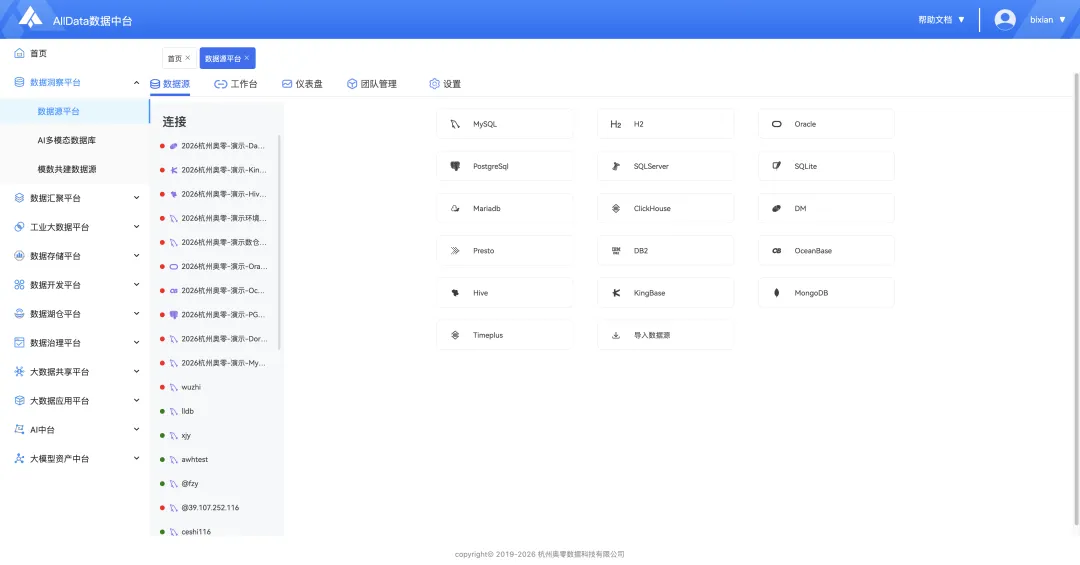
1、核心能力|极简式接入16+数据源,一键纳管全域数据
数据源管理支持16+类异构数据源一键接入,覆盖关系型数据库、国产信创数据库、数仓引擎等大类。平台内置各类数据库连接驱动,无需服务器手动部署驱动程序;填写连接信息、连通测试即可完成注册,集中查看各数据源在线/离线状态。
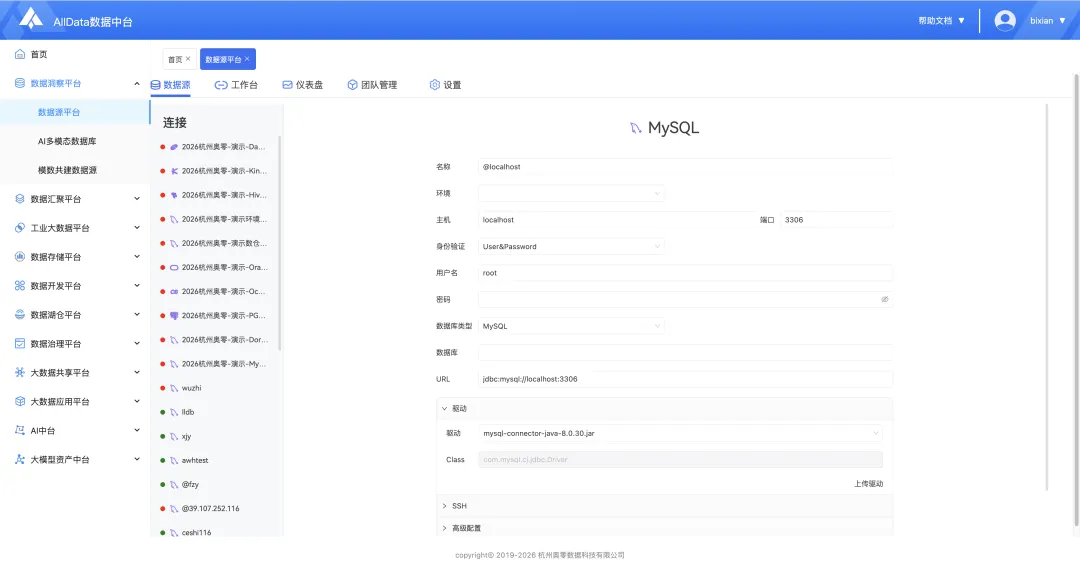
填写数据源连接信息(账号密码、主机等)
2、统一数据工作台:库表探查、SQL查询与AI自然语言问询
内置统一数据工作台,完成数据源接入后,无需切换第三方数据库客户端,即可在中台内完成全维度的数据探查与查询操作:
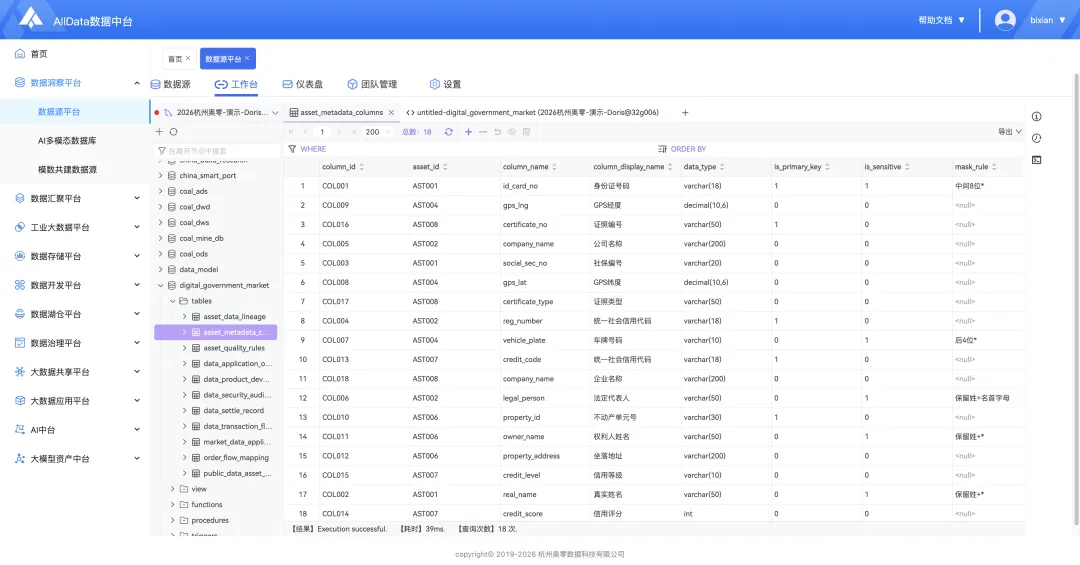
✅ 可浏览全部已授权数据源下的数据库、数据表,查看数据表字段结构、元数据信息,预览表内原始明细数据内容
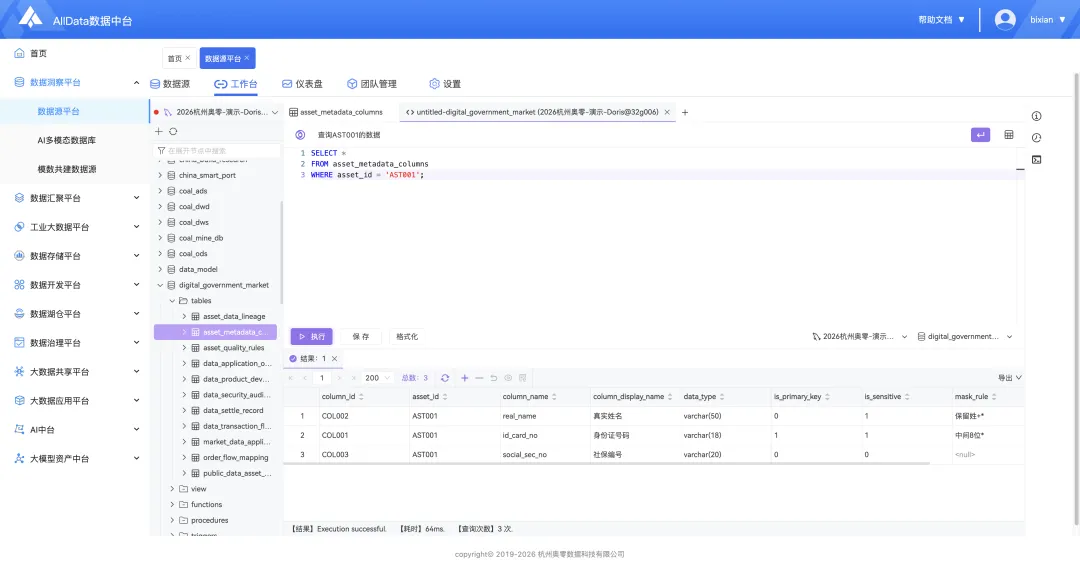
✅支持直接编写、执行SQL语句,完成数据筛选查询,支持预览、导出查询结果
✅支持在设置模块绑定AI大模型,配置完成后,除传统SQL查询之外,可直接使用自然语言完成库表数据问询分析
数据源列表与表结构预览界面
通过SQL语句或自然语句筛选数据精确搜索
3、清晰的数仓分层结构
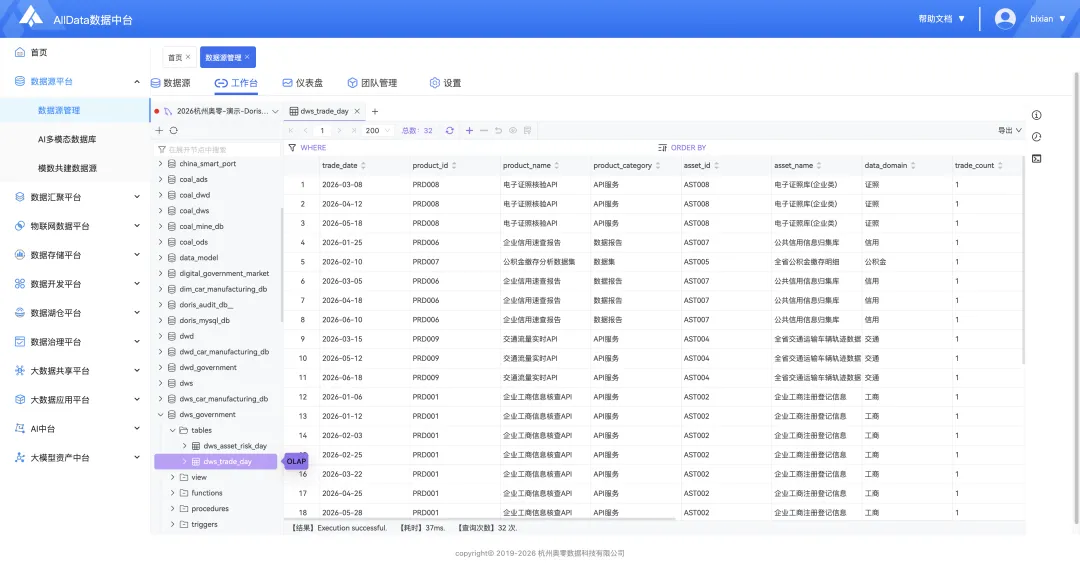
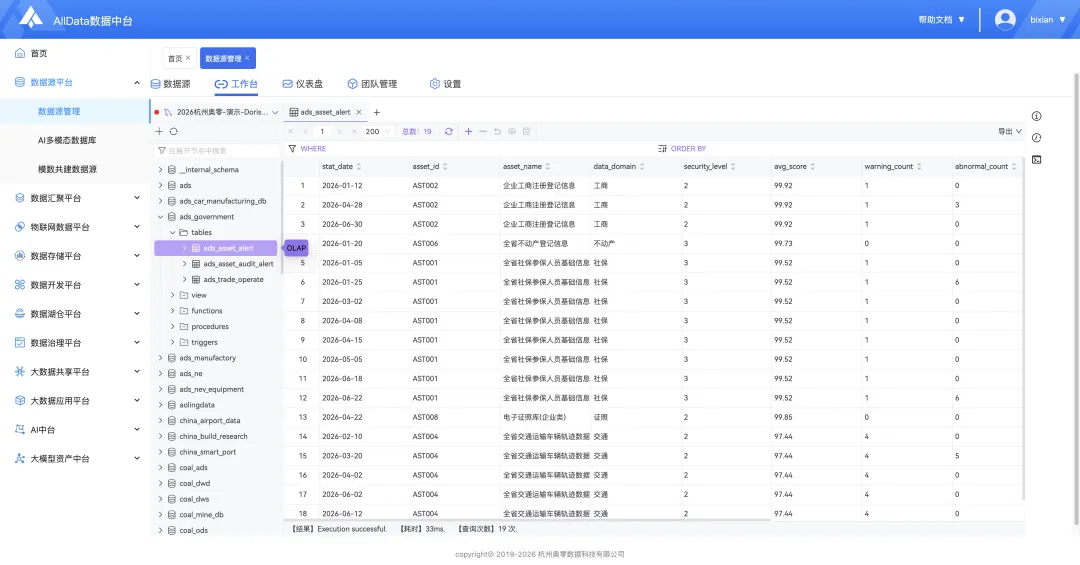
数据源管理 (Chat2DB) 同时作为全分层数仓的统一SQL查询工作台,一站式浏览、查询ODS/DWD/DWS/ADS 各分层库表,执行 SQL、预览导出数据,配套完整元数据查看能力。
✅ ODS原始数据层:存放外部业务镜像原始数据;外部异构数据源经过数据汇聚同步管道,完成结构映射后落地ODS层
✅ DWD明细数据层:明细清洗层,基于ODS层原始数据,通过Flink SQL完成离线/实时加工,实现数据标准化、脏数据清洗处理
✅ DWS汇总数据层:轻度聚合宽表,基于DWD明细数据,按照业务维度做聚合计算,优化查询性能,预生成业务指标
✅ ADS应用数据层:面向大屏、报表、业务告警的应用指标层,基于DWS汇总层做面向业务场景的二次加工
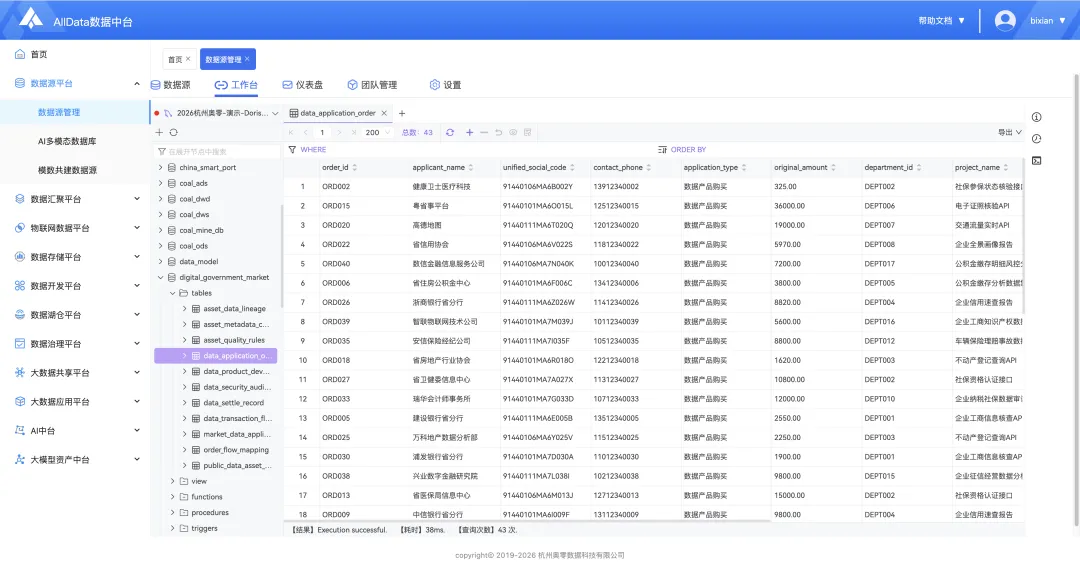
DWD明细数据层界面
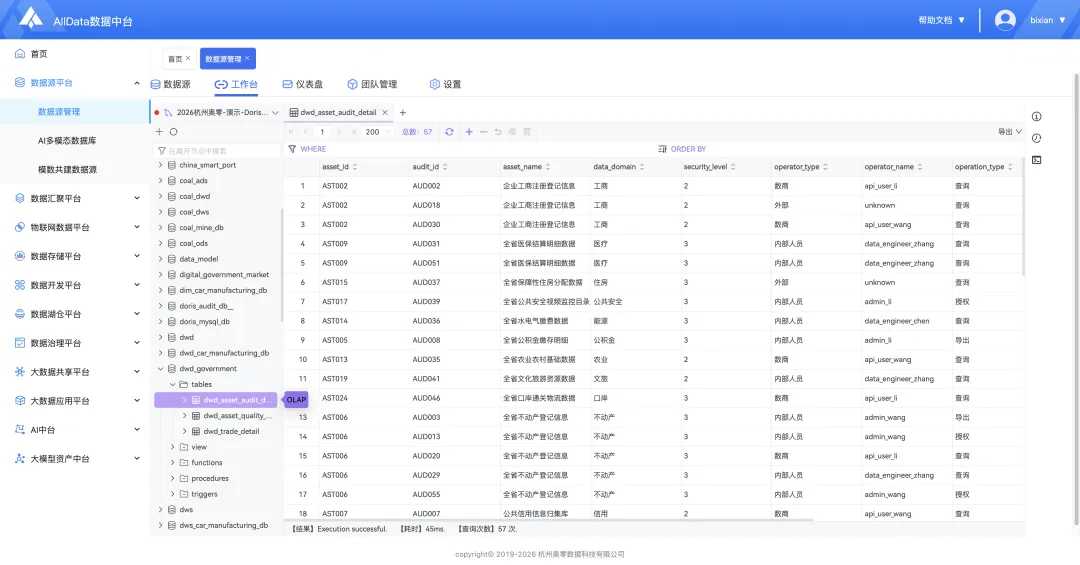
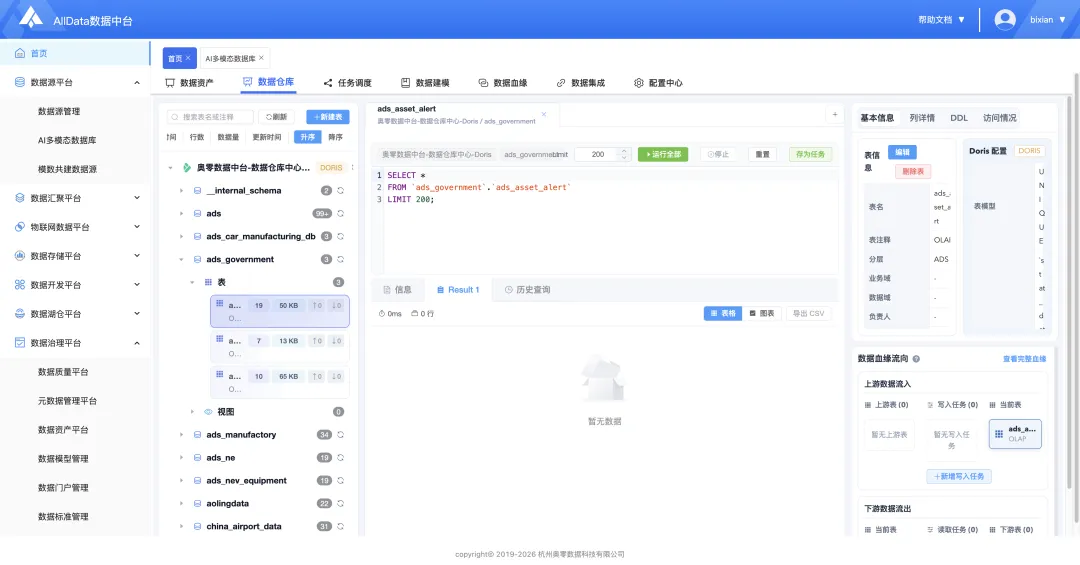
ADS应用数据层界面
二、AI多模态数据库(DB‑GPT)
AI多模态数据库(DB‑GPT)是 AllData 数据中台的智能数据交互入口,基于大模型框架实现自然语言对话式分析,将传统 “编写 SQL 取数” 升级为自然语言对话式数据分析。
DB-GPT 开源项目:https://github.com/eosphoros-ai/DB-GPT
DB-GPT 官方文档:http://docs.dbgpt.cn/docs/overview/
1、全域多模态数据接入能力
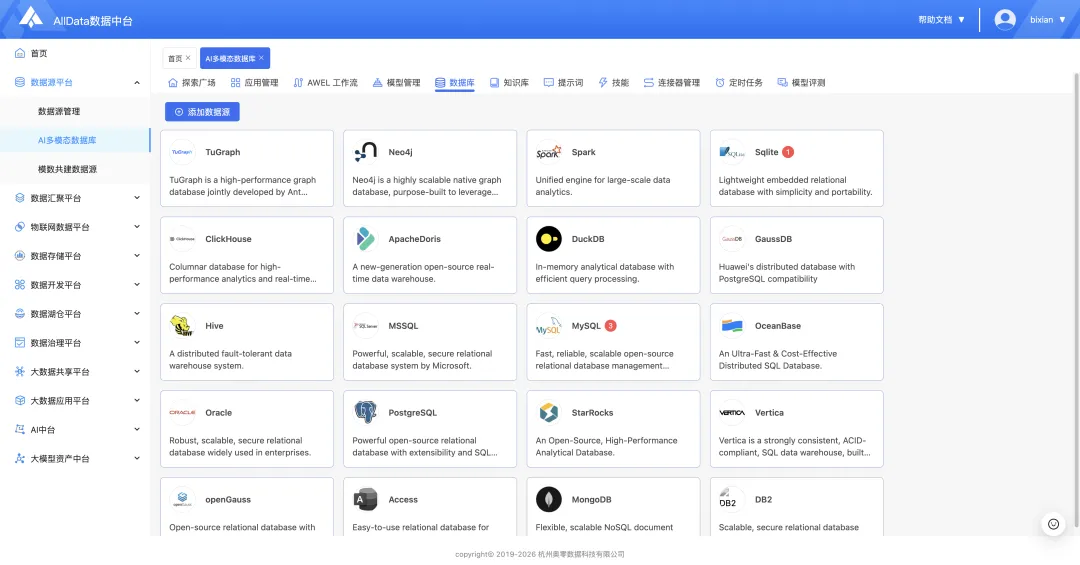
AI多模态数据库 (DB‑GPT) 实现26种数据源接入并通过自然语言对话式智能分析:
图数据库型数据源:TuGraph、Neo4j |
大数据 & OLAP 分析型数据源: Spark、Apache Doris、ClickHouse、DuckDB、GaussDB、Hive、StarRocks、Vertica |
关系型数据源: SQLite、MSSQL (SQL Server)、MySQL、OceanBase、Oracle、PostgreSQL、openGauss、Access、DB2 |
NoSQL 数据源: MongoDB、HBase、Redis、Cassandra、Couchbase |
元数据 & 知识分析数据源:Omc、Space |
多媒体资产说明:图片、音视频不能直接上传解析,需要经过多模态存储平台(RustFS)解析处理后,才可开展跨模态分析。
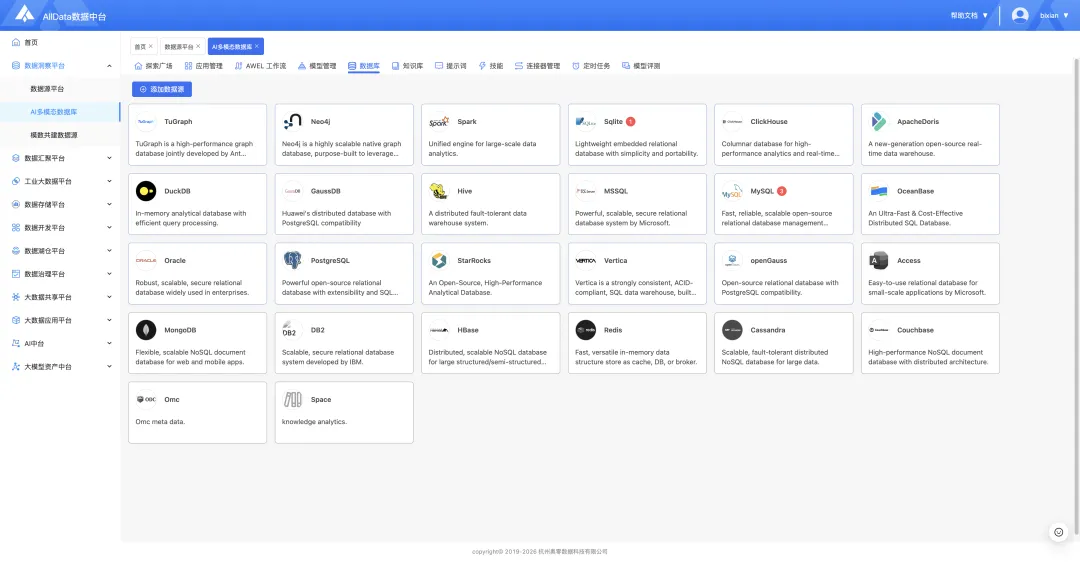
2、核心能力|多模态数据统一理解,自然语言驱动全链路智能分析
平台兼容结构化数据库,可直接绑定中台内已注册数据源。平台内置AI智能模型能力,业务人员无需掌握 SQL 语法,通过自然语言即可发起数据问询,系统自动解析生成可执行SQL并返回结果。
✅ 支持多源异构数据混合查询:同时关联业务库、文档知识库,实现跨结构化+非结构化数据联合分析
✅ 自动生成数据库资产画像:自动扫描库表生成资产画像,输出资产盘点文档私有化大模型兼容能力:兼容私有化国产大模型,数据内网闭环,满足信创与隐私要求
✅ 分析任务全链路留存复用:对话任务持久保存,支持复用迭代
✅ SQL只读沙箱安全隔离:只读沙箱环境执行,严格禁止写、改、删除类操作
✅ 分析结果可溯源校验:AI生成的底层SQL完整可查看,查询逻辑、数据来源可追溯
快捷连接多种异构源数据库,一次填写后续无需重复添加
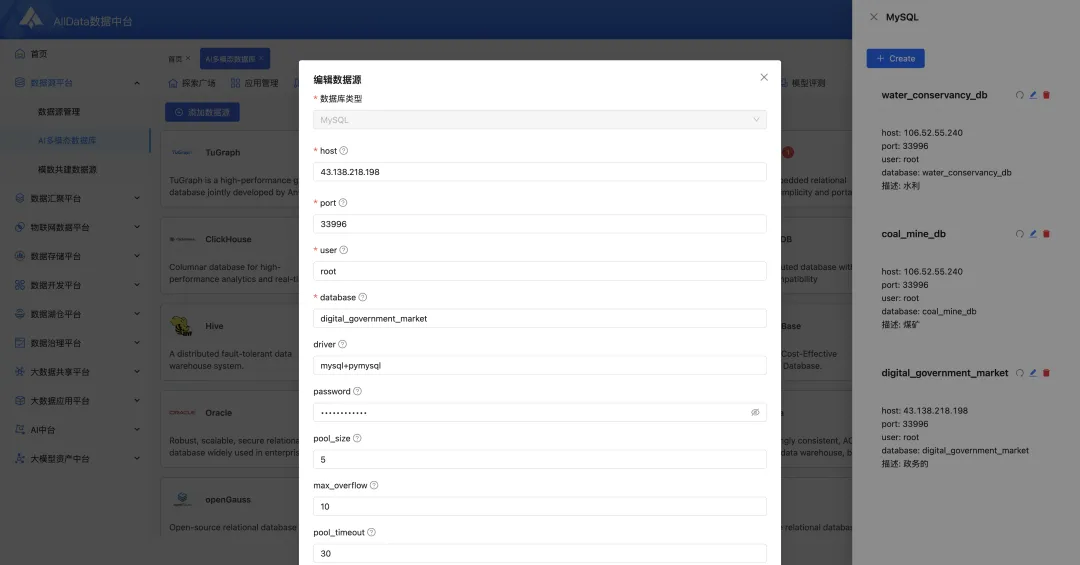
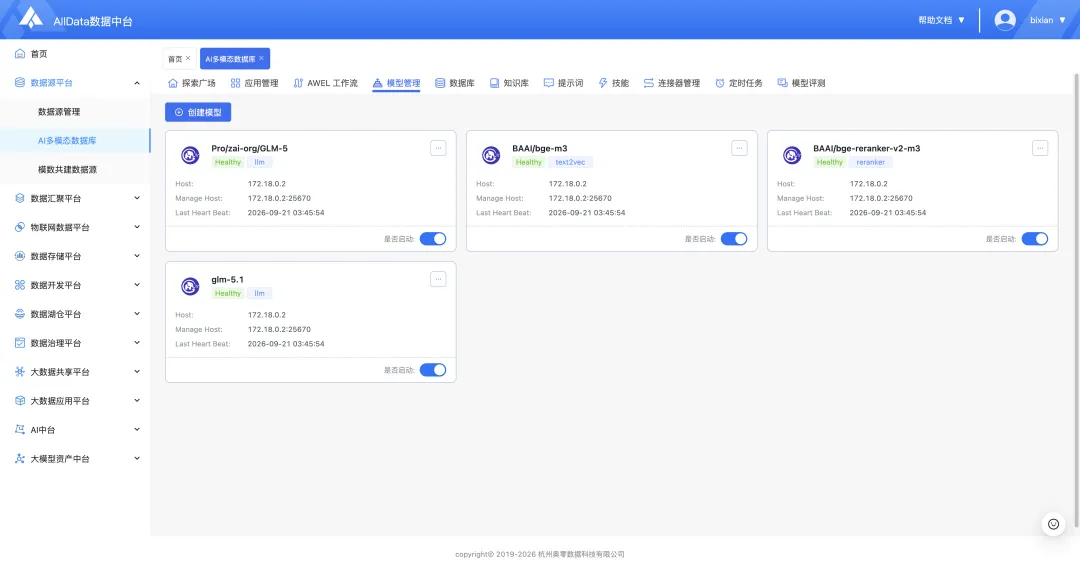
平台内置常用的AI模型提供选择使用,满足日常AI智能对话分析需求
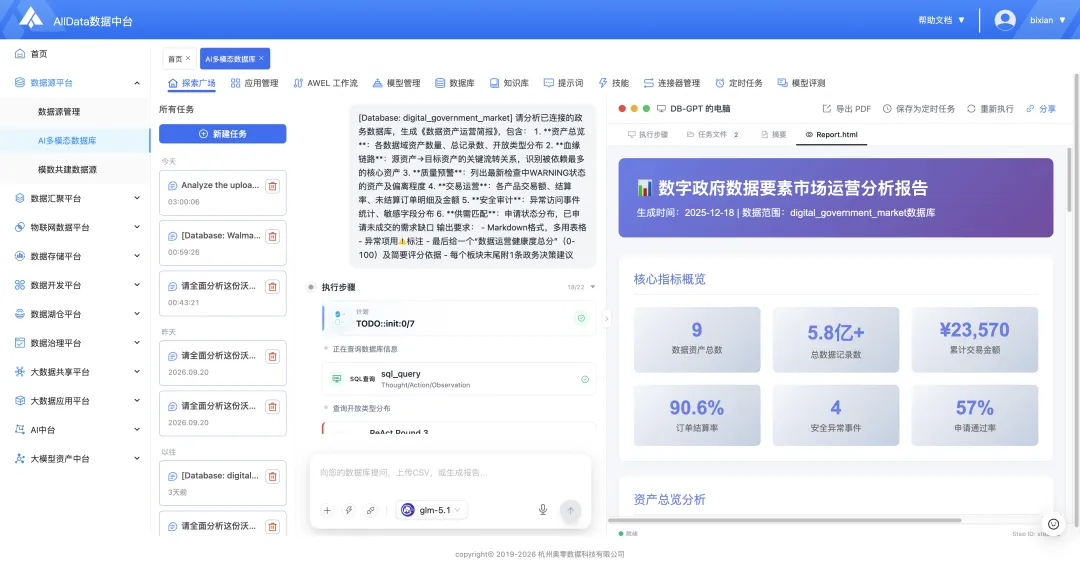
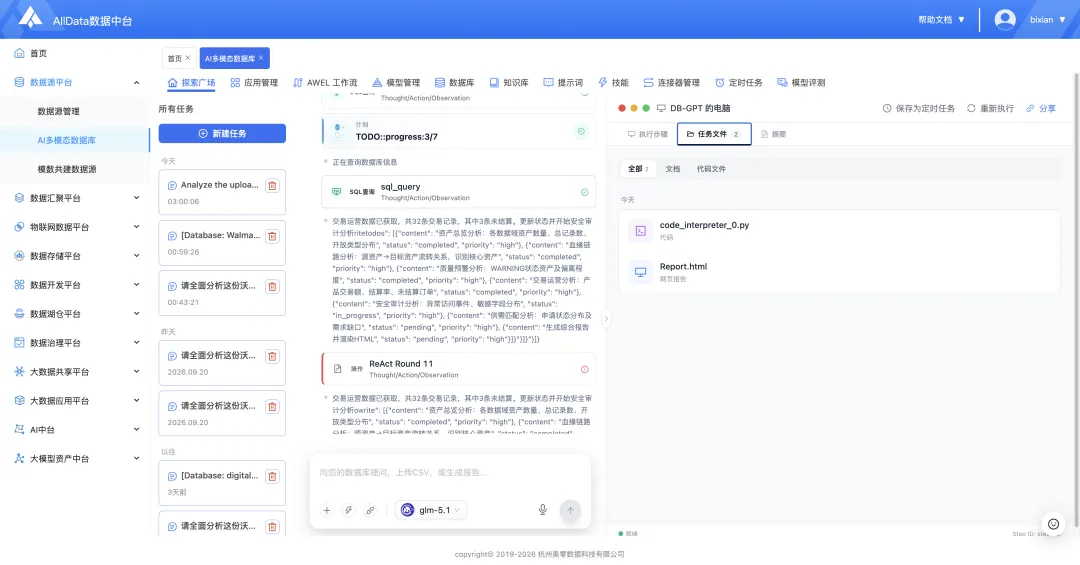
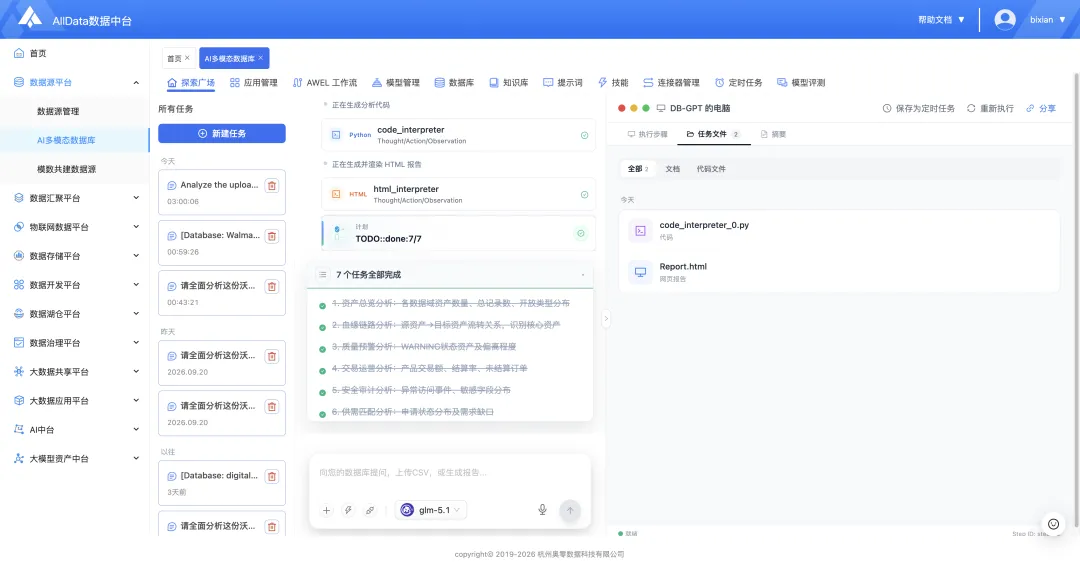
平台接收自然语言提问后,自动完成库表识别、生成并校验SQL,在沙箱安全环境完成查询计算、指标统计、图表绘制,一键输出交互式分析报告
3、灵活多变的分析方式
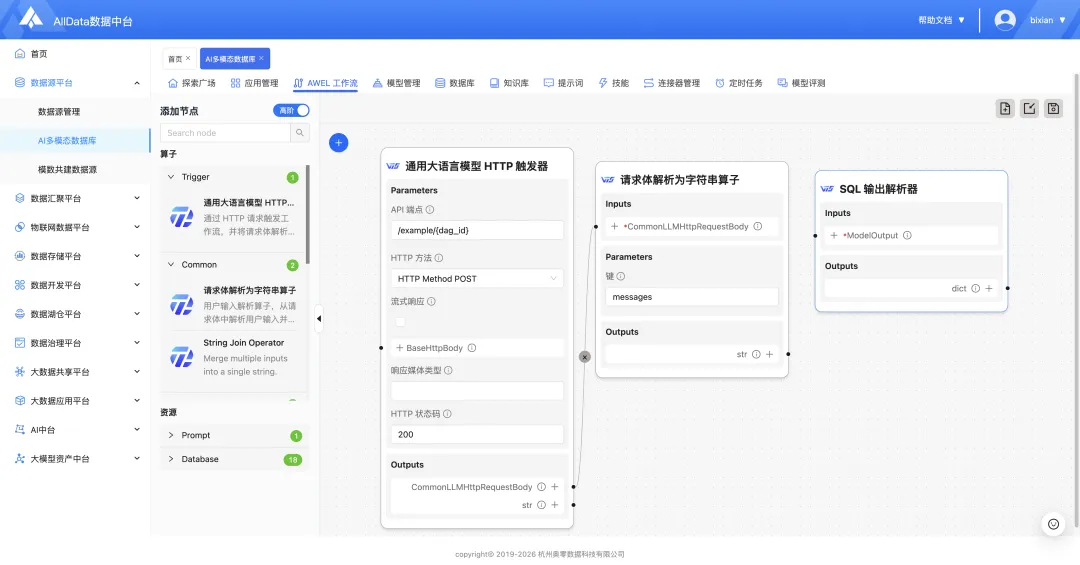
依托 AWEL 可视化工作流,编排复杂分析流程,封装行业领域技能,支持定时调度自动生成报告。
✅ 可视化编排复杂分析流程,支持设置定时调度、循环重复执行
✅ 沉淀行业标准化AI领域技能,实现常态化自动分析
✅ 任务可保存为定时任务,自动执行并产出分析结果与报告
业务示例:可封装煤矿设备运行指标周期性巡检任务,按日自动完成指标统计、异常识别并输出巡检分析报告。
4、数据库画像前置校验,多智能体分步可信分析
AI分析结果的可靠性是业务落地的关键。通过数据库画像前置认知+多智能体协作降低AI幻觉
✅ 数据库画像前置:提前扫描库表结构,基于真实表结构生成SQL,减少认错表、字段
✅ 数据库画像前置:提前扫描库表结构,基于真实表结构生成SQL,减少认错表、字段;知识库+提示词双引擎固化业务口径
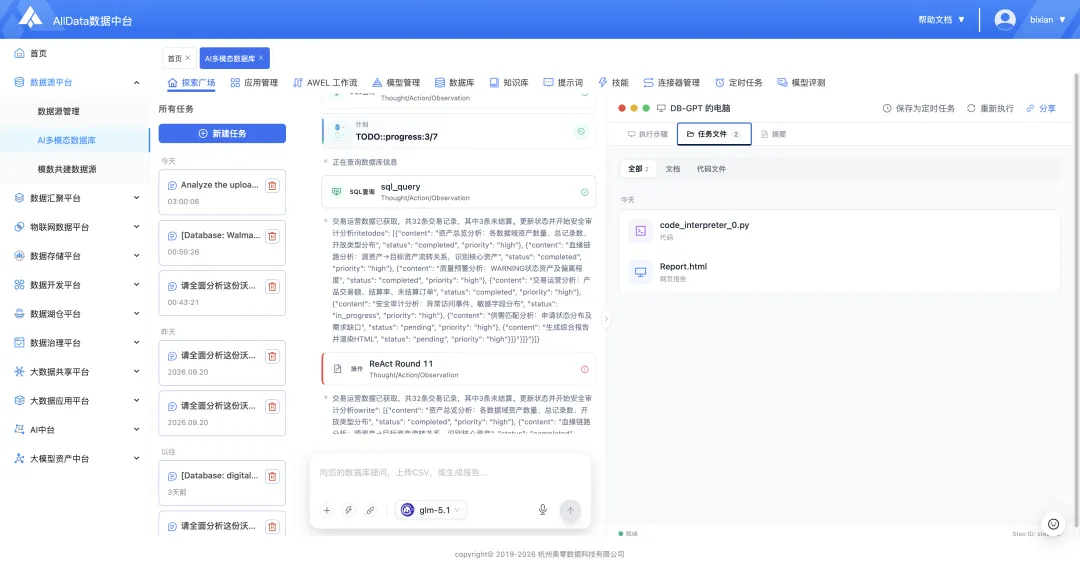
✅ 多智能体拆解复杂任务、分步校验:将复杂分析任务进行拆解,每一步均可回溯查看,用户可直接审阅原始SQL,判断计算口径是否合理
✅ 全链路执行过程可追溯:全链路对话、SQL、知识库引用记录完整留存
5、数据来源闭环纳管,全链路访问审计可控
在AllData数据中台体系内,业务数据需要先经过数据源平台 (Chat2DB) 完成数据源注册接入,构建统一数据底座;AI多模态数据库 (DB‑GPT) 仅消费底座内已接入的数据,用户可访问的数据范围由中台预先管控,杜绝越权访问未纳管数据。
✅ 数据源统一管控,分析范围预先锁定:所有可供AI查询的数据,均来自Chat2DB完成注册纳管的数据源,未注册数据源无法访问
✅ 复用中台统一权限体系,数据访问可控:DB‑GPT完整继承中台多租户、行级/列级权限、数据脱敏能力
✅ 查询资源防护:设置查询超时与资源限额,避免大查询冲击集群
数据源统一管控界面截图
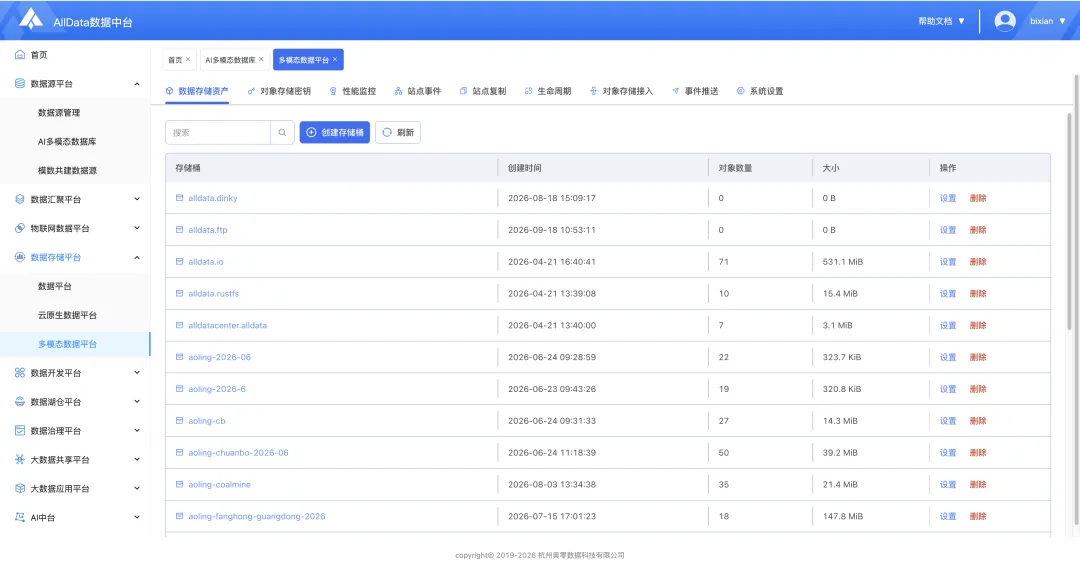
三、模数共建数据源 (GoNavi)
模数共建数据源 (GoNavi) 是业务建模、数据探查、比对校验、数据流转工作台。补齐特殊数据源接入能力,解决外部文件入中台、数据比对校验、临时表管理等痛点。
GoNavi 开源项目:https://github.com/Syngnat/GoNavi
GoNavi 官方文档:https://gonavi.org/zh/docs
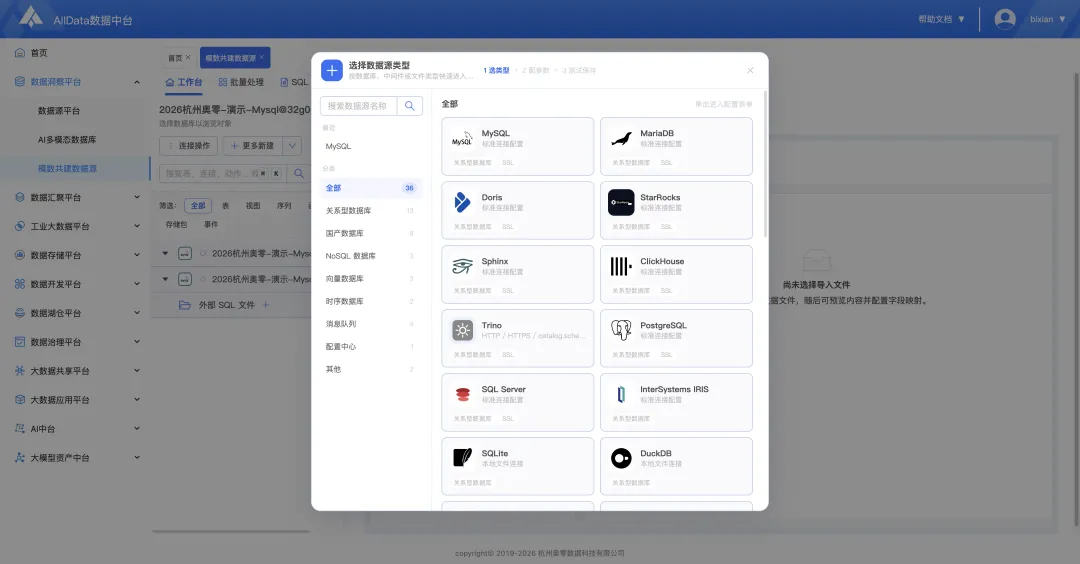
1、全域数据源接入:7大分类,31+类数据源兼容
平台覆盖7大数据源分类、支持31+种数据源接入,适配业务库、时序、消息、向量、国产信创库等多样化数据类型,完整数据源清单包含:
关系型数据库: MySQL、MariaDB、Doris、StarRocks、Sphinx、ClickHouse、Trino、PostgreSQL、SQL Server、InterSystems IRIS、SQLite、DuckDB、Oracle |
国产数据库: OceanBase、达梦Dameng、人大金仓Kingbase、瀚高HighGo、海量Vastbase、OpenGauss、GaussDB、GoldenDB |
NoSQL 数据库:MongoDB、Redis、Elasticsearch |
向量数据库:Chroma、Qdrant、Milvus |
时序数据库:TDengine、Apache IoTDB |
消息队列:RocketMQ、MQTT、Kafka、RabbitMQ |
其他扩展:Nacos配置中心、JVM运行时、自定义驱动数据源 |
注:平台内置各类数据源驱动,无需在服务器单独部署驱动程序。
支持多种数据源
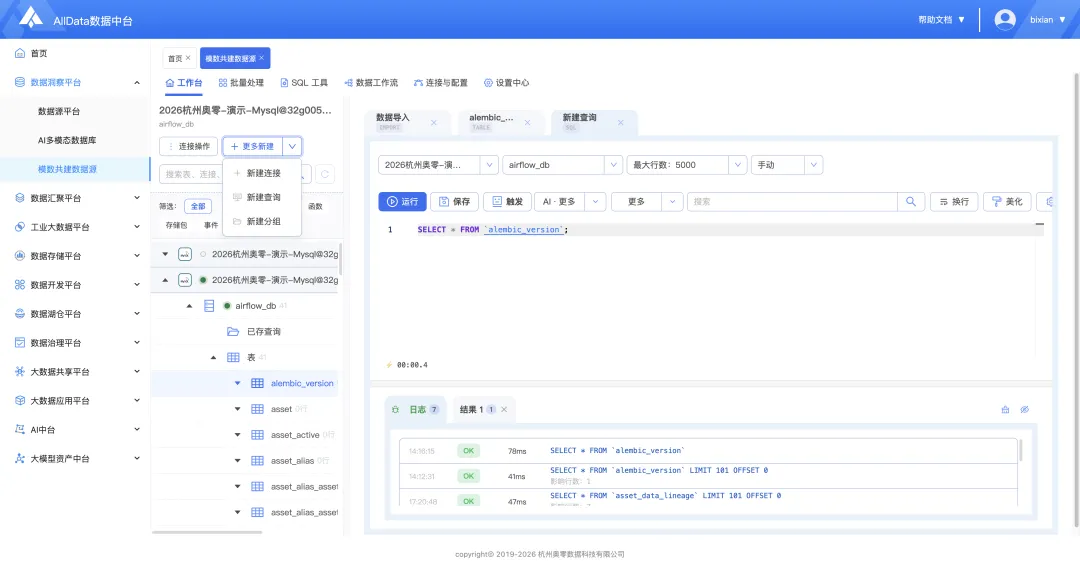
在工作台连接各类数据源,直接拉取数据表
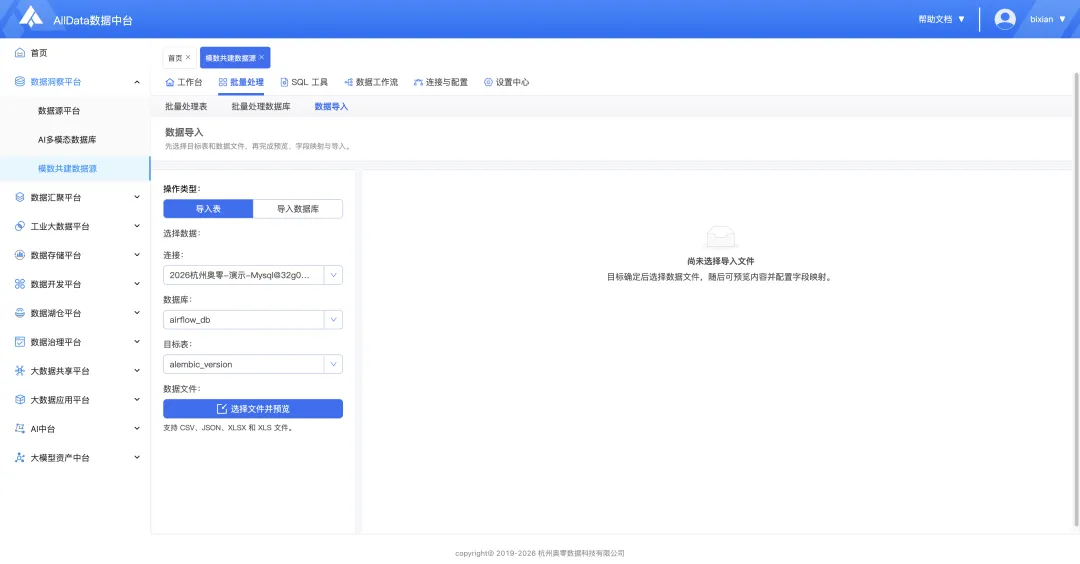
在批量处理模块,从外部导入数据表/数据库,完成业务数据上中台,导入的数据写入目标端,源端原始数据不改动
2、数据查询|如何查得快、查得准,查询过程是否可追溯可核验
数据表完成接入后,提供多种查询手段,兼顾人工SQL查询、AI智能分析、外部脚本执行,所有查询行为均可留痕溯源,保障查询结果有据可查。
✅ 预览表明细,手写 SQL,选中数据表发起 AI 智能分析,AI 历史记录可回溯
✅ 导入本地 SQL 脚本文件直接运行
✅ 全部查询生成执行日志,结果支持导出,问题可通过日志定位
用AI智能分析通过自然语句下达分析指令进行分析
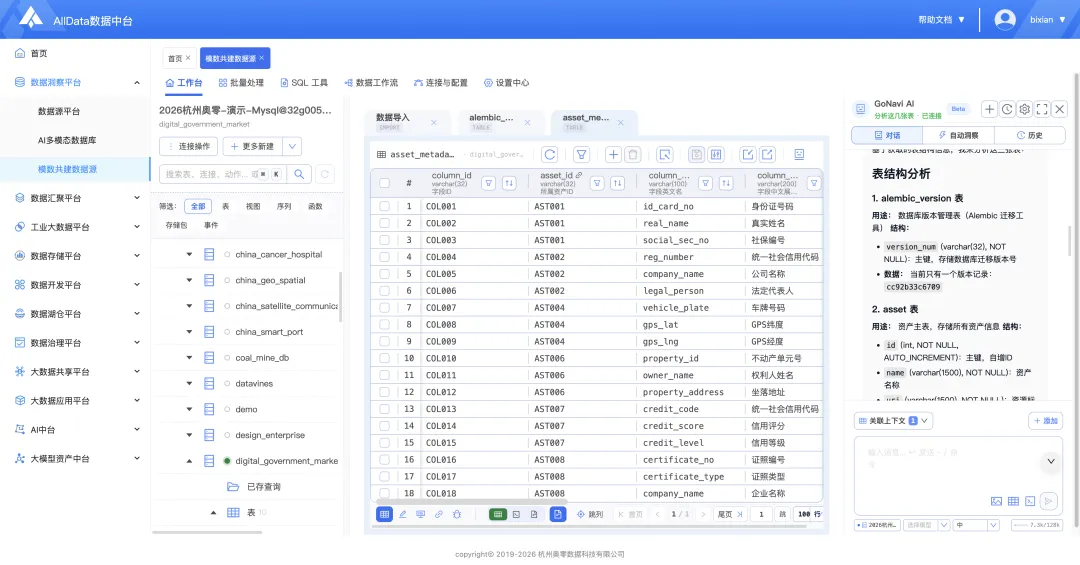
支持 SQL 输入与外部 SQL 文件精准查询,批量导入表 / 库,写入目标端不修改源数据,兼容 CSV、JSON、XLSX、XLS
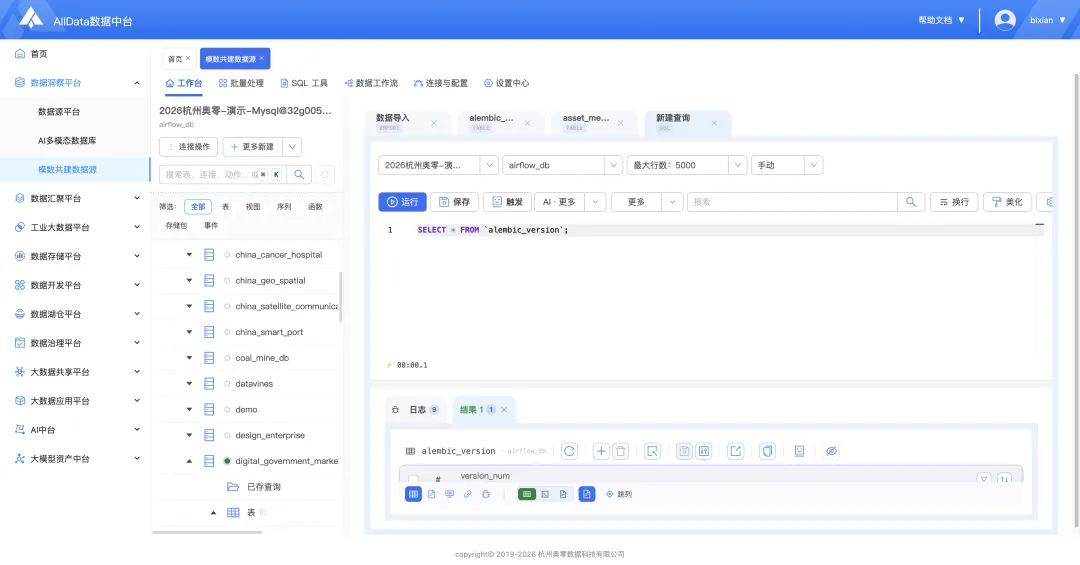
3、多表批量管理:大量临时业务表如何高效处置
业务建模过程经常会产生大量临时数据表,单张表逐个操作效率低下。批量处理能力支持多选数据表、数据库,解决了业务建模会产生多张数据表如何批量做导出、清理的问题。
✅ 批量导出:批量选择多张表导出数据,用于离线核对、业务材料输出
✅ 批量删除:统一清理废弃临时数据表,简化大量中间表的生命周期管理
4、SQL运行风险管控:如何发现和管控拖慢集群的慢SQL
平台提供慢SQL工作台,集中采集全部执行耗时过长的SQL语句。可以统一查看慢SQL的执行详情、耗时、执行计划,识别低效查询逻辑,及时优化SQL,避免不合理查询消耗过多计算资源,保护整个平台查询性能稳定。
5、数据比对:发现数据差异会不会改动原始业务数据
平台表结构比对、精细数据比对仅做差异识别与结果展示,不会修改源端、目标端任何原始业务数据,不存在误改业务数据风险。
✅ 表结构比对:对比源、目标两端字段、字段类型、索引的差异,快速发现两边表结构不一致
✅ 精细数据比对:基于数据表逐行比对内容,识别新增、缺失、变更的数据行, 比对输出差异清单,把问题点展示给用户,由人工确认之后再决定后续处理动作
在数据工作流可执行表结构与数据比对,平台自动识别差异、生成清单,不改动源库;所有变更需人工审批后方可同步,防范误操作风险
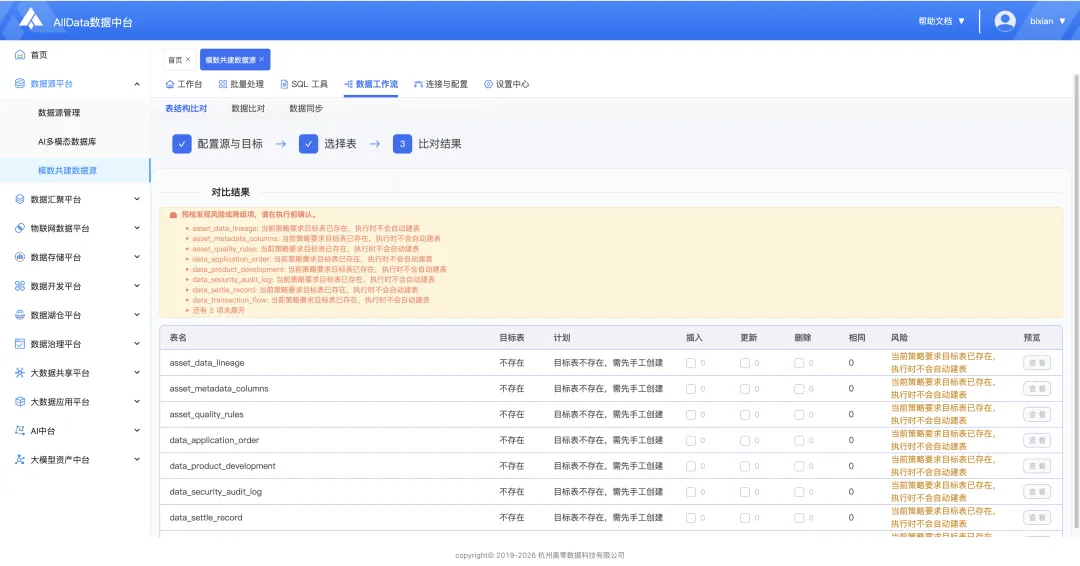
6、数据同步:数据同步实现什么能力、数据会同步到哪一层?
数据同步用于完成源端数据源向目标端的数据流转搬运,支持跨库、跨类型数据源之间的数据迁移与镜像落地。
✅ 同步目标支持业务库、中台 ODS 原始层、DWD 明细层
✅ 支持全量、增量同步,支持整表同步、SQL 结果集同步
✅ 适用于跨系统迁移、镜像业务数据、数仓分层落地;支持自动建表、字段适配,适配国产库流转
3大功能各自优点和场景选型
数据源管理 (Chat2DB)、AI 多模态数据库 (DB‑GPT)、模数共建数据源 (GoNavi) 为中台内相互独立的功能组件,每个组件具备完整闭环能力,可根据业务需求单独启用、单独部署使用。
1、数据源平台 (Chat2DB)
核心定位:全域异构数据源统一接入底座、数仓分层工作台,面向标准数仓建设场景
支持 16 + 数据源一键接入,集中监控数据源状态;
完整支撑 ODS‑DWD‑DWS‑ADS 全套数仓分层,库表浏览、SQL 查询、数据导出;
工作台绑定大模型,支持自然语言查询。
独立使用适用场景:需要搭建标准化企业数仓、统一管理多业务数据源,做多团队库表权限管控、基础SQL探查与自然语言取数时,使用数据源管理 (Chat2DB)。
核心定位:多模态AI智能交互分析引擎,面向业务自助问数、智能报告、AI工作流自动化分析场景
数据库、文档知识库联合分析,支持多模态资产; 数据库画像、多智能体、SQL沙箱、SQL溯源,防范AI幻觉与误操作; AWEL工作流封装行业技能,支持定时自动输出报告; 适配私有化国产大模型,内网闭环运行。
独立使用适用场景:需要业务人员自助自然语言问数、业务库与文档知识库联合分析,配置任务自动生成分析报告并全程审计溯源时,使用AI多模态数据库 (DB-GPT)。
核心定位:业务建模与数据流转校验工作台,面向外部数据导入、表 / 数据比对校验、跨源数据同步场景
7大分类 31+数据源,支持向量、时序、消息队列等特殊数据源; 支持CSV/JSON/XLSX外部文件导入; 表结构、精细数据比对,仅输出差异,不改动源数据; 跨库跨类型数据同步,支持全量 / 增量;具备慢SQL治理、批量表运维;
独立使用适用场景:需要外部文件导入、跨库数据迁移对账校验,接入向量 / 时序等特殊数据源,完成数据同步与批量表运维治理时,使用模数共建数据源 (GoNavi)。
模拟简易业务场景化选型推荐
业务场景:某制造企业,业务现状:已经上线 ERP、MES 多套业务数据库;业务部门经常收到 Excel 业务报表;业务人员不懂 SQL,希望自助看指标;暂不打算搭建完整大规模数仓。
选型参考:
1、业务人员要大白话自助查询 RP/MES库的业务指标 → AI多模态数据库 (DB‑GPT);
2、经常接收业务Excel报表,需要导入系统、核对新旧系统数据差异 → 模数共建数据源 (GoNavi);
3、后续企业计划建设完整ODS‑DWD‑DWS‑ADS数仓,统一管理全部业务库与权限 → 数据源管理 (Chat2DB)。


