

最近一位同学面试被问到一道题,回来跟我复盘:
"如何在训练时让模型输出 CoT,推理时只输出答案,而且回答准确率还能提高?"
今天用三篇代表作 + 论文原图,把这条路线从 0 到 1 讲透。建议收藏,算法岗面试迟早用得上。
一、先把问题说清楚:为什么想让模型"闭嘴思考"
显式 CoT 的两个硬伤:
贵且慢:推理链越长,生成 token 越多,延迟和成本线性上涨; **未必符合模型的"计算直觉"**:比如多位数乘法,计算器一步到位,模型却要写一长串中间步骤。
于是就有了这条路线:训练阶段保留 CoT 监督信号,让模型学会推理;推理阶段把中间步骤"内化"进隐层,直接吐答案。目标 = 显式 CoT 的准确率 + 无 CoT 的速度。
面试高频考点:这条路线有三个主流做法——知识蒸馏、逐步内化(课程学习)、System 2 → System 1 蒸馏。能报出名字 + 讲清区别,这题就赢了一半。
二、方法①:隐式 CoT 知识蒸馏(ICoT-KD)
📄 Implicit Chain of Thought Reasoning via Knowledge Distillation(Deng et al., arXiv:2311.01460)
最早的系统化尝试:生模型不看老师的 CoT 文本,而是直接读老师推理时的latent层状态。
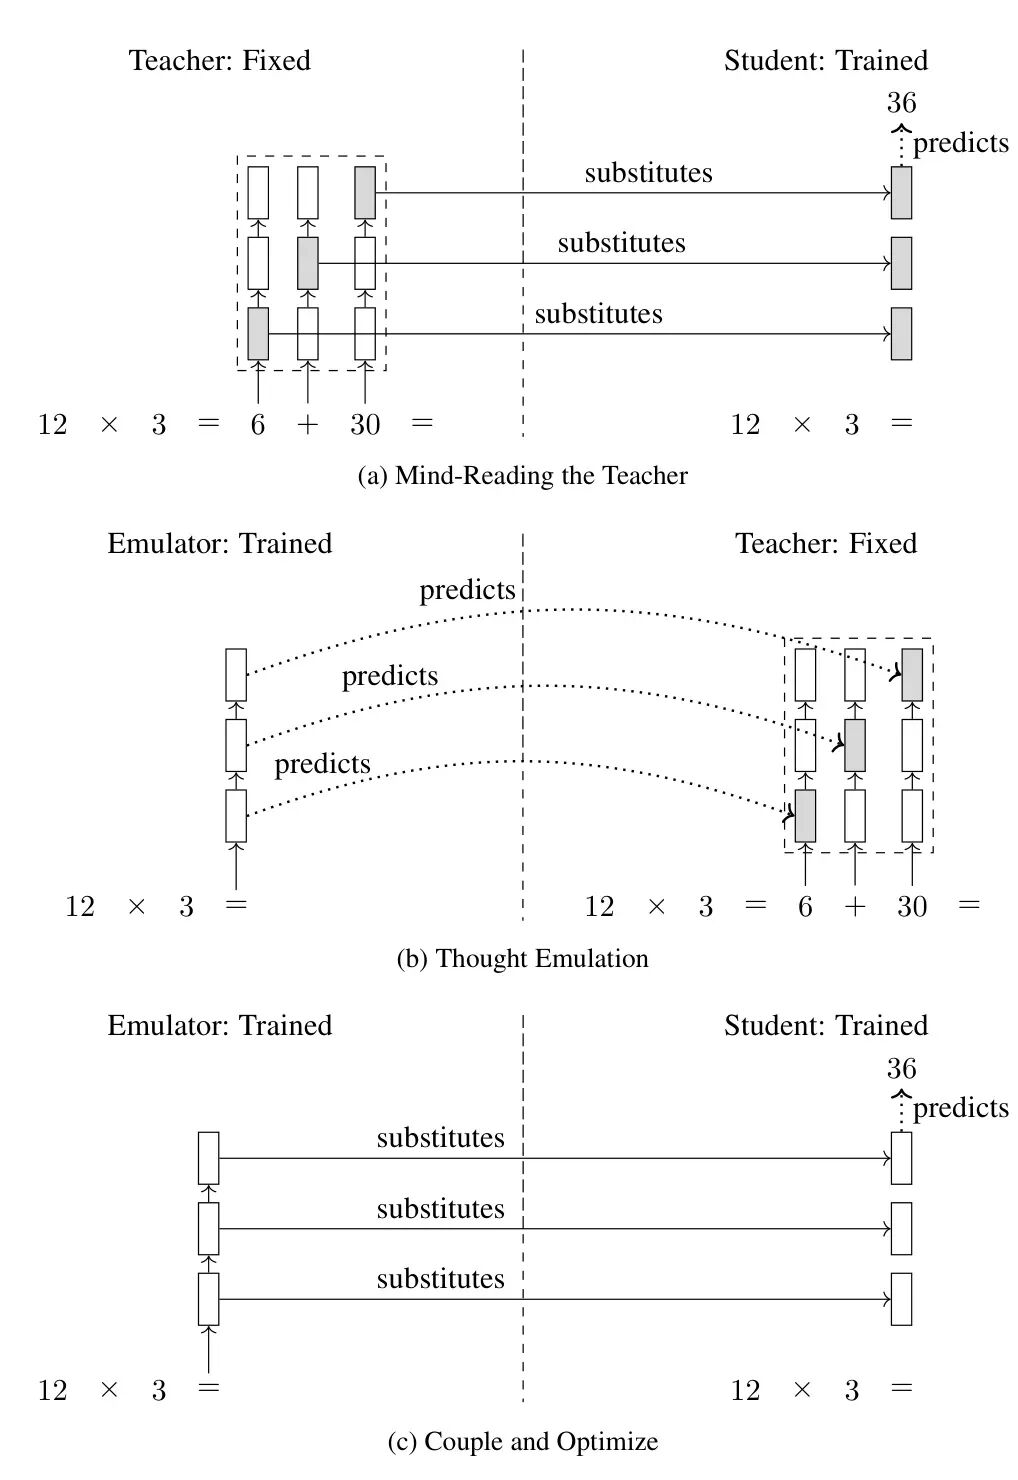
三步走:
Mind-Reading the Teacher(读心):学生用老师推理时的纵向隐层状态(跨层)替代显式中间步骤,直接预测答案; Thought Emulation(思维模拟):训练一个 emulator,从输入直接预测老师的隐层推理过程(横向推理); Couple and Optimize(耦合优化):emulator + 学生端到端微调,允许学生发展出自己的推理轨迹,不必完全模仿老师。
痛点也很明显:流程复杂、需要额外训练 emulator、蒸馏过程不稳定。这就引出了第二个方法。
三、方法②:逐步内化 Stepwise Internalization(本篇重点)
📄 From Explicit CoT to Implicit CoT: Learning to Internalize CoT Step by Step(Deng et al., arXiv:2405.14838)
思路优雅到可以一句话讲完:先训一个显式 CoT 模型,然后每个阶段删掉一个 CoT token,再微调,循环往复,直到 CoT 被删光。
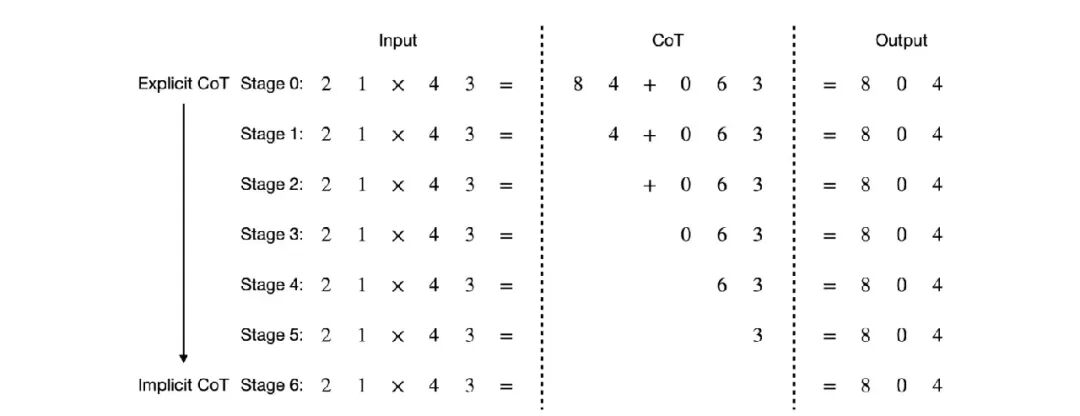
形式化一下。显式 CoT 训练目标:
其中 是中间推理步骤,是最终答案。逐步内化在第 步训练时,从 CoT 开头删掉 个 token,删除量按线性课程增长:
控制删除速度,是每个 epoch 的步数。每删一个 token,模型就被迫把这一步推理"压"进参数和隐层表示里——课程学习式的内化。
两个关键稳定技巧(⚡ 面试加分项):
优化器状态重置:每多删一个 token,就重置 AdamW 的动量/方差估计,防止梯度动力学突变导致训练崩掉; Removal Smoothing(删除平滑):给删除量加随机偏移 ,其中
论文取 ,即 98% 概率正常删、2% 概率多删一个。让模型提前"适应"下一阶段,loss 曲线不会出现断崖式跳变。
效果有多猛?
GPT-2 Small 解决 **9×9 乘法,准确率 99%**——而标准训练连 4×4 乘法都搞不定; Mistral-7B 在 GSM8K 上不生成任何中间步骤,准确率超过 50%,比 GPT-4 直接作答(无 CoT)还高。
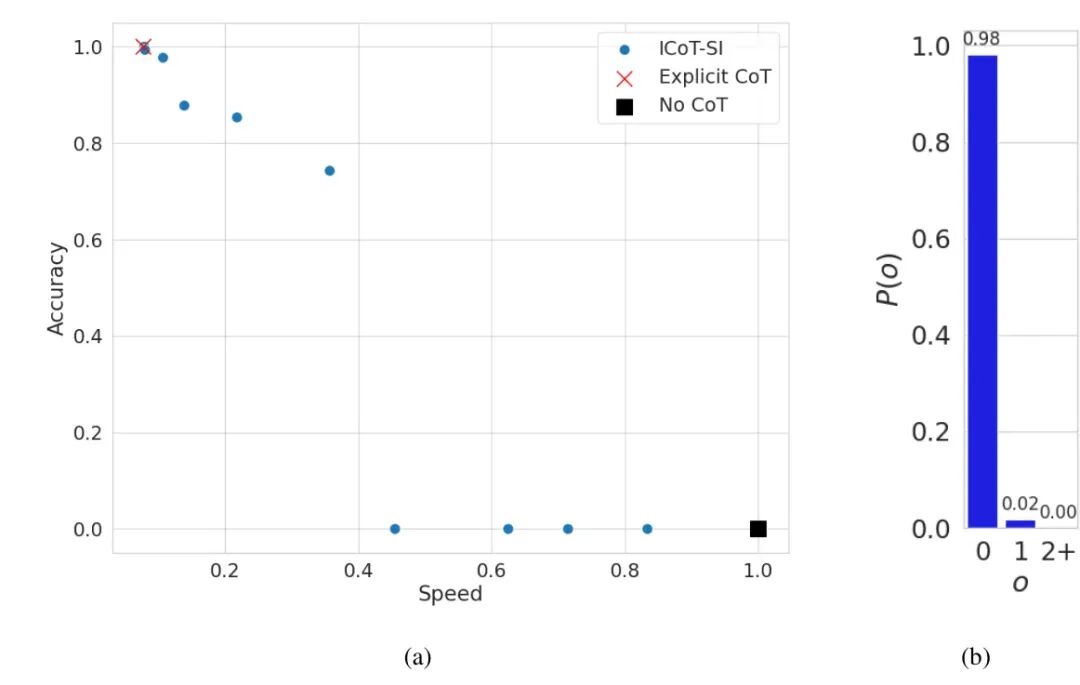
这张图要讲一句实话:内化不是免费的——在更难的 11×11 乘法上,完全内化后准确率会掉。所以这条路线的现实用法是"删一部分、留一部分",在速度和准确率之间选甜点。
四、方法③:把 System 2 蒸馏进 System 1
📄 Distilling System 2 into System 1(Yu et al., Meta FAIR, arXiv:2407.06023)
思路换了个视角,借心理学概念:System 2 = 费力慢思考(CoT、Rephrase-and-Respond、System 2 Attention、Branch-Solve-Merge),System 1 = 直觉快回答。人类练熟一项技能后,System 2 会"编译"成 System 1(开车从手忙脚乱变成肌肉记忆)——模型能不能也这样?
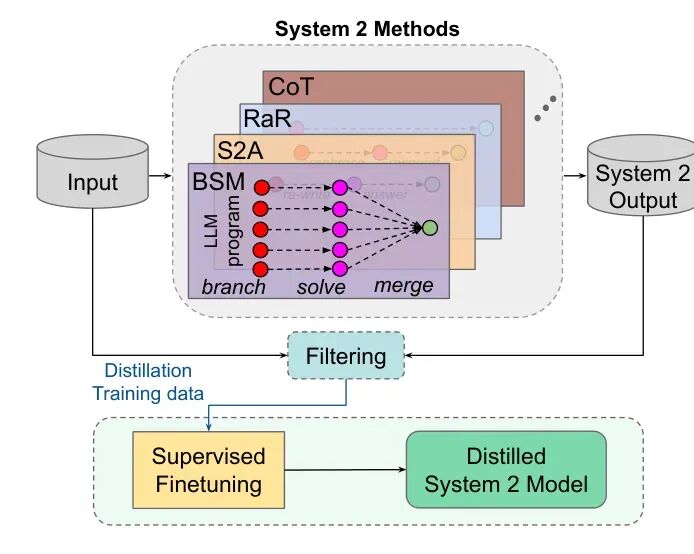
形式化对比:
System 2 生成中间 token 再得答案 ;System 1 一步到位。蒸馏流程完全无监督:对无标注输入跑 System 2 方法 → 用 self-consistency 多次采样过滤出高质量答案 → 只拿「输入 → 答案」对做 SFT,中间步骤全部丢弃。
效果(Llama-2-70B-chat,Last Letter Concatenation 任务):
| 蒸馏回 System 1 | 98.0% |
⚡ 面试高频考点:蒸馏后不仅保住了 System 2 的准确率优势,还远超原始 System 2——因为 SFT 在有标注数据上充分拟合了任务规律。推理成本则和 System 1 一样低。
五、三种方法怎么选?一张表收尾
延伸方向(面试官追问时提一嘴):latent reasoning(COCONUT 连续空间思考)、Pause Tokens、Quiet-STaR——都是"让思考发生在 token 之外"的亲戚。
还要注意适用边界:有标准答案的推理任务(数学、符号推理)最适合;开放式/共情对话类任务没有固定答案,这套方法未必有效——原作者在评论区也持同样观点,认为是过渡阶段的技术。
六、面试答题模板
这道题考察的是隐式 CoT(Implicit CoT)路线:训练时保留 CoT 监督、推理时直接输出答案。 主流做法有三种:
一是知识蒸馏,让学生读取老师推理时的隐层状态替代显式步骤 二是逐步内化,先训显式 CoT 模型,再按课程逐步删除 CoT token 并微调,配合优化器重置和删除平滑稳定训练,把推理压进参数 三是 System 2→System 1 蒸馏,用 self-consistency 过滤 System 2 的高质量输出,只对「输入→答案」做 SFT。
三者的共同本质是:把推理从生成的 token 转移到隐层计算,用训练成本换推理成本。局限是难任务上隐式推理仍落后显式 CoT,实践中常折中保留部分中间步骤。
感谢关注panda师兄,持续分享更多AI求职干货!
【作者简介】
基座模型算法&大厂面试官,全国10+ Al Hackathon奖选手,全球AI比赛冠军。辅导 LLM/VLM 核心技术 ,助力200+同学成功上岸大模型算法。
(长按识别二维码,添加作者微信交流)


