

老师已经为大家准备好电子打印版,需要完整电子版文件的朋友,可以拉到文末查看。 【答案解析】
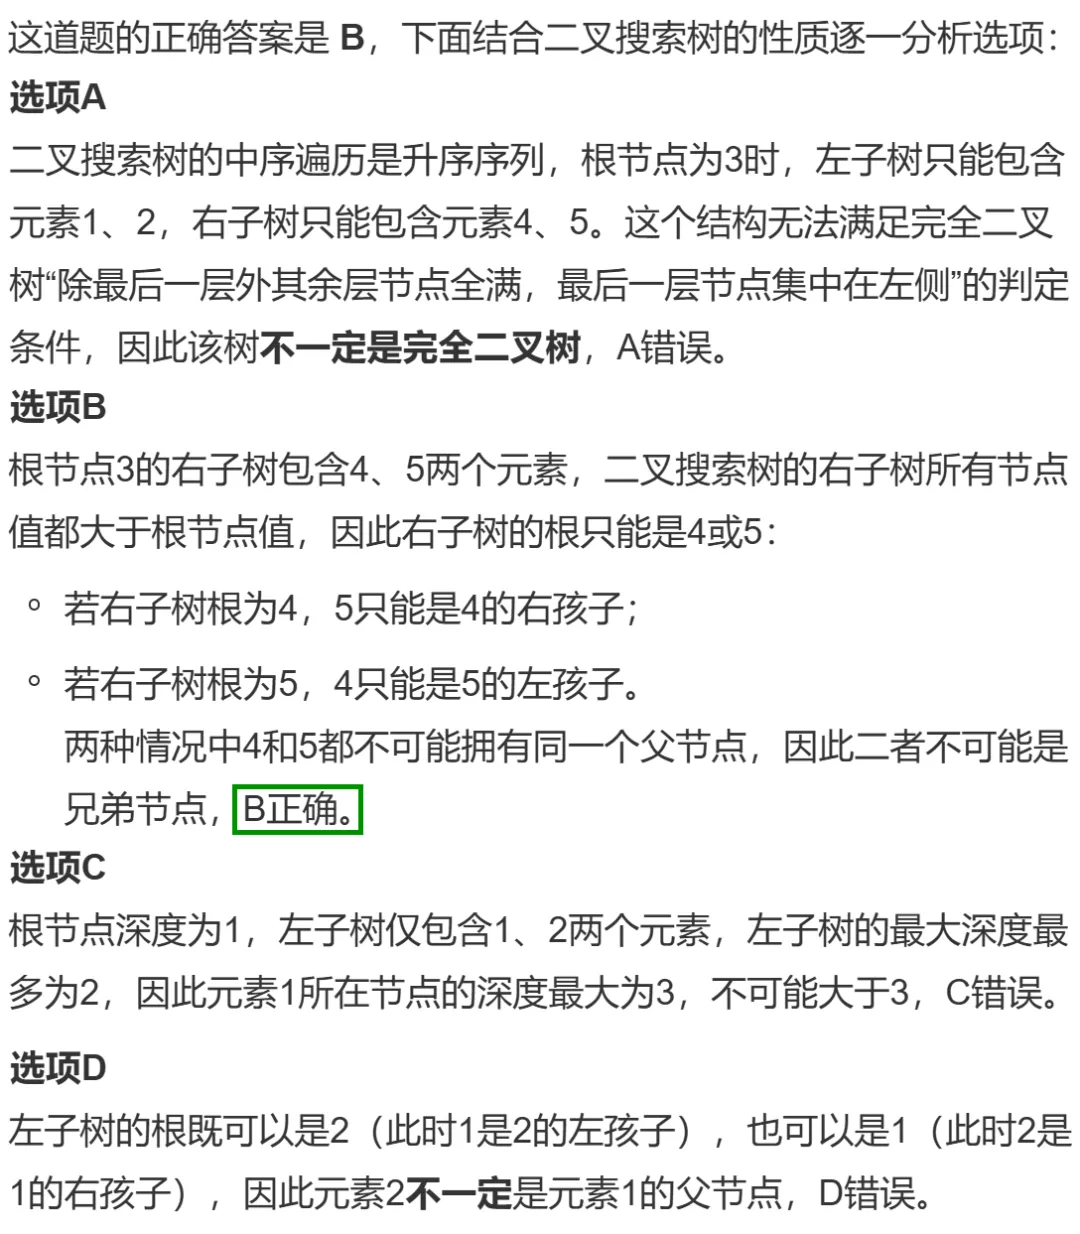
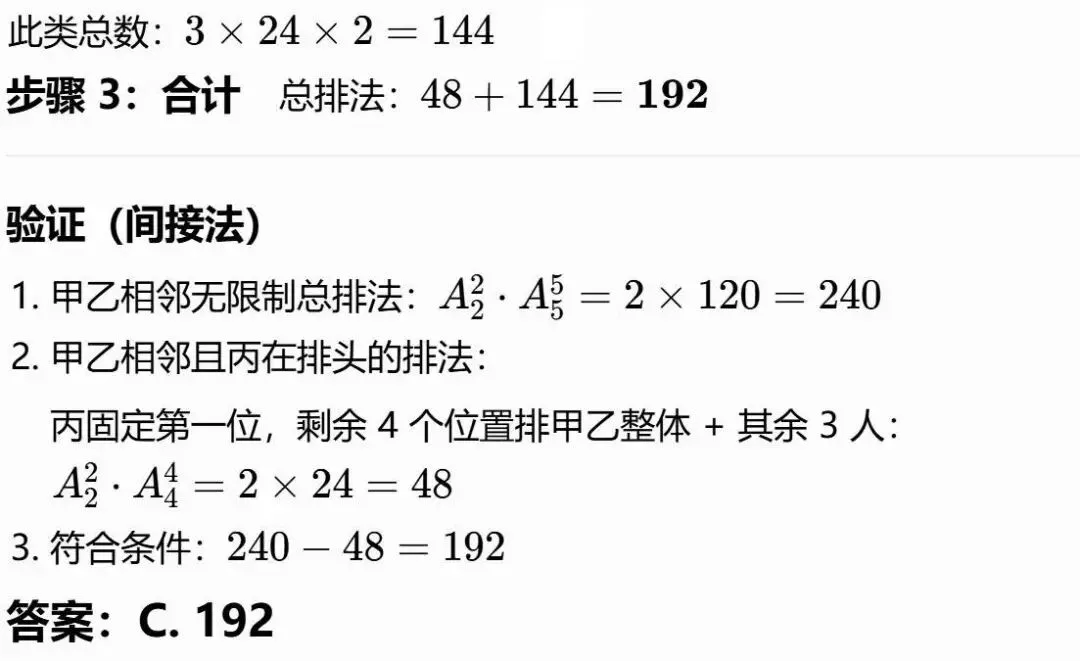
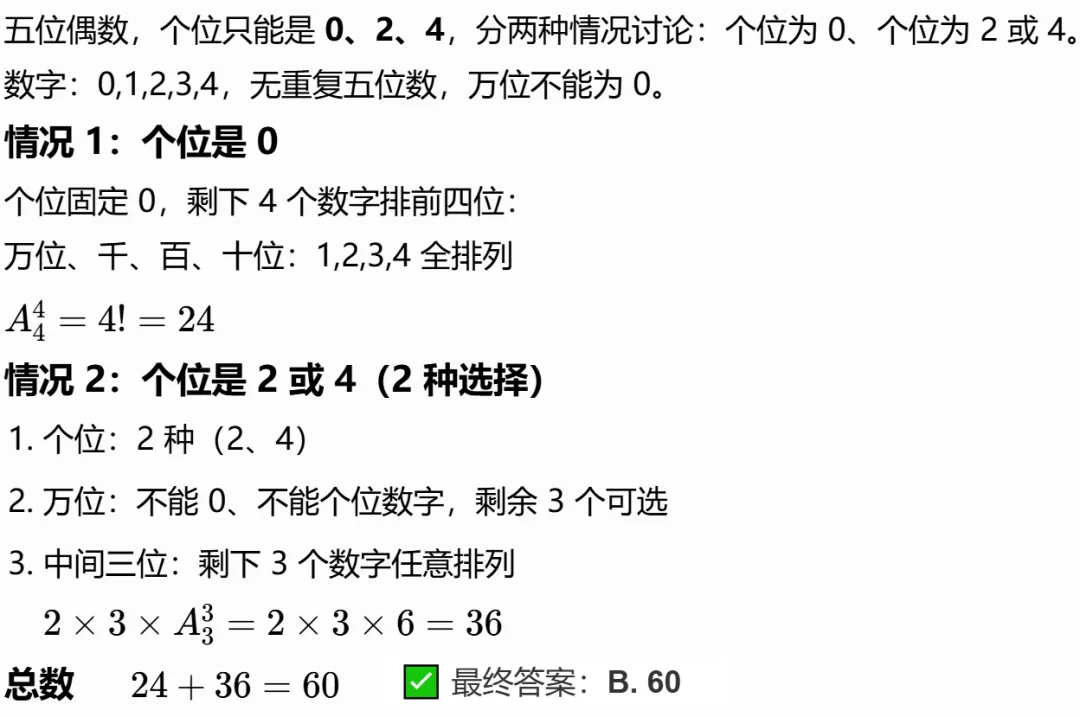
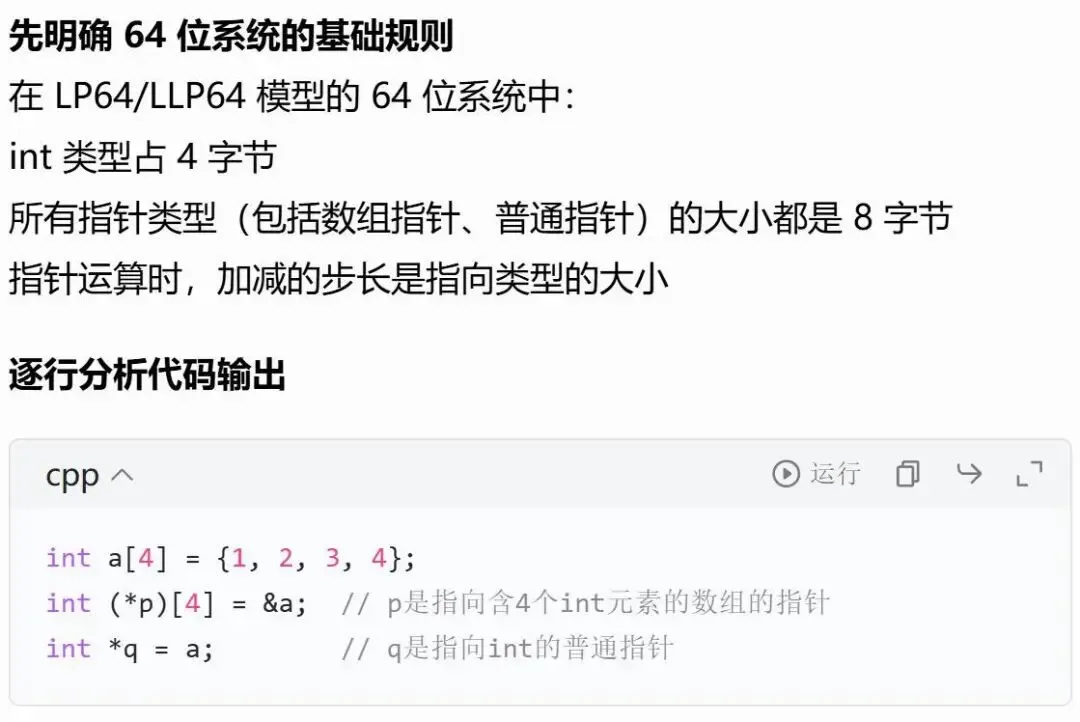
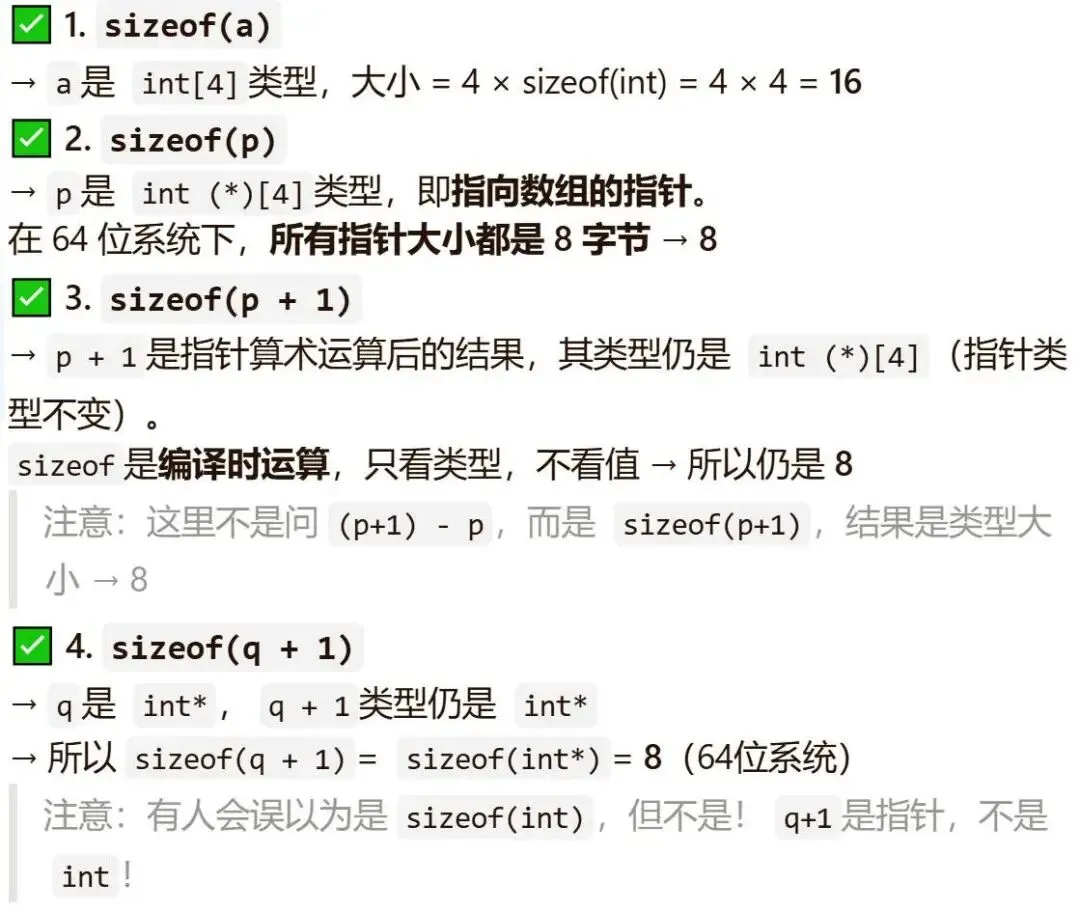
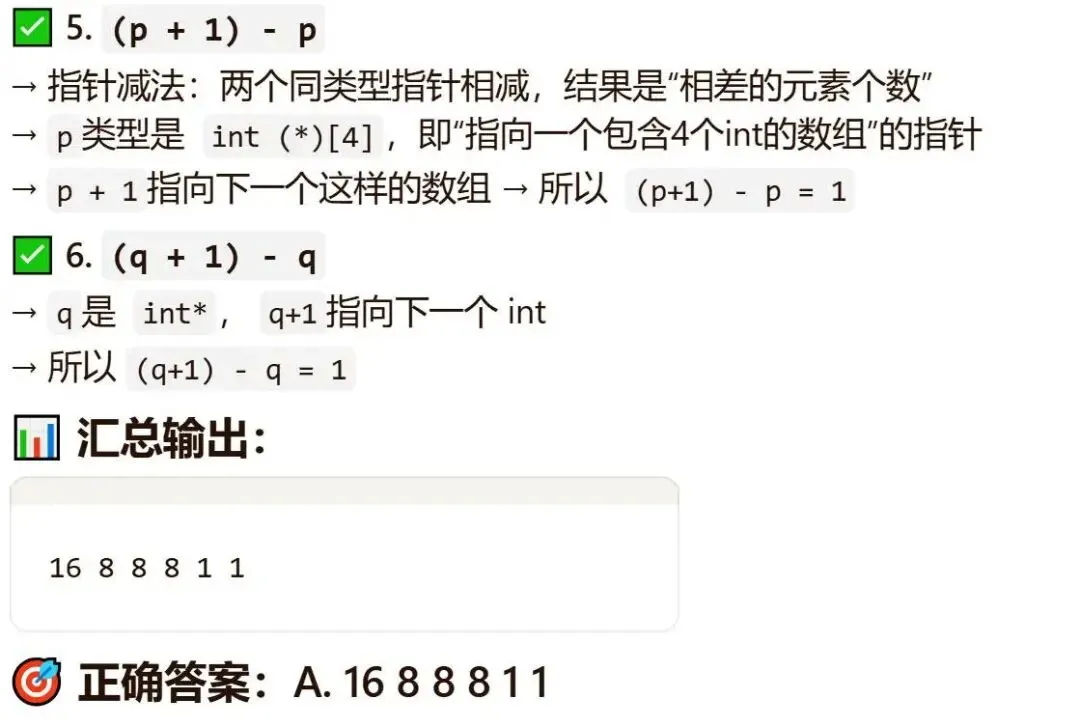
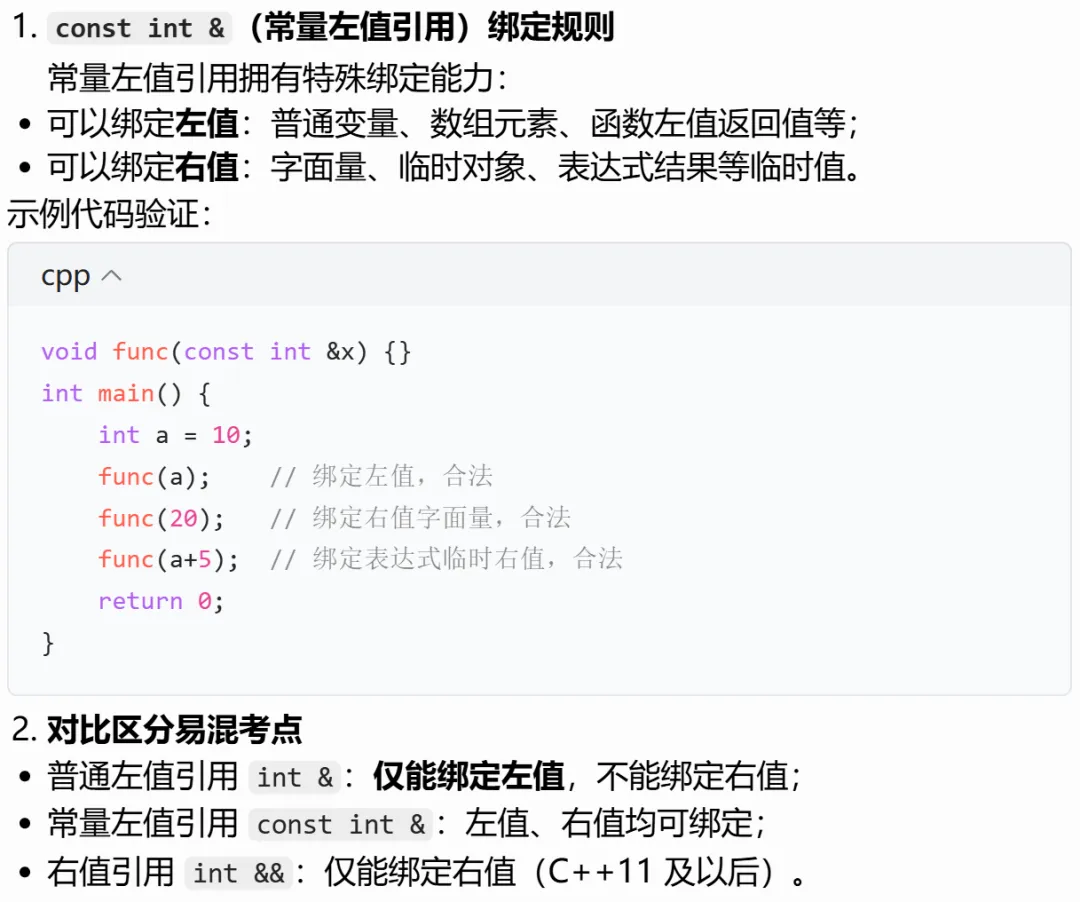
1.解释:答案选D。 详细解析见下图—— 2.解释:答案选B。详细解析见下图—— 3.解释:答案选B。 详细解析见下图—— 4.解释:答案选C。 详细解析见下图—— 5.解释:答案选B。 详细解析见下图——
相关知识点的复习与拓展:
截至考试当年3月,有关二叉搜索树(BST)性质,简单罗列如下—— ● 二叉搜索树的任意节点,左子树所有节点值都小于该节点值,右子树所有节点值都大于该节点值,且左右子树本身也都是二叉搜索树,这是所有解题推导的核心依据。 二叉搜索树的中序遍历一定是严格递增的有序序列,这是结合中序、先序遍历还原树结构的关键突破口。 ● 遍历组合解题技巧—— 已知二叉搜索树的中序遍历(天然有序),再搭配先序/后序遍历的首/尾元素,就能直接锁定根节点,快速拆分左右子树的节点范围,无需复杂递归就能完成树结构推导。 ● 高频考点速记—— 查找、插入操作的平均时间复杂度为O(logn),极端斜树场景下会退化为O(n);删除有双孩子的节点时,用右子树的最小节点(最左节点)替换即可完成操作。 6.解释:答案选C。
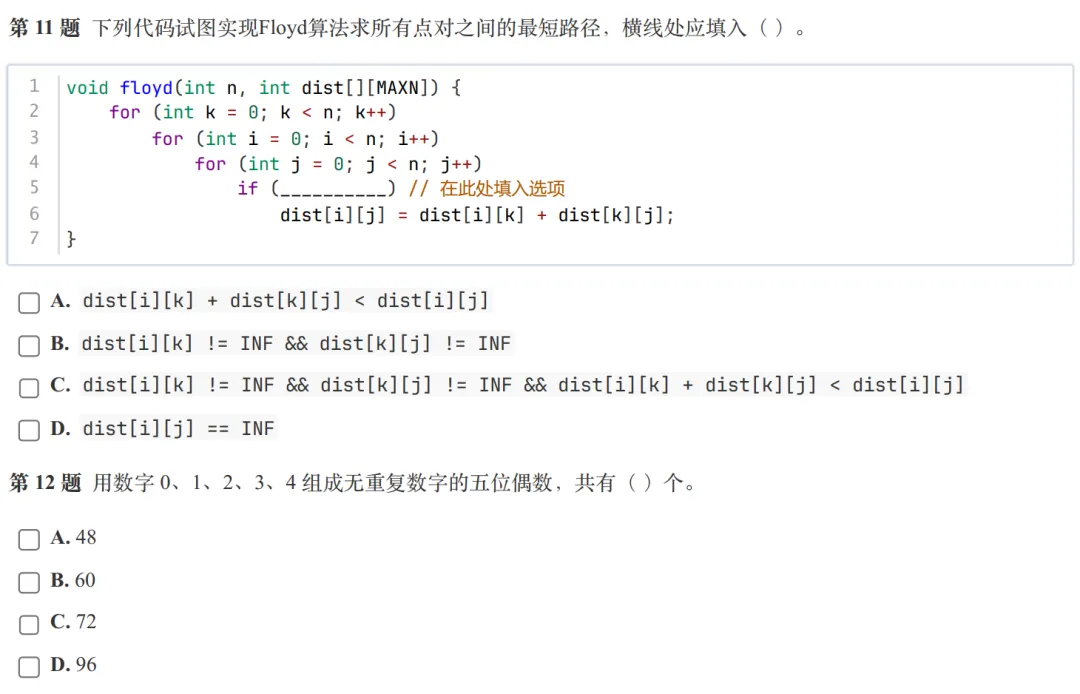
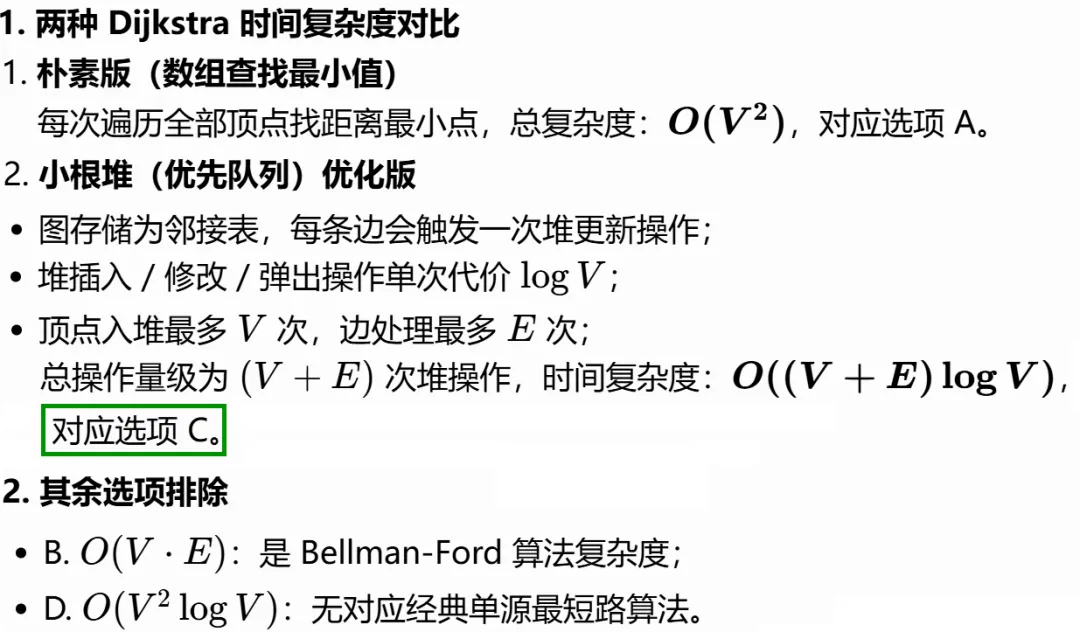
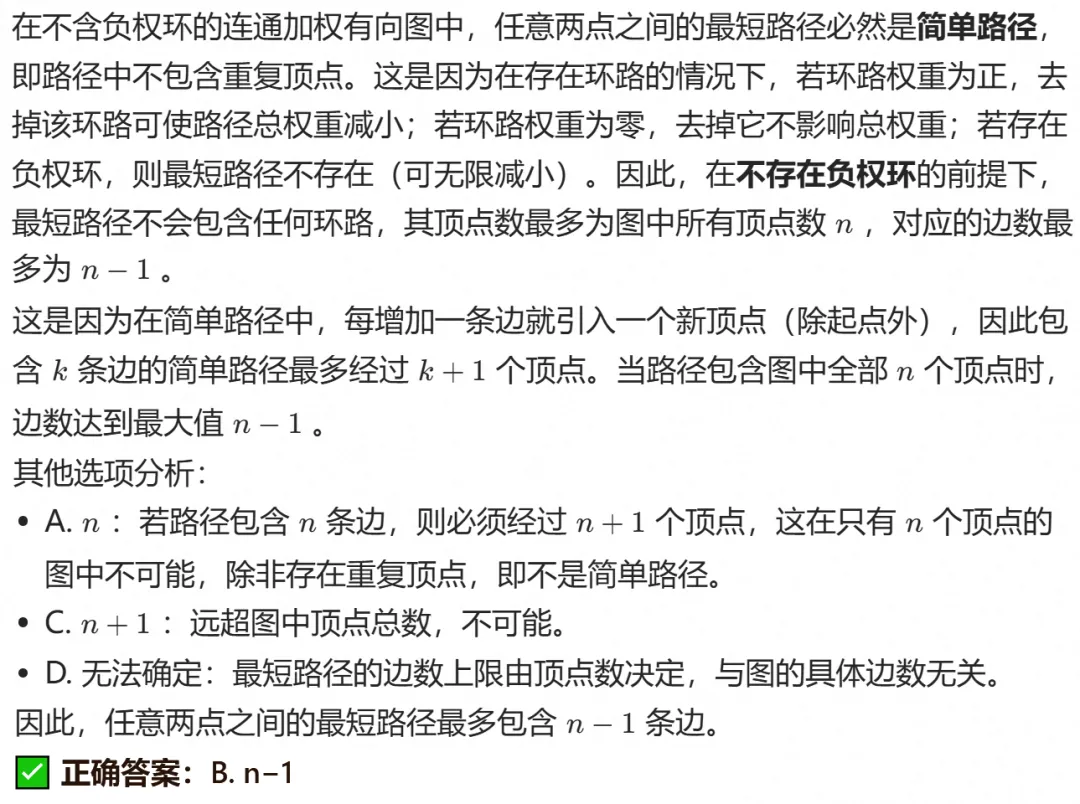
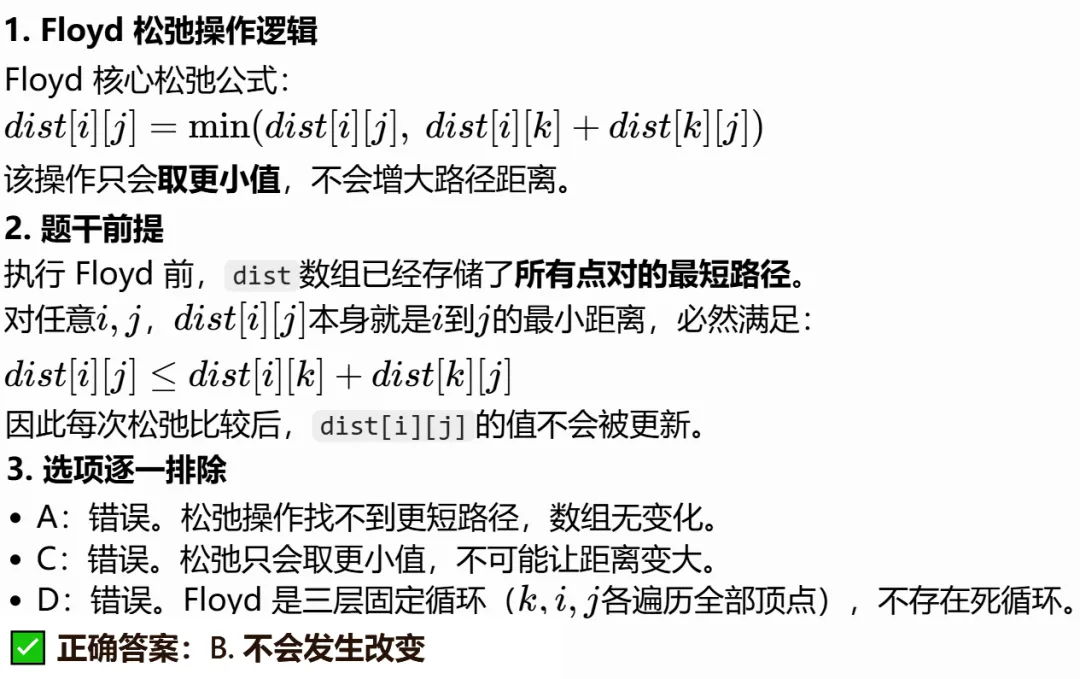
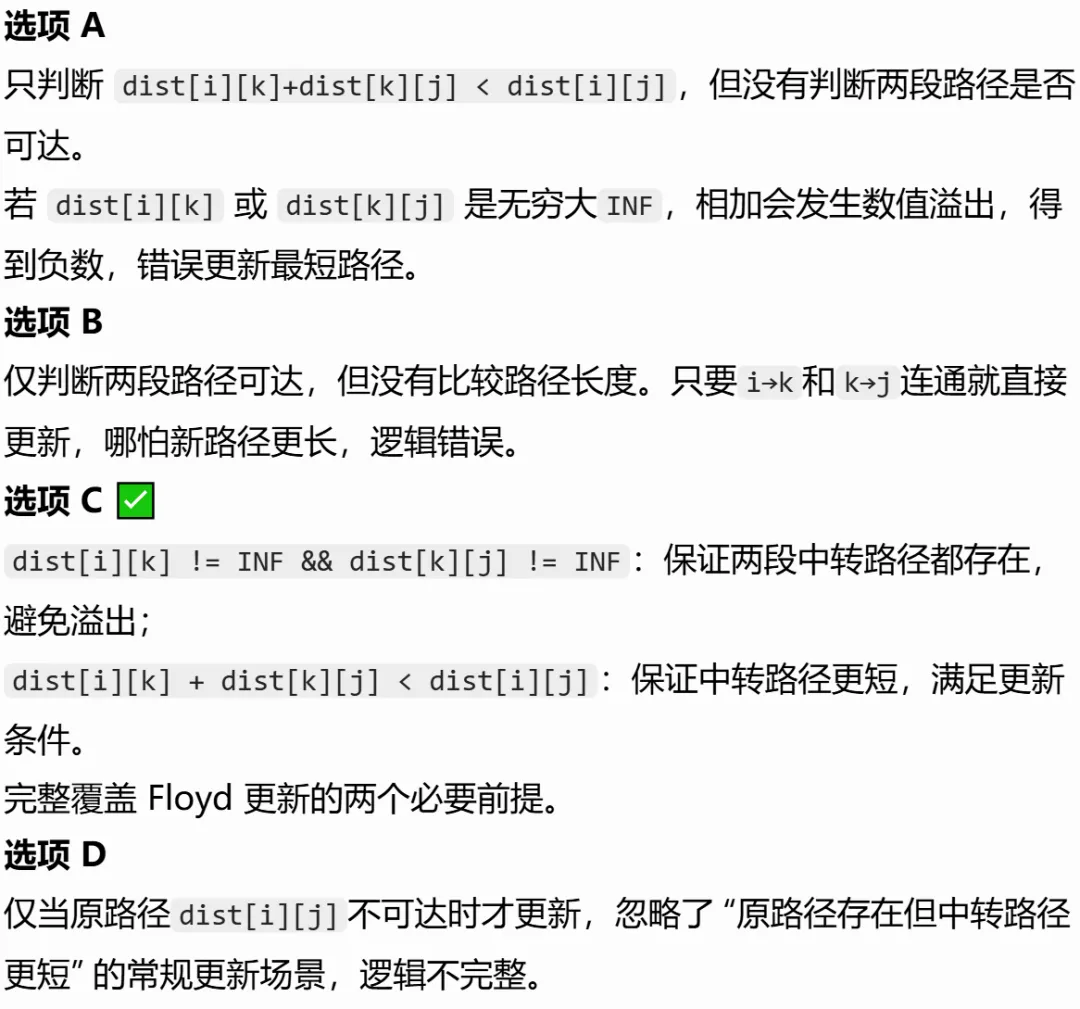
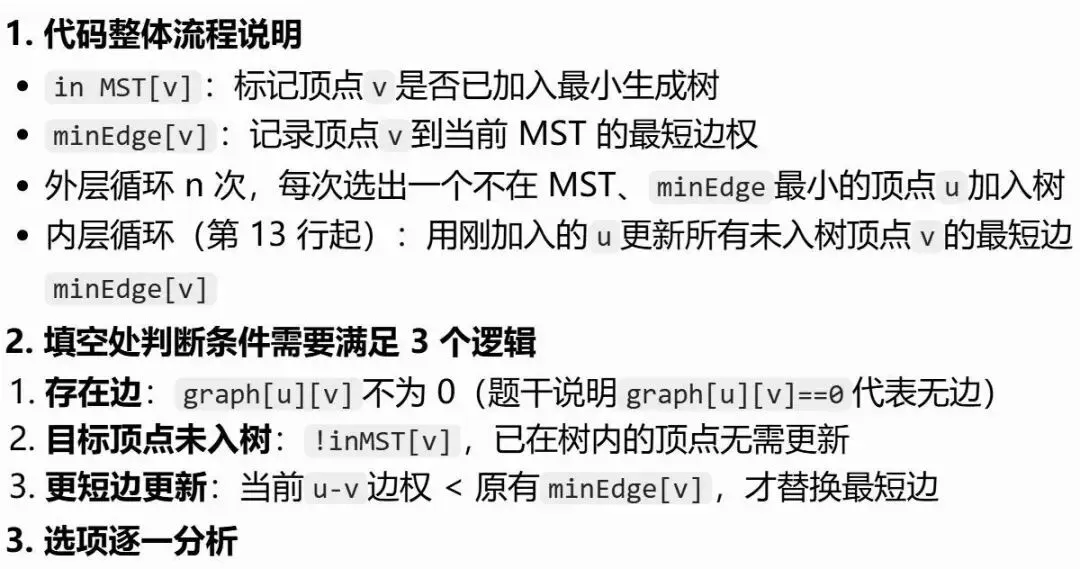
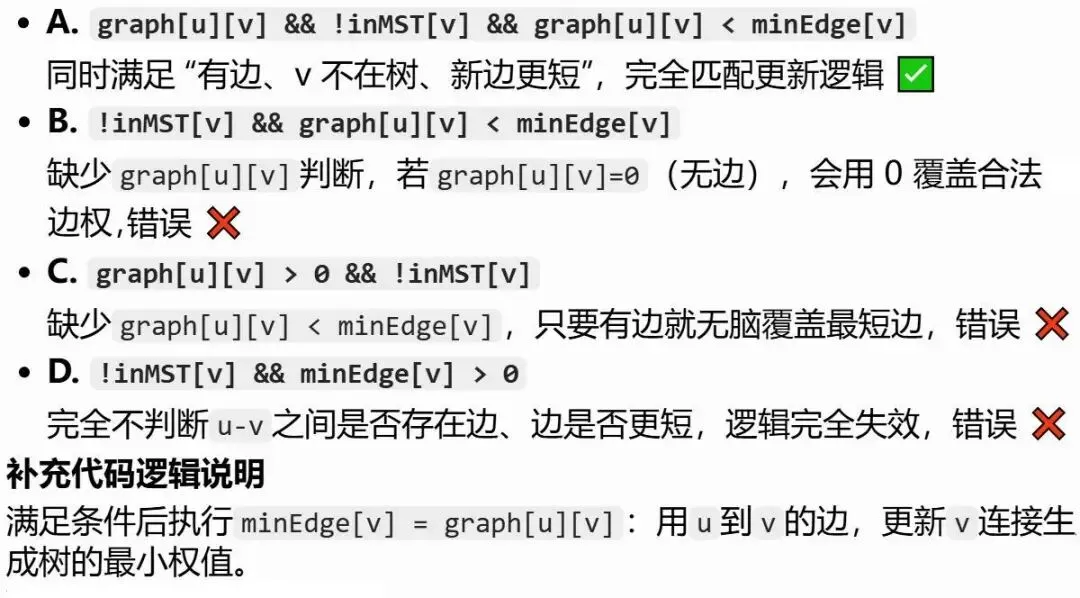
详细解析见下图—— 7.解释:答案选B。 详细解析见下图—— 8.解释:答案选B。 详细解析见下图—— 9.解释:答案选B。 详细解析见下图—— 10.解释:答案选C。 详细解析见下图—— 11.解释:答案选C。 详细解析见下图—— 相关知识点的复习与拓展:
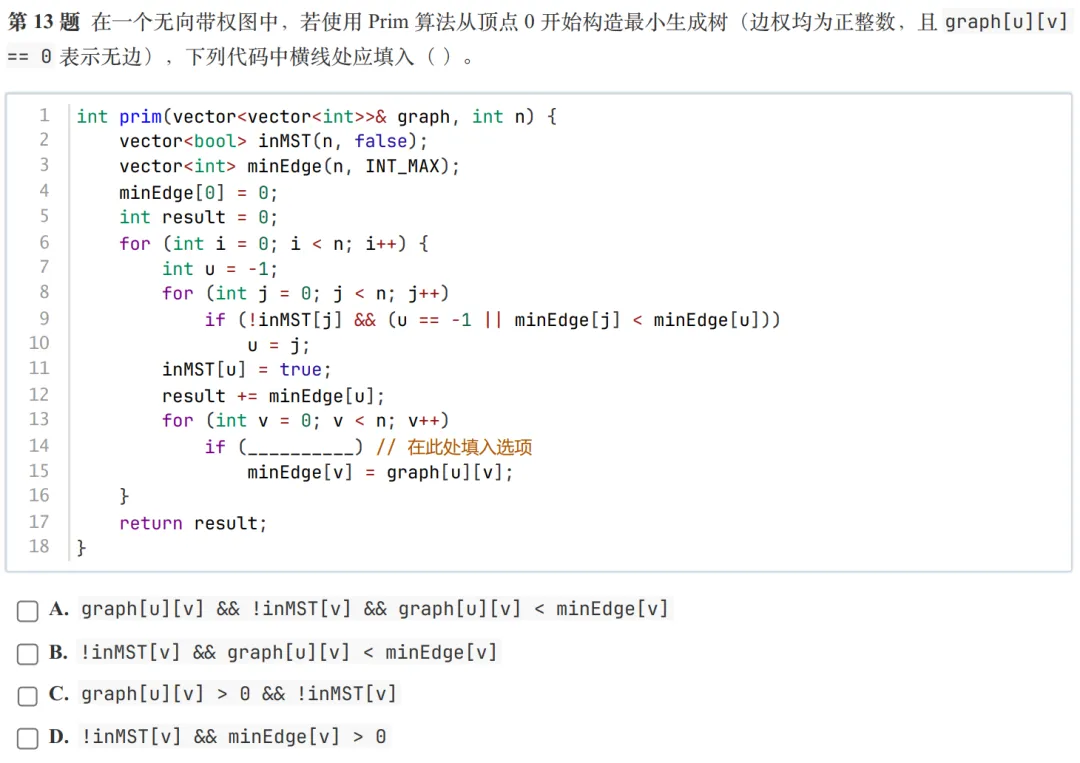
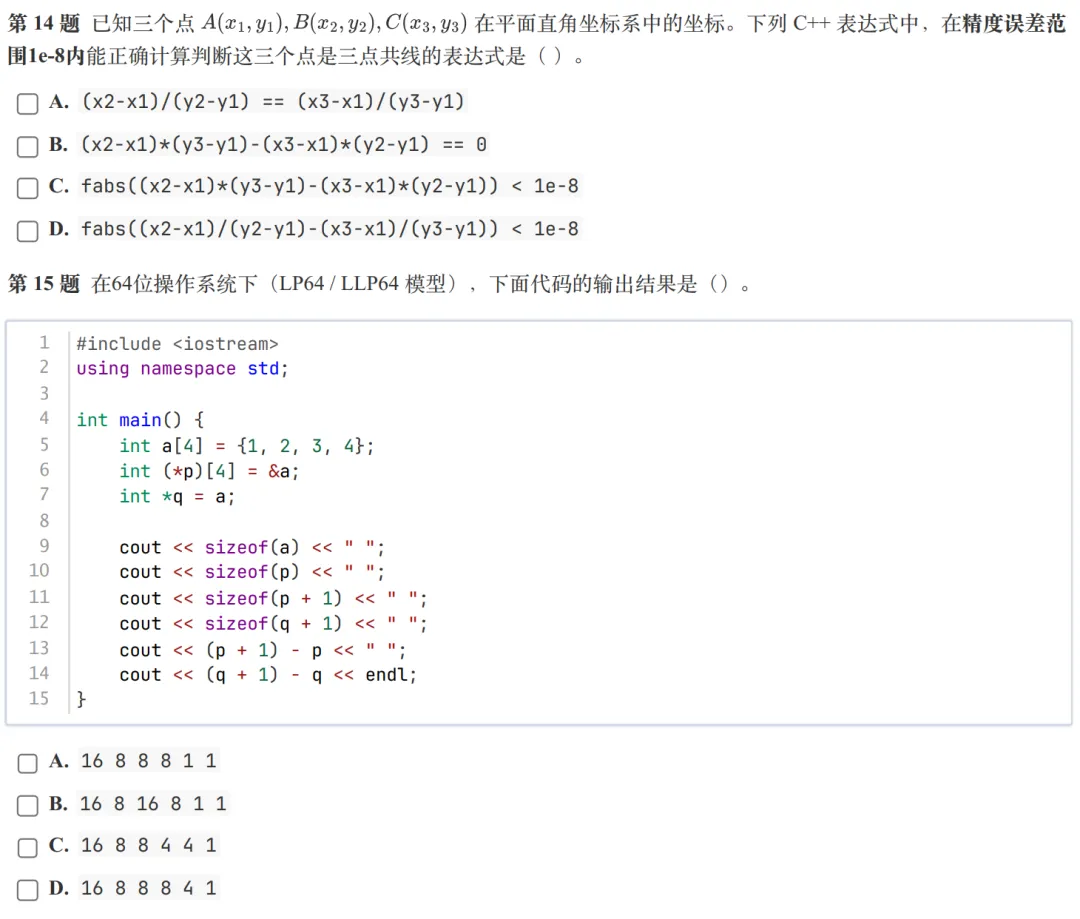
Floyd算法的完整更新语句,标准写法示例如下—— if (dist[i][k] != INF && dist[k][j] != INF && dist[i][k] + dist[k][j] < dist[i][j])dist[i][j] = dist[i][k] + dist[k][j];12.解释:答案选B。 详细解析见下图—— 13.解释:答案选A。 详细解析见下图—— 14.解释:答案选C。 详细解析见下图——
相关知识点的复习与拓展:
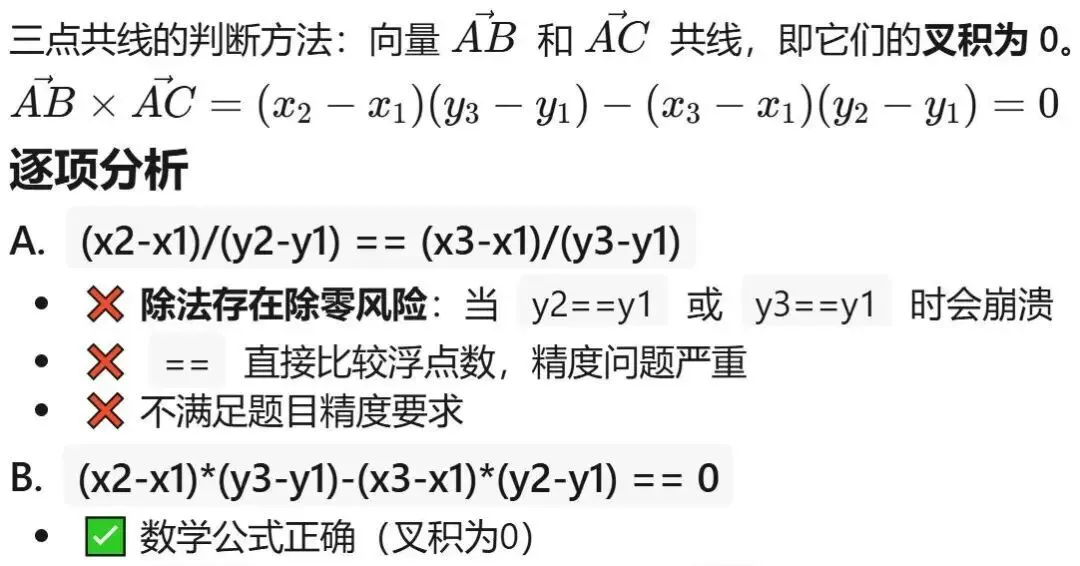
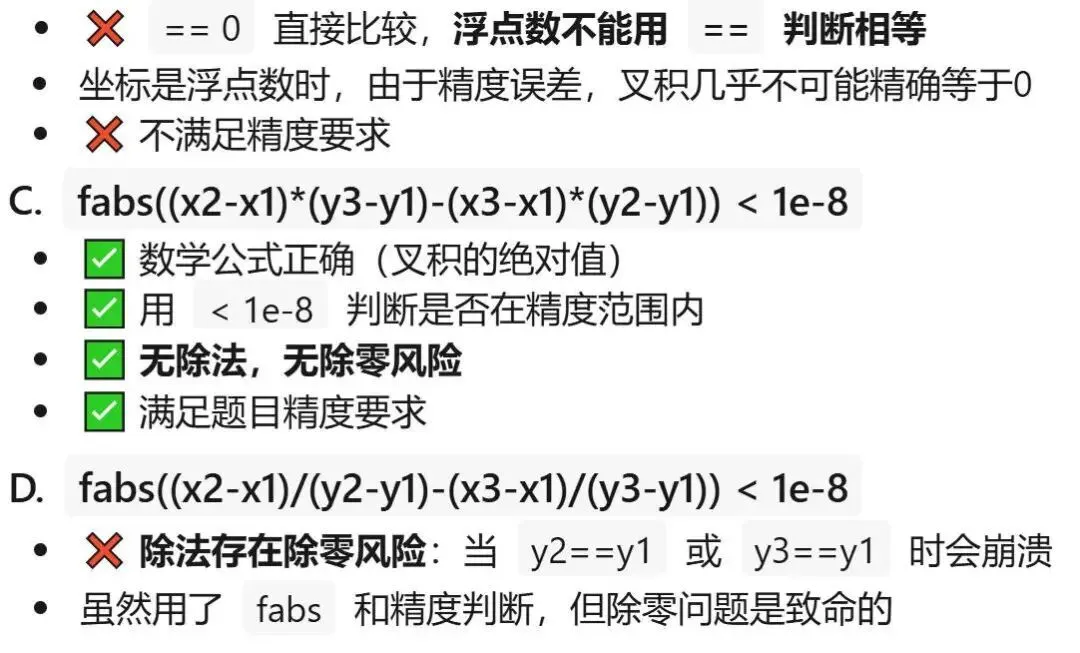
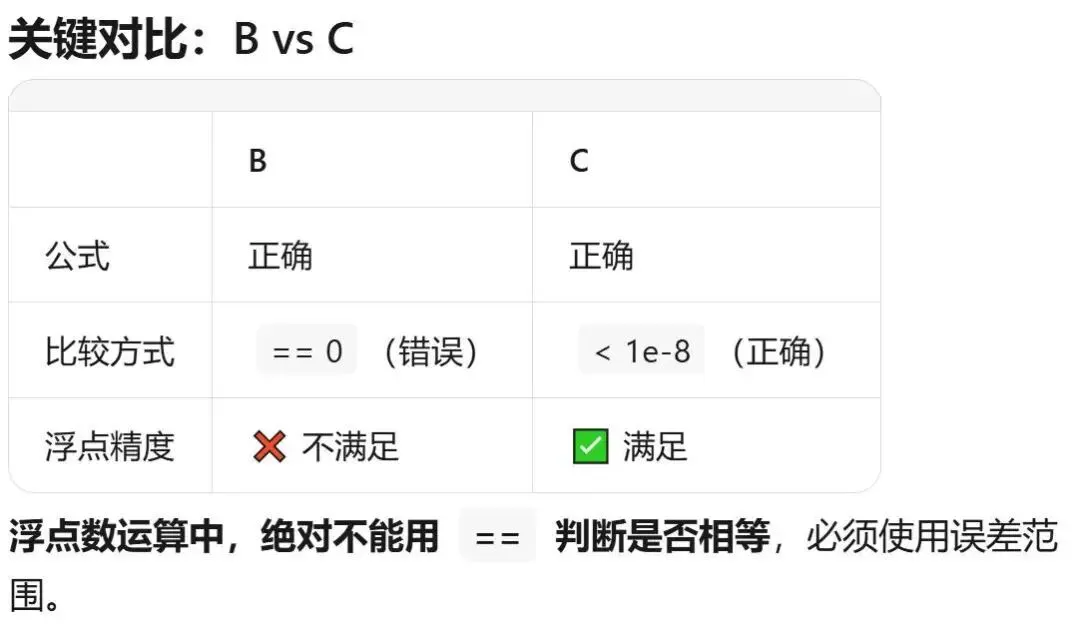
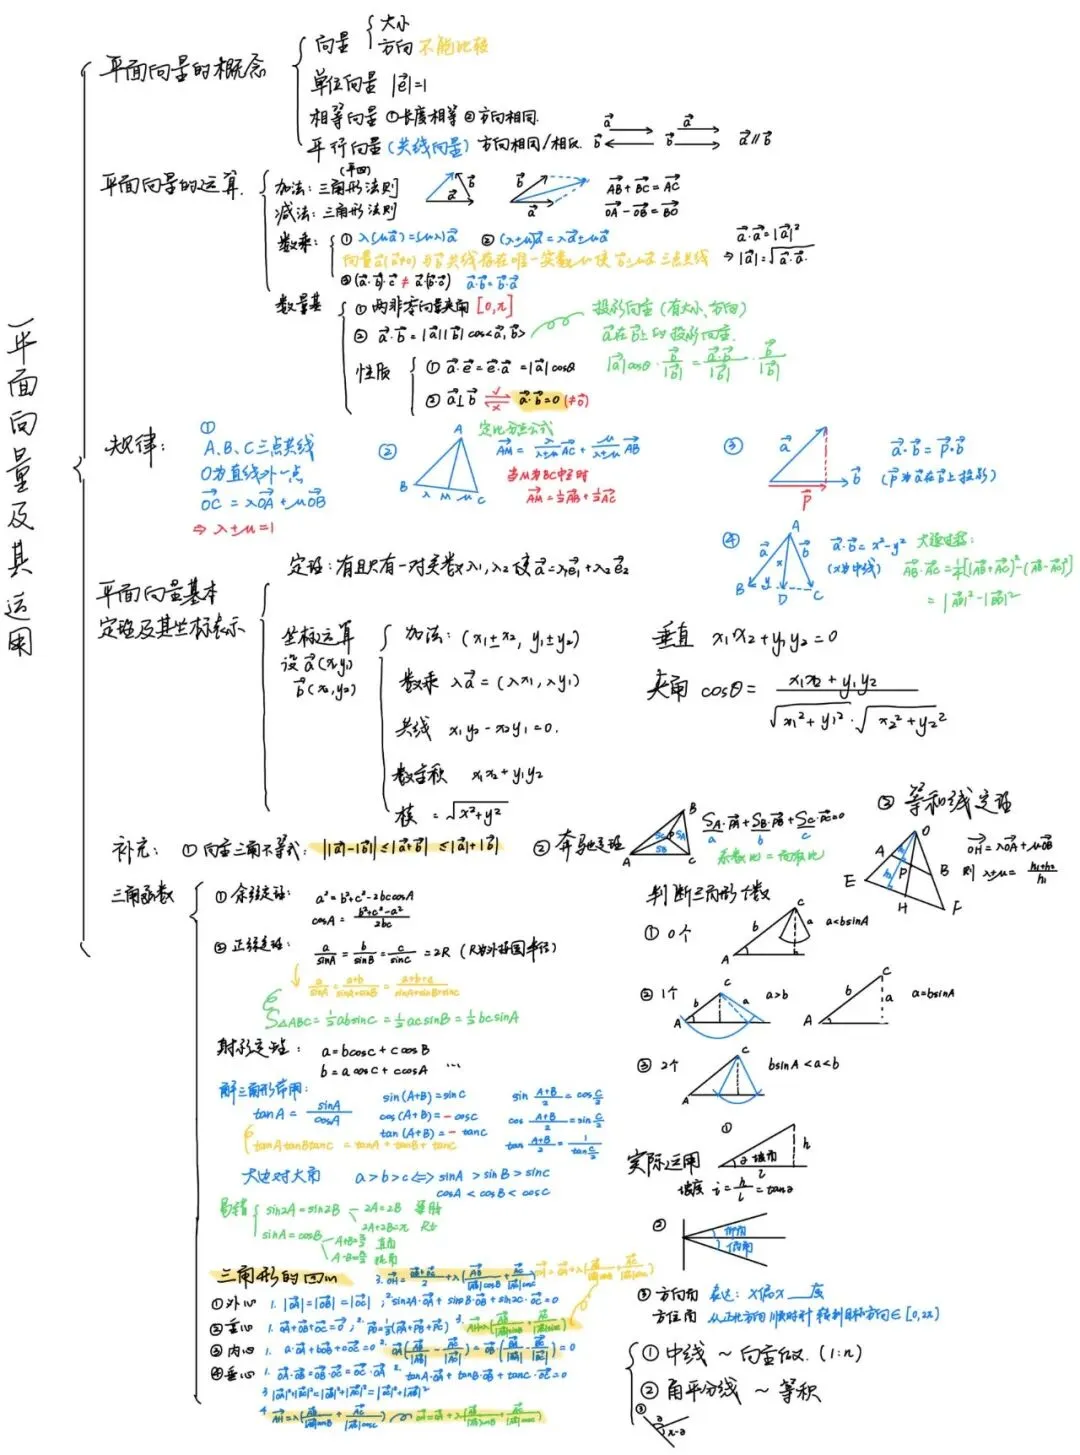
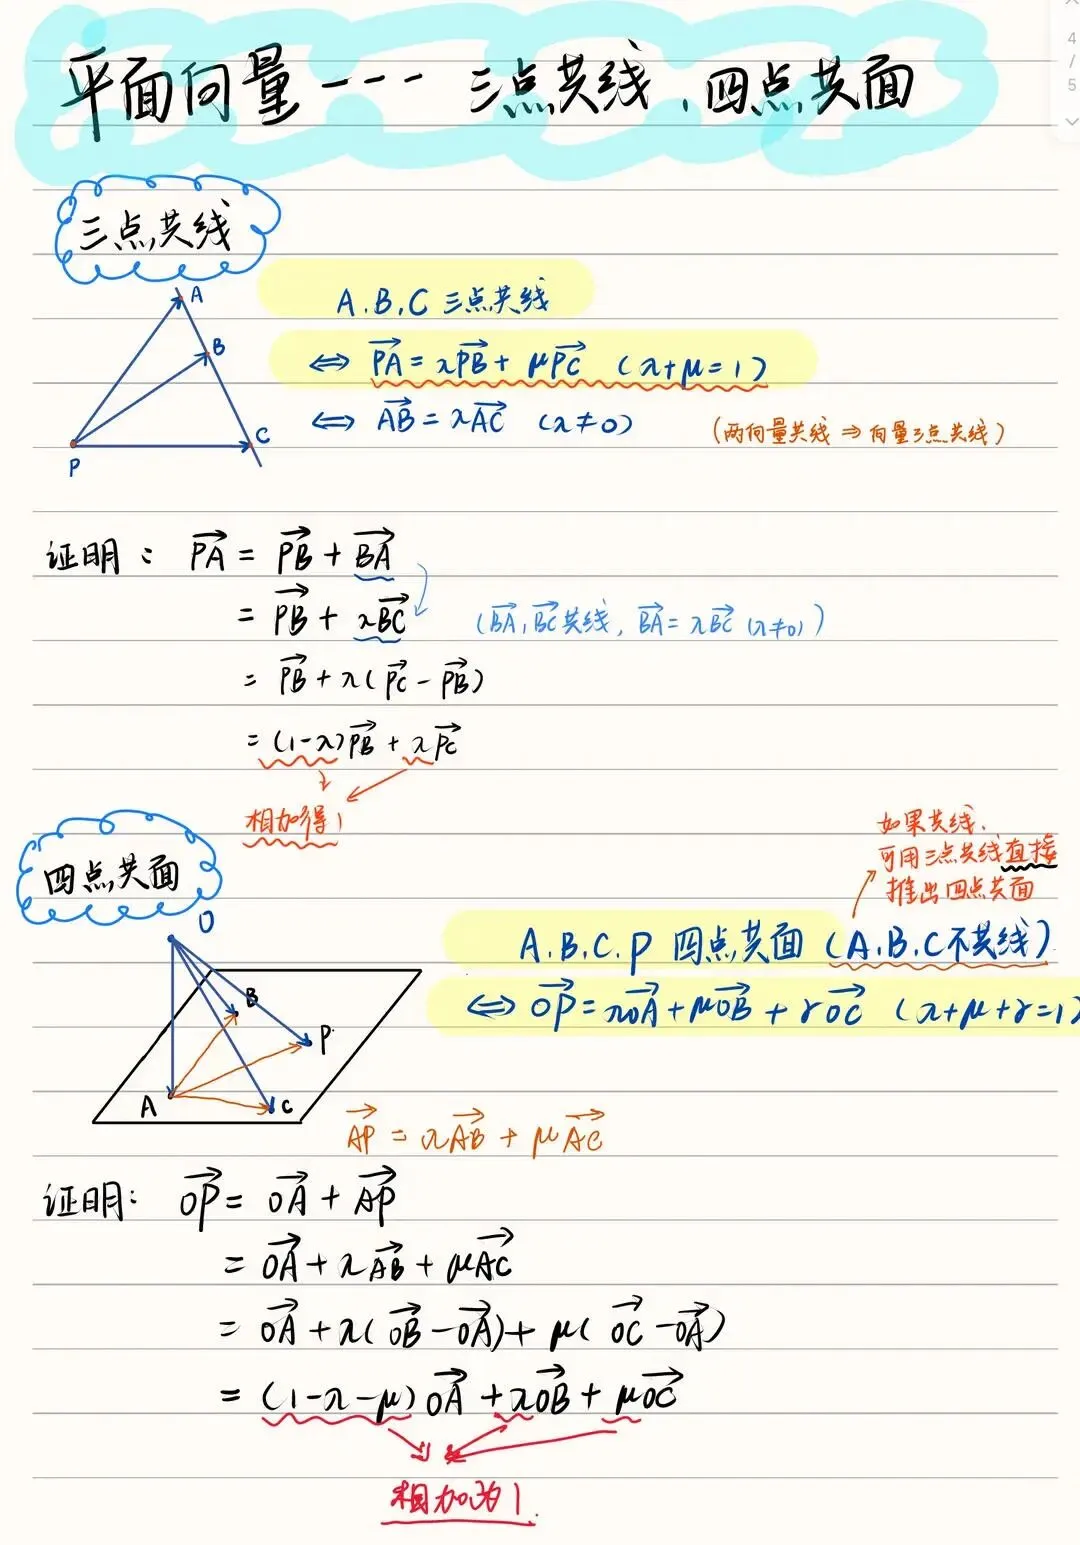
截至考试当年3月,有关平面向量的相关知识点,根据大纲要求简单介绍如下—— 15.解释:答案选A。
详细解析见下图——
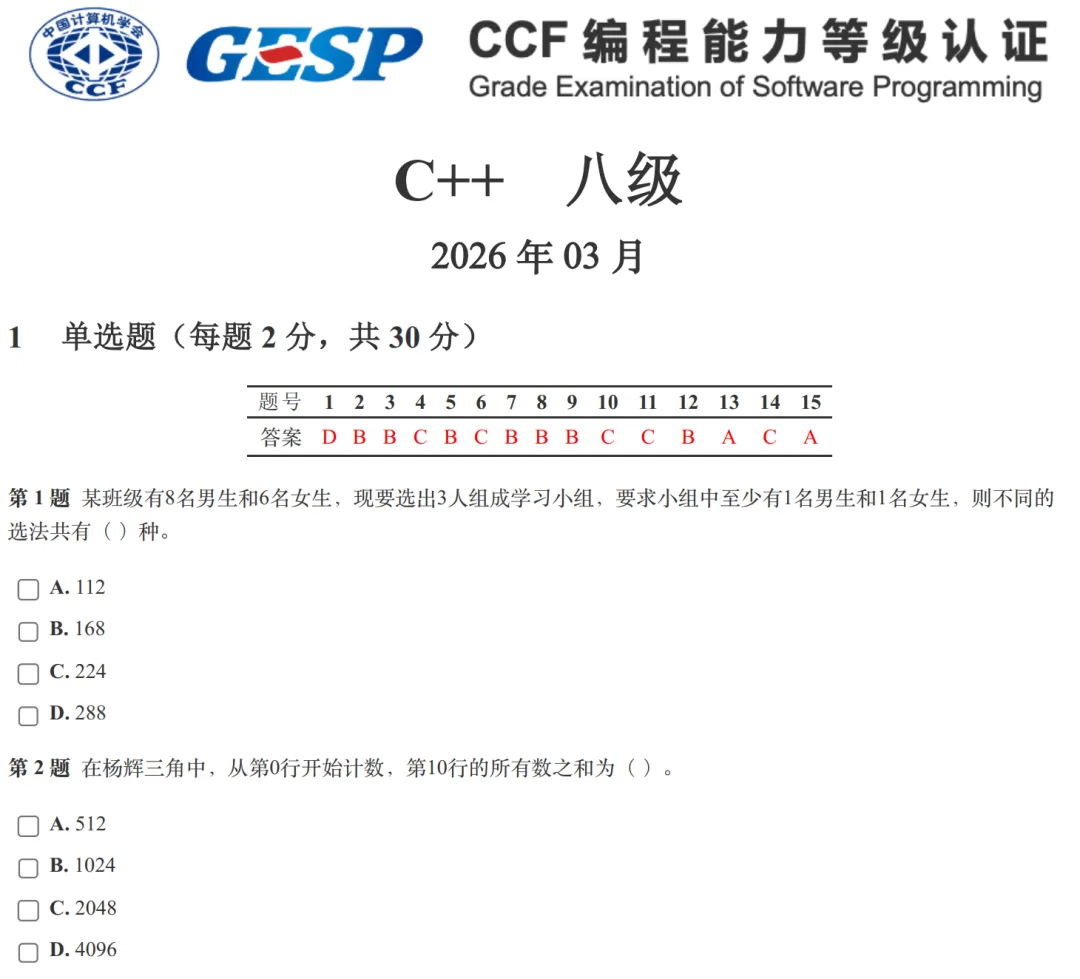
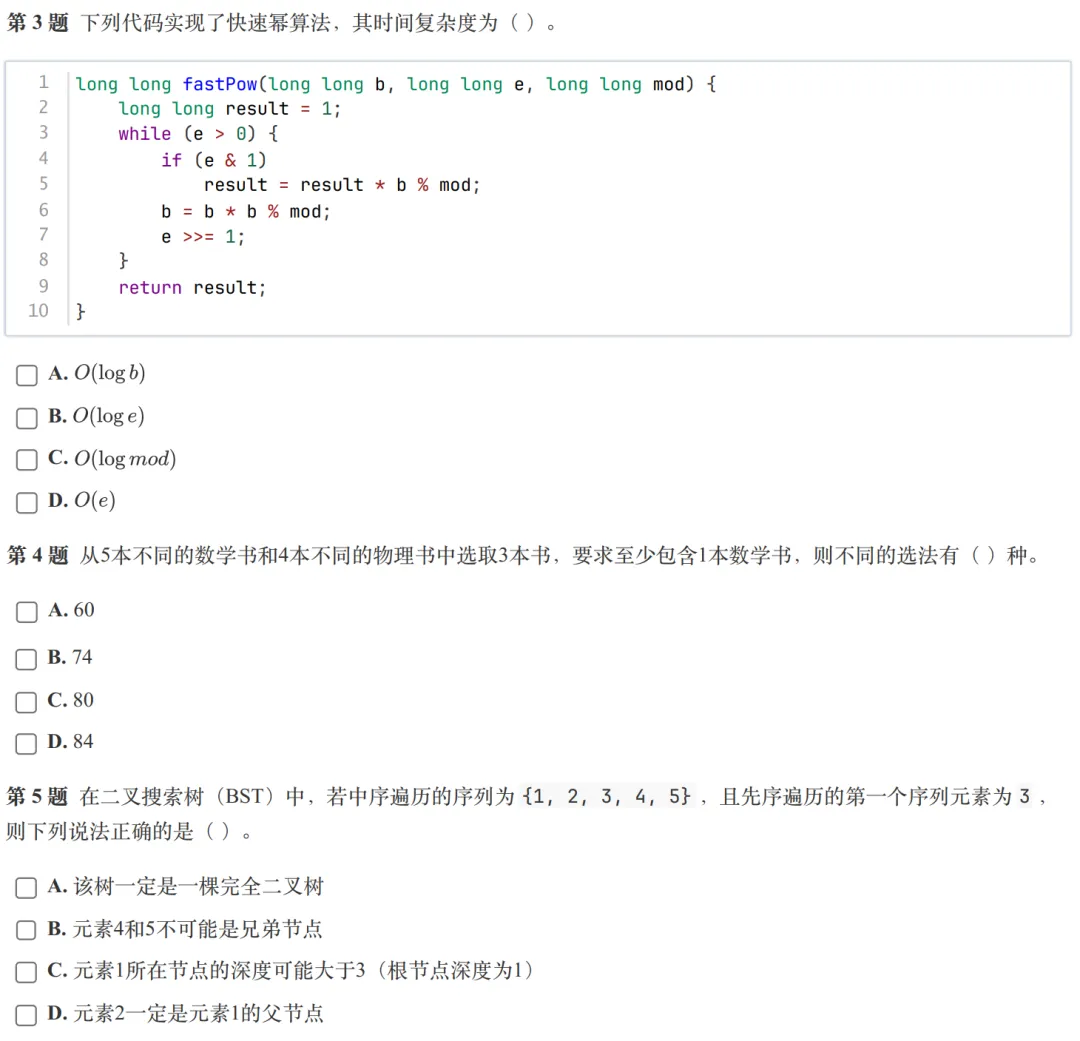
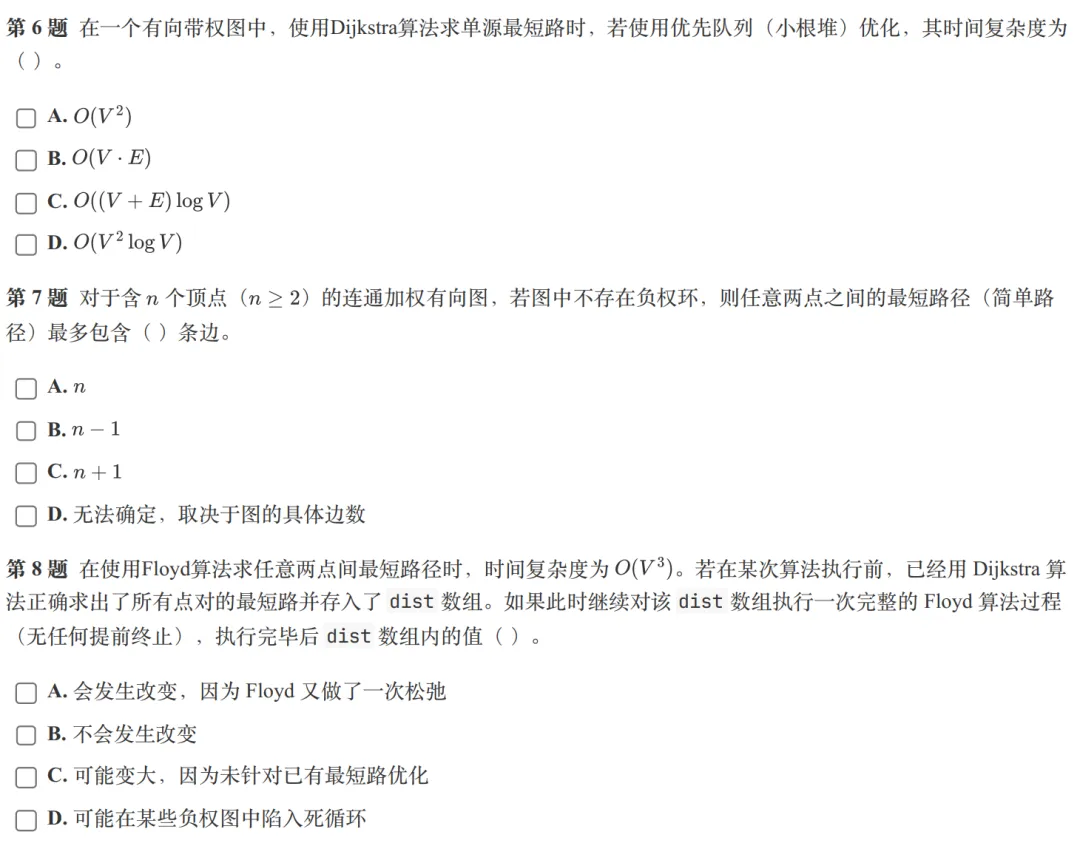
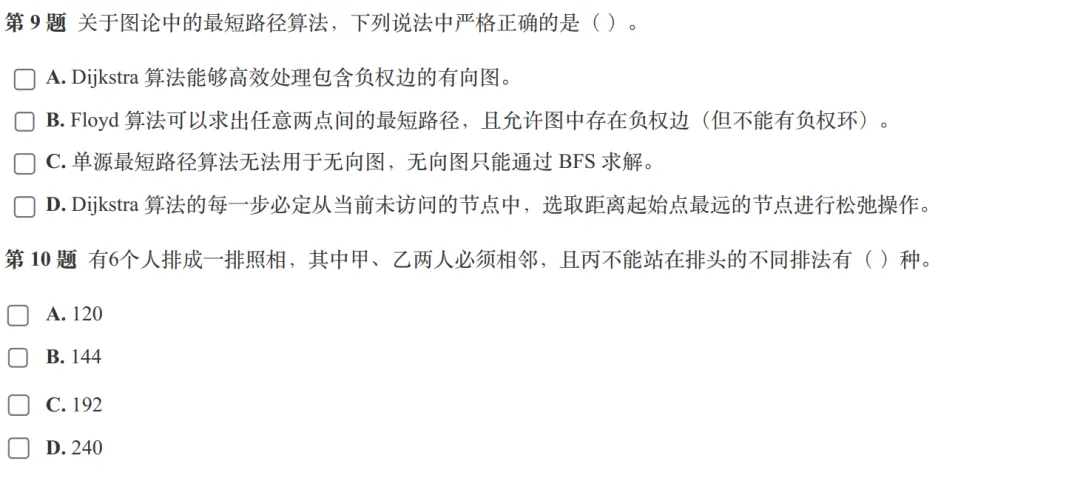
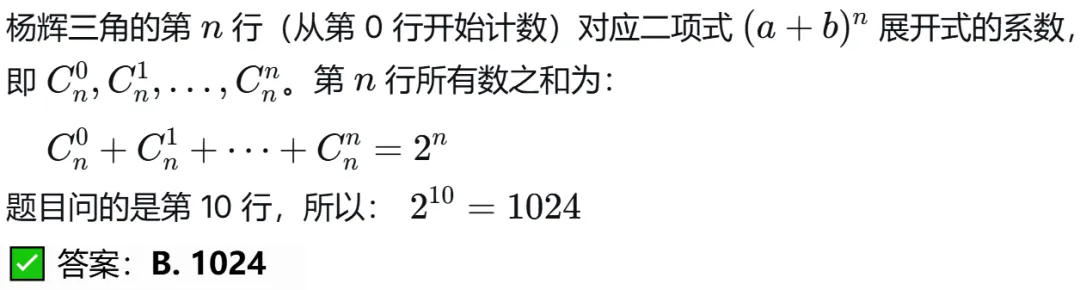
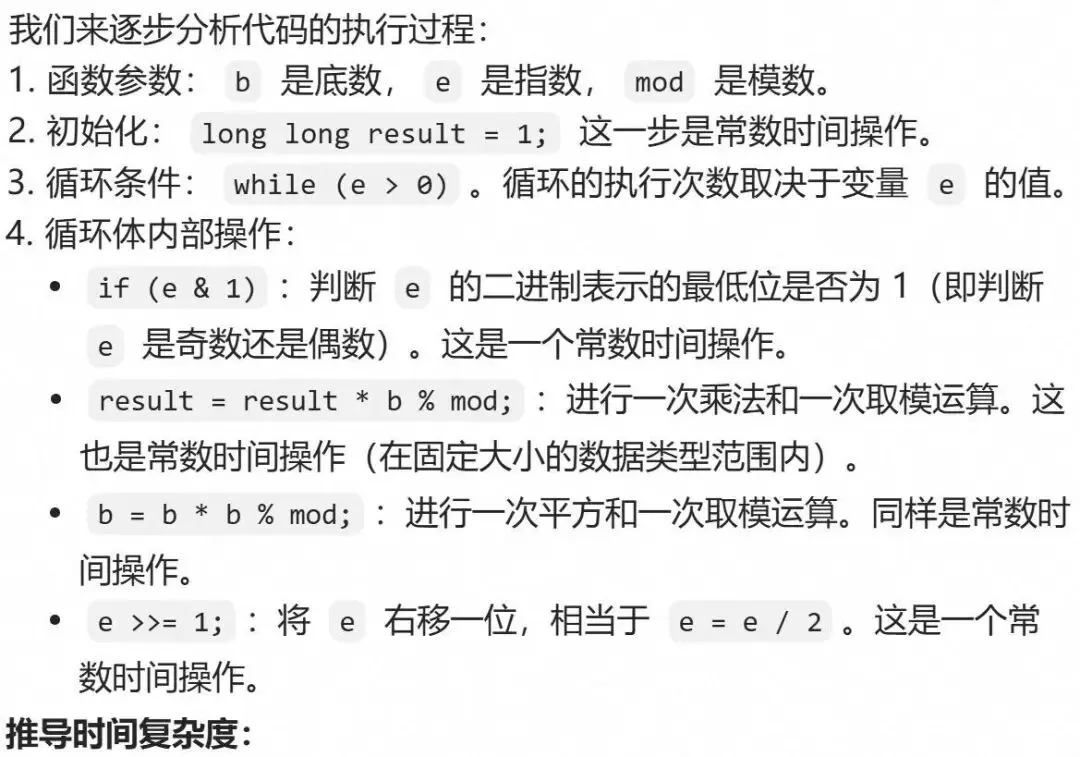
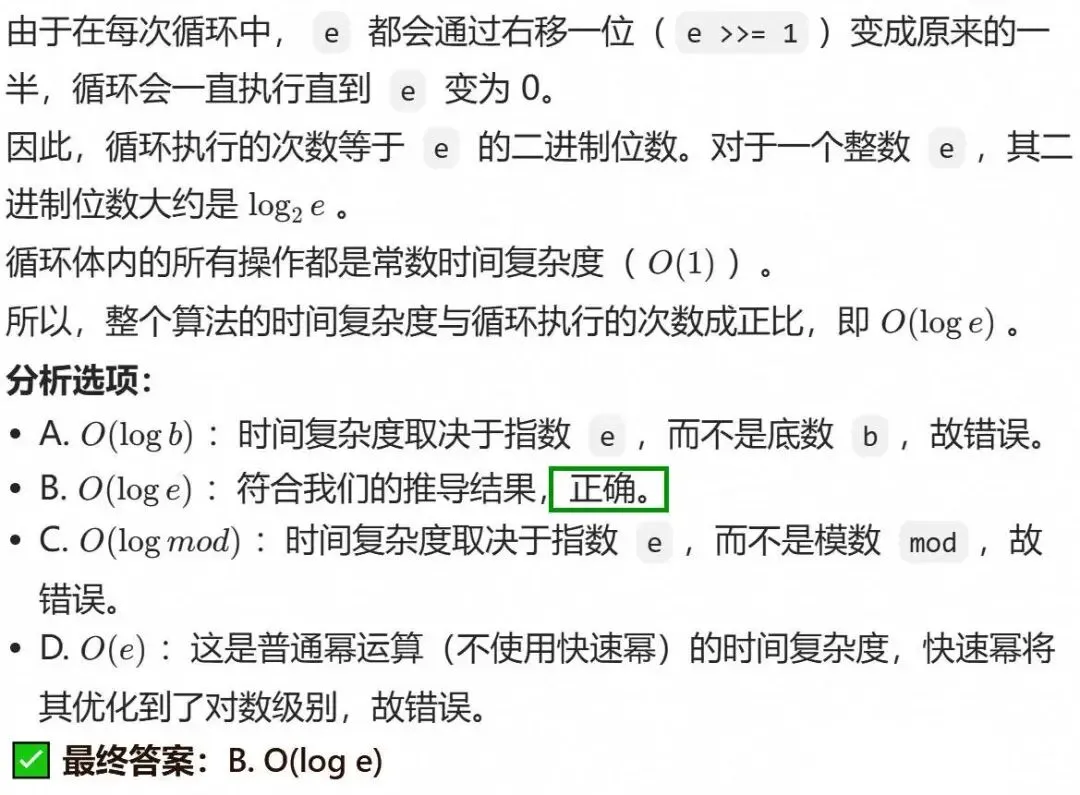
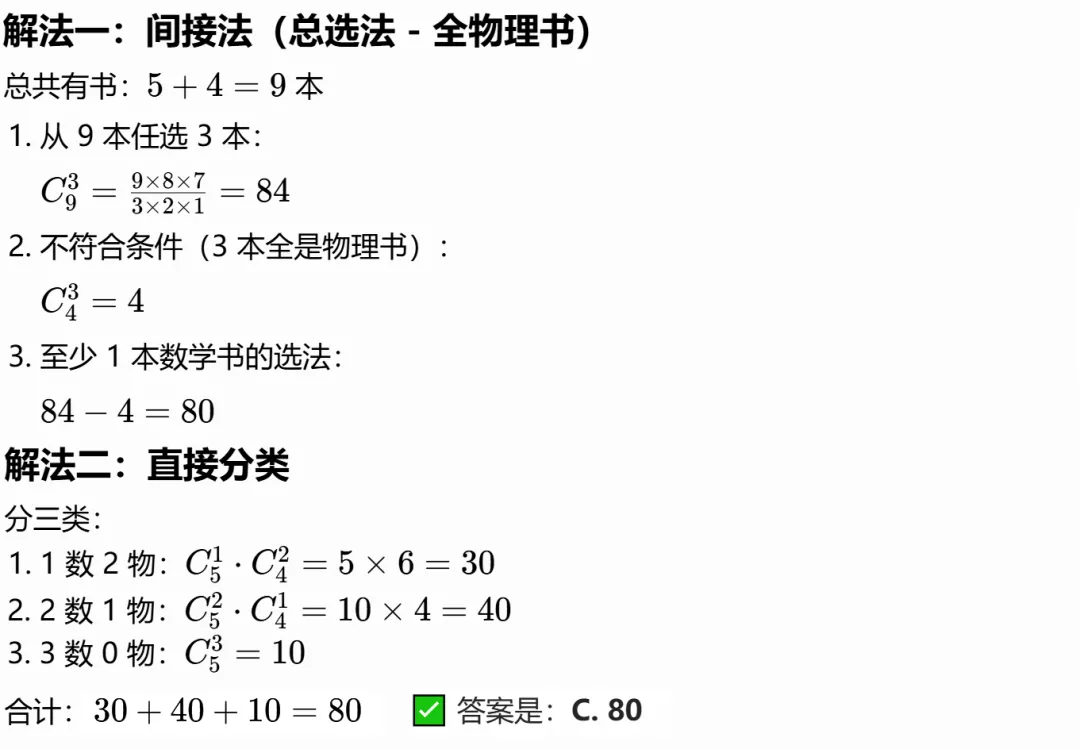
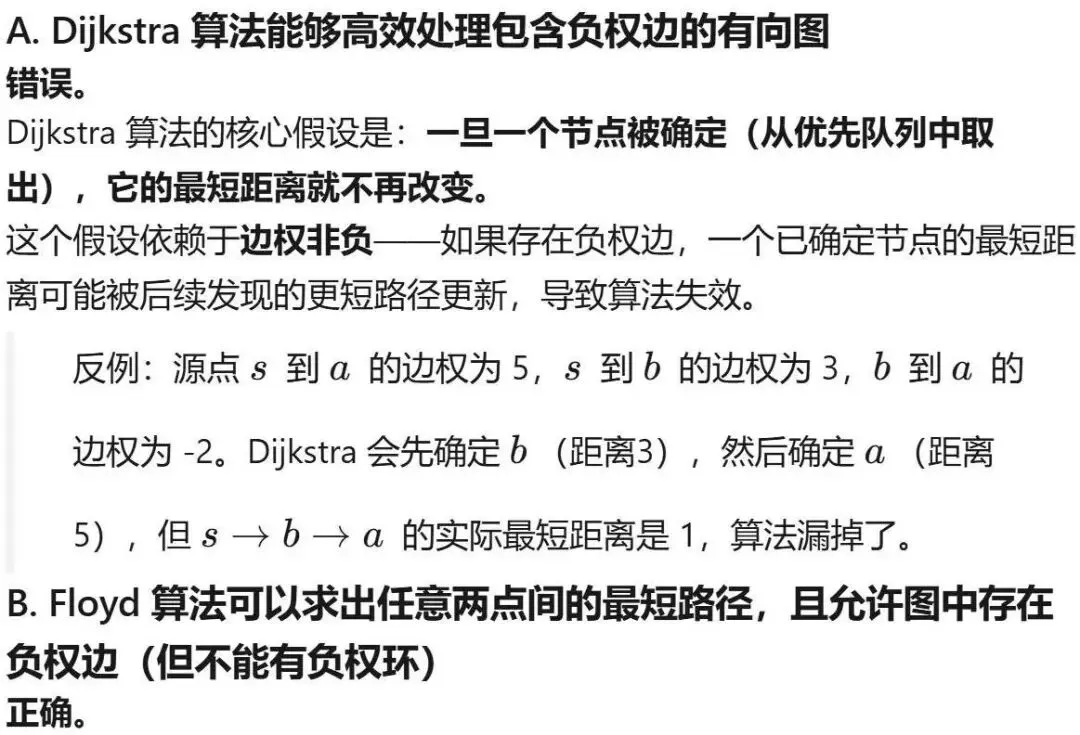
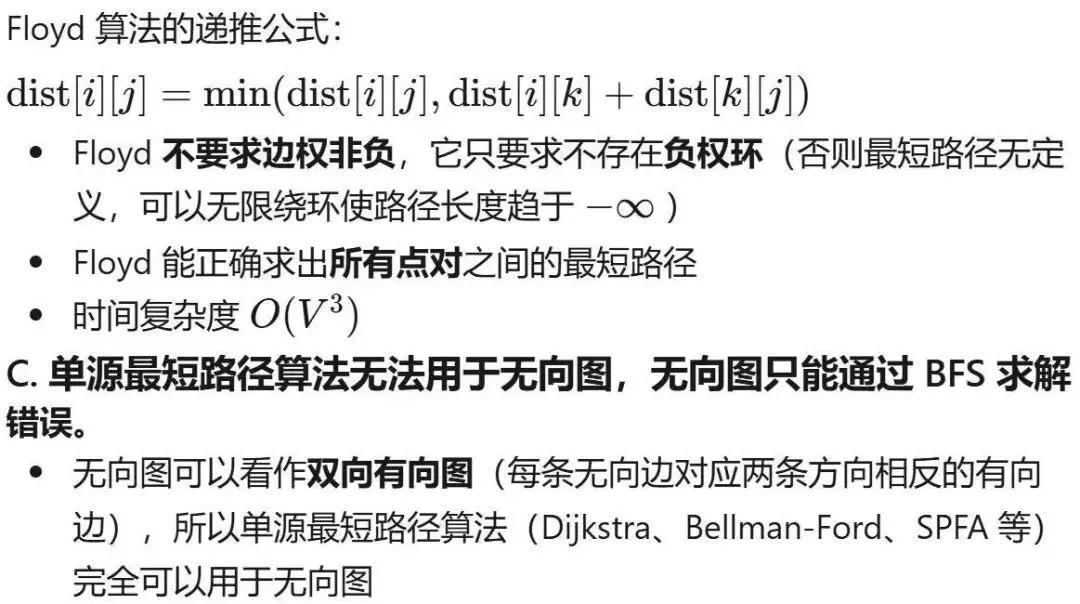
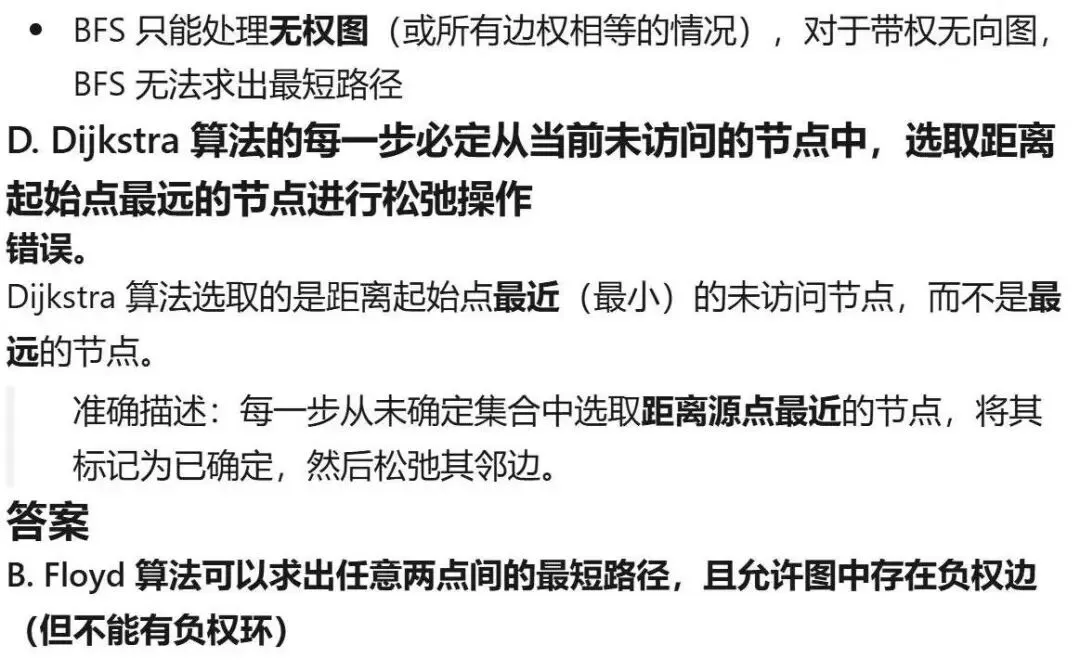
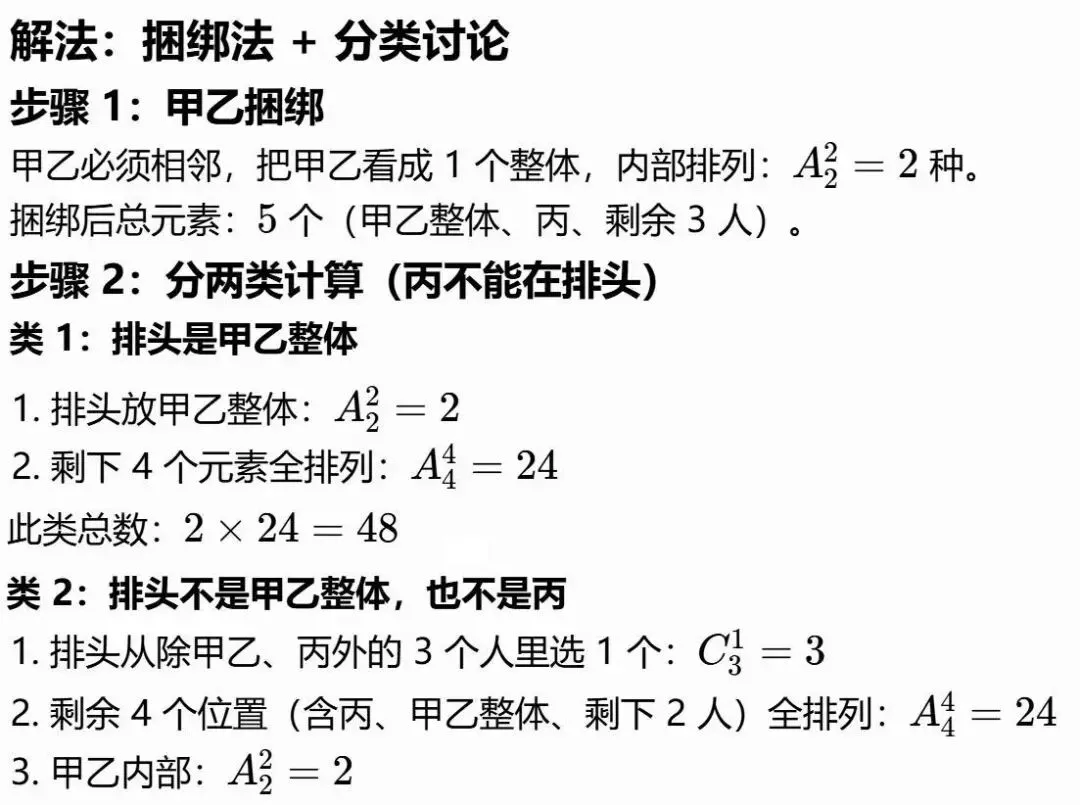
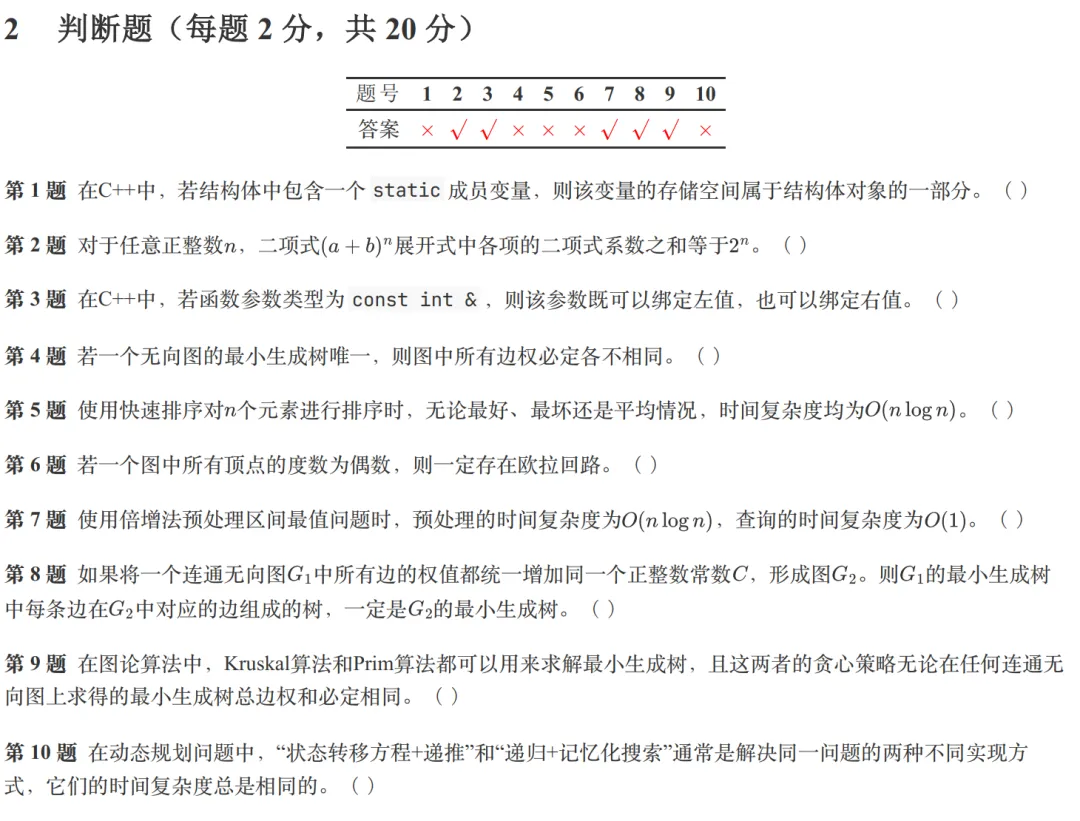
【答案解析】
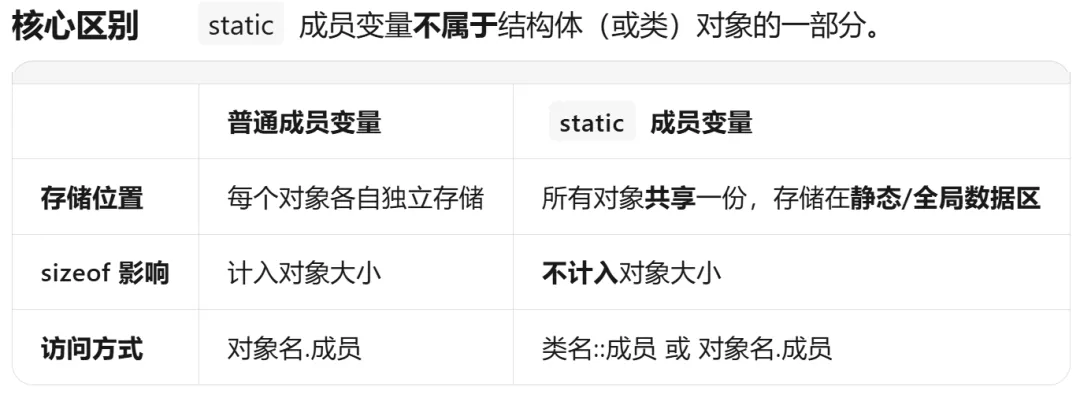
1.解释:错误。
详细解析见下图——
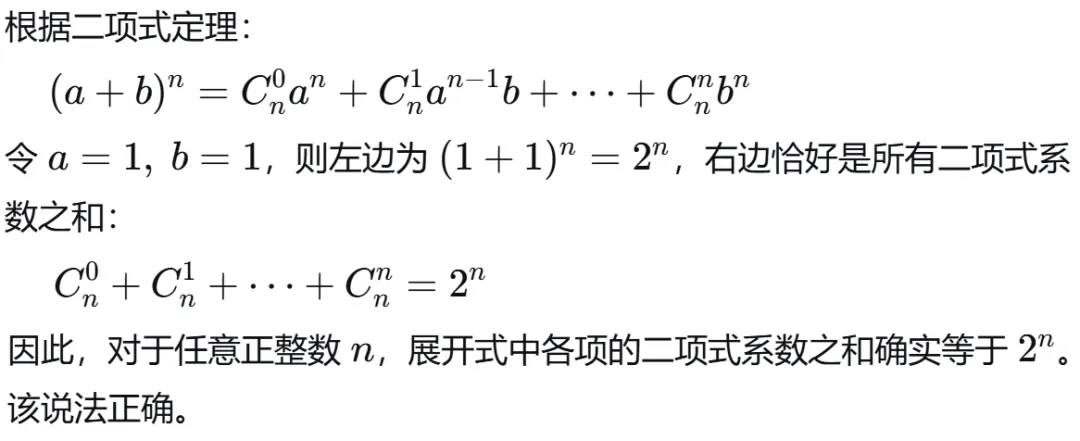
2.解释:正确。 详细解析见下图——
3.解释:正确。
详细解析见下图——
4.解释:错误。
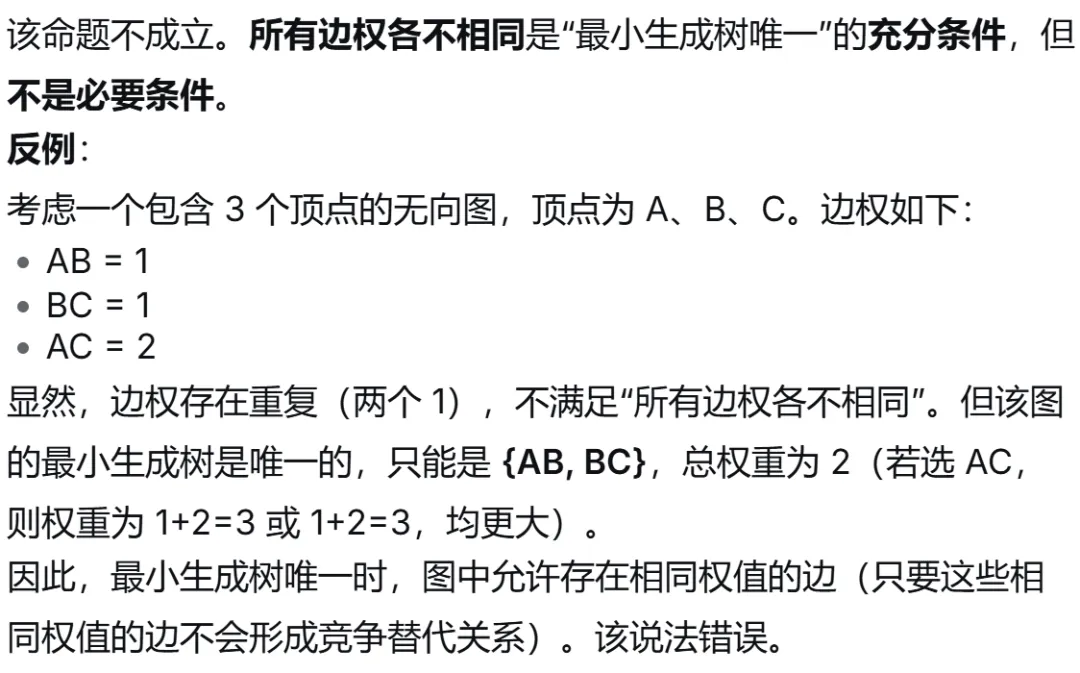
详细解析见下图——
5.解释:错误。
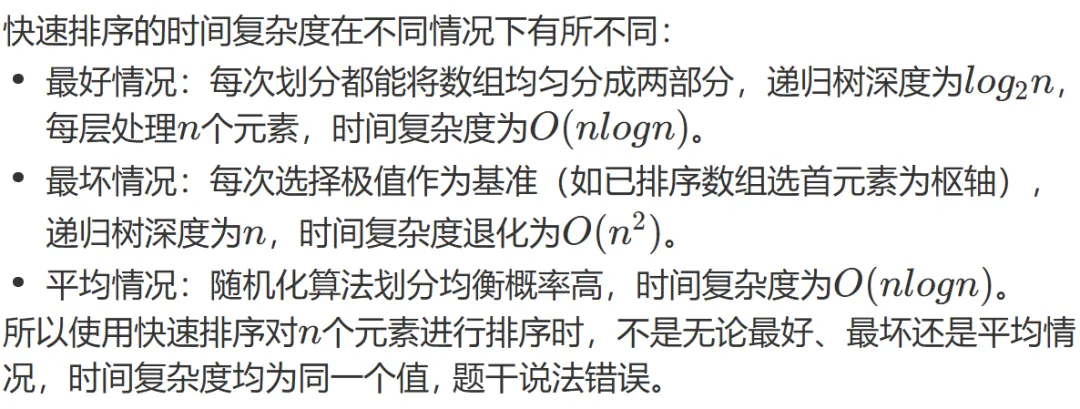
详细解析见下图——
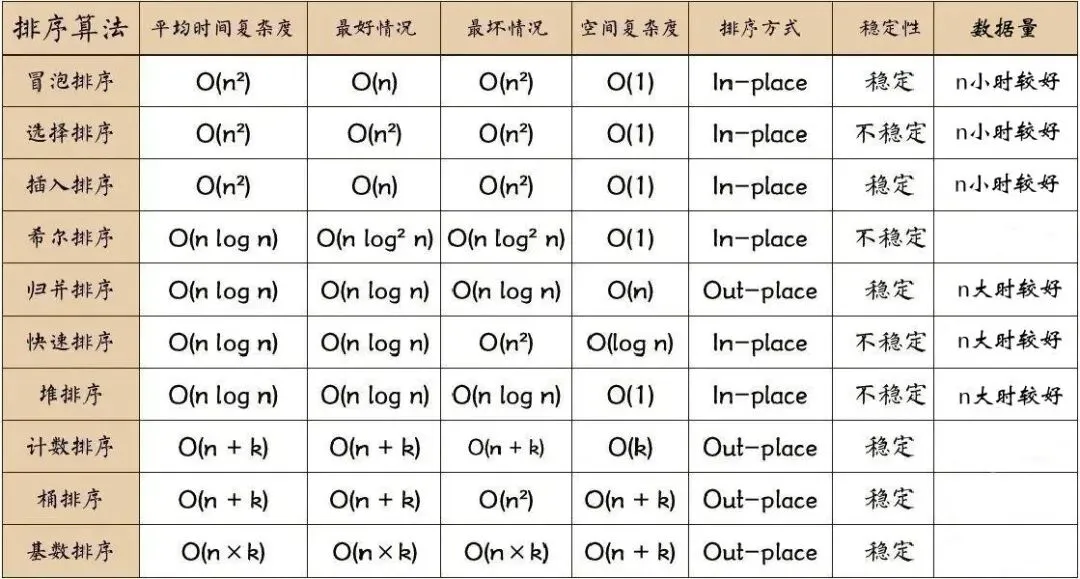
相关知识点的复习与拓展:
截至考试当年3月,有关十大经典排序算法的特点对比,可以参考下图帮助记忆——
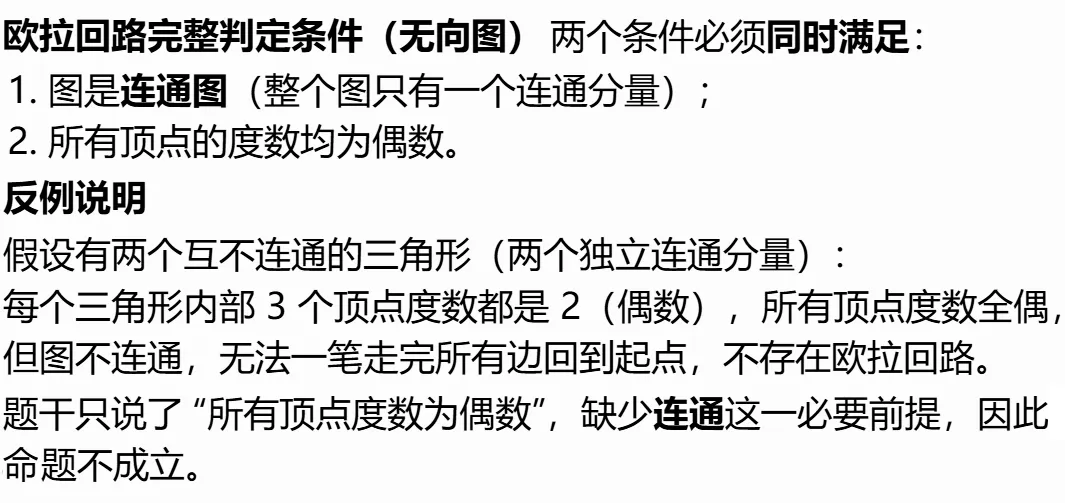
6.解释:错误。 详细解析如下——
7.解释:正确。
详细解析见下图——
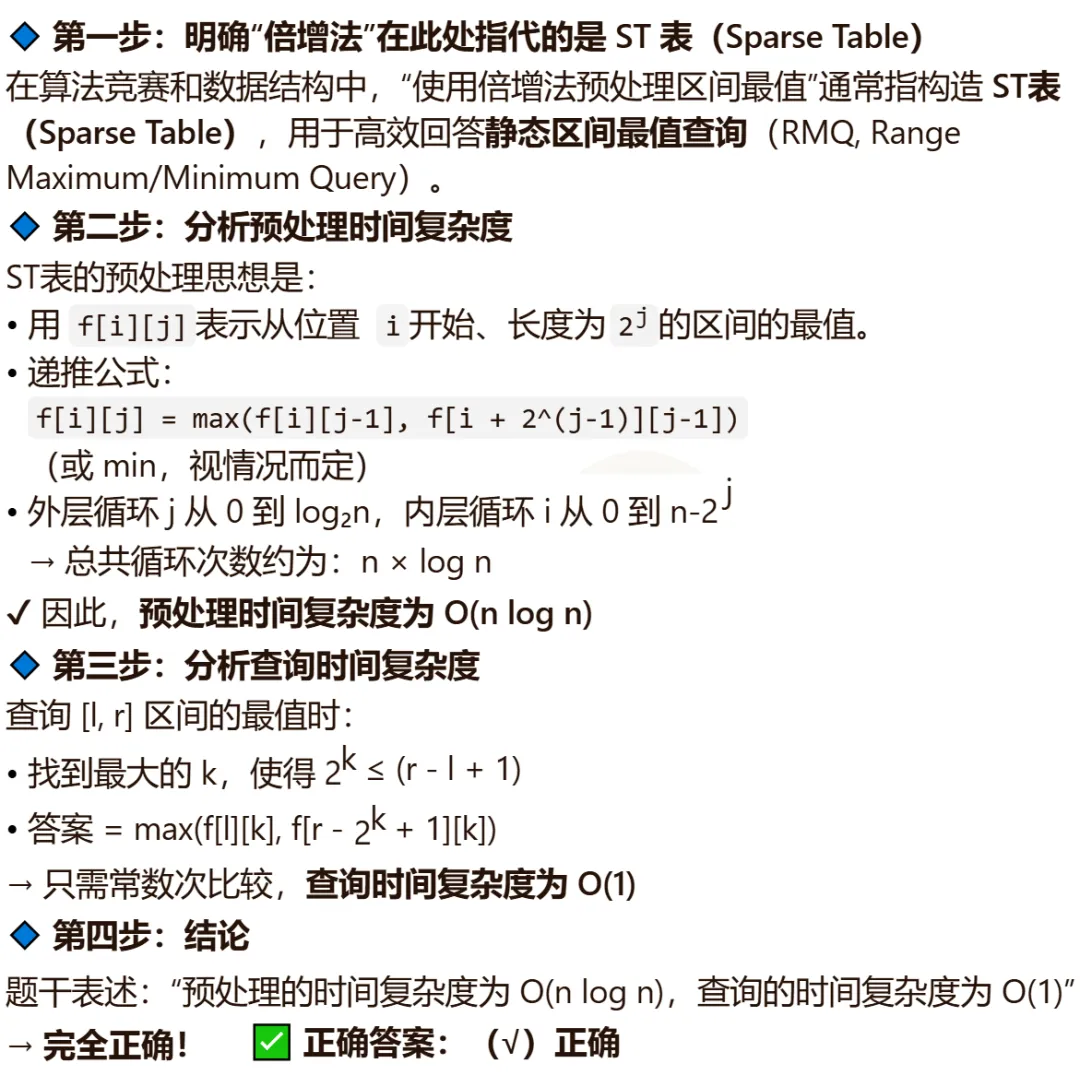
8.解释:正确。
详细解析见下图——
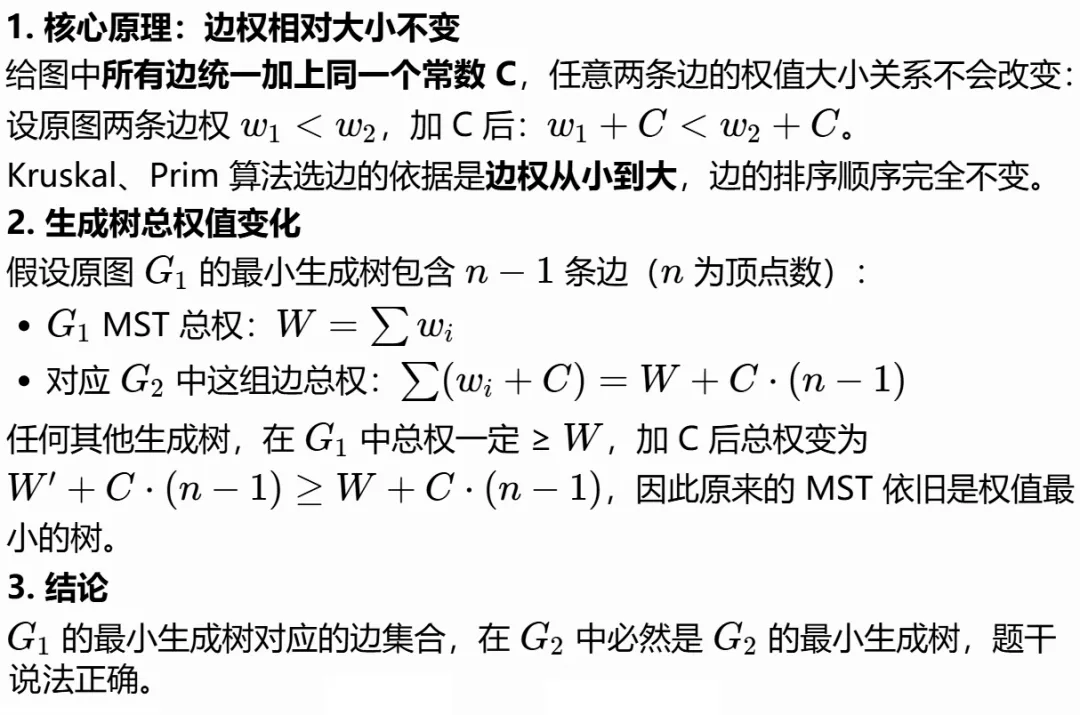
9.解释:正确。
最小生成树的总边权和是图的一个确定值(所有生成树权值中的最小值)。Kruskal算法和Prim算法都是正确的最小生成树算法,它们最终求出的树虽然边集可能不同,但总权值一定都等于这个最小值。因此该说法正确。
10.解释:错误。
绝大多数常规动态规划场景下二者时间复杂度一致,但在状态空间稀疏、依赖关系非连续的问题中,二者实际时间复杂度会出现明显差异,以下是典型案例。
案例1:带剪枝的路径计数问题 问题背景:在网格中从起点到终点的路径计数,仅允许向右/向下移动,且部分格子为障碍物不可通行。 ● 自底向上递推:必须遍历整个二维网格的所有格子,时间复杂度固定为O(m×n),即使大量格子完全不在任何有效路径上,也会被完整计算。 ● 递归+记忆化搜索:仅会递归访问起点到终点的有效路径覆盖到的格子,障碍物区域的子问题完全不会被触发计算,实际执行的状态数远小于m×n,时间复杂度远低于O(m×n)。 案例2:稀疏状态的子集选择问题 问题背景:给定长度为20的数组,选出和为target的子集数目,数组中大量元素远大于target。 ● 自底向上递推:必须遍历0到sum(nums)的所有连续状态,时间复杂度为O(n×sum(nums)),即使大量和值不可能由数组元素组合得到,也会被遍历计算。 ● 递归+记忆化搜索:仅会递归计算能组合出的有效和值,直接跳过所有不可能达到的无效状态,实际计算的状态数远小于sum(nums),时间复杂度显著更低。 案例3:斐波那契数列的极端稀疏场景 问题背景:仅计算F(1000),不涉及中间所有无关项的批量计算。 ● 自底向上递推:必须从F(0)开始依次计算F(1)到F(999),完整遍历所有1001个状态,时间复杂度固定为O(n)。 ● 递归+记忆化搜索:仅会递归计算F(1000)直接依赖的F(999)、F(998)等必要子问题,虽然理论状态数也是n,但如果结合路径剪枝,在部分优化实现中可跳过部分冗余子问题,实际执行步数少于递推的全量遍历。 案例4:复杂状态转移的图上DP问题 问题背景:在有向无环图(DAG)中求最长路径,图中仅存在少量连通节点。 ● 自底向上递推:必须按拓扑序遍历图中所有节点,即使大量节点和目标起点完全不连通,也会被纳入遍历流程,时间复杂度为O(V+E)。 ● 递归+记忆化搜索:从起点出发递归遍历,完全不会访问和起点无连通关系的孤立节点,实际访问的节点和边数远小于V+E,时间复杂度远低于递推实现。 GESP 2026年3月 C++八级 消息查找
#include<bits/stdc++.h>using namespace std;intmain(){ios::sync_with_stdio(false); //关闭C++标准流与C标准流的同步机制,直接单独使用独立缓冲区cin.tie(nullptr), cout.tie(nullptr);//解除cin与cout的绑定关系,cin操作不会再自动刷新cout缓冲区,进一步提升输入速度int n, q; // n: 消息总数, q: 询问次数cin >> n >> q;// 存储所有引用消息,每个三元组为 (引用目标 r, 消息自身编号 i, 收益 i-r-1)// 最多只有1000条引用消息,故开固定大小1010vector<tuple<int, int, int>> a(1010);int m = 0; // 实际引用消息数量for (int r, i = 1; i <= n; ++i) {cin >> r; // 读入 r_iif (r == 0) continue; // 无引用,忽略a[++m] = {r, i, i - r - 1}; // 存储三元组:目标,自身编号,收益}// pre[i]:对于第 i 条引用消息(按原始消息编号升序存储),// 在它之前(j < i)且满足 目标 r_j <= 当前目标 r_i 的最大 j。// 如果不存在则为 0。vector<int> pre(m + 5);for (int i = 1; i <= m; ++i) {for (int j = i - 1; j >= 1; --j) {// get<1>(a[j]) 是消息编号 j,get<0>(a[i]) 是当前引用目标 r_i// 条件:消息 j 的编号 <= 当前引用目标 r_i,即可以衔接if (get<1>(a[j]) <= get<0>(a[i])) {pre[i] = j;break;}}}// 处理每个询问while (q--) {int l, r; // 注意输入顺序:第一个是 x(当前消息),第二个是 y(目标消息)// 但代码读入为 r, l,即 r 是 x,l 是 y(变量名有误导,实际 l=y, r=x)cin >> r >> l; // 输入为 x, y,但赋值给 r, l,故 r = x, l = y// dp[i]:考虑前 i 条引用消息(按消息编号升序)能获得的最大节省vector<int> dp(m + 5);for (int i = 1; i <= m; ++i) {// 不选第 i 条引用dp[i] = dp[i - 1];// 获取第 i 条引用的信息int target = get<0>(a[i]); // 引用目标 r_iint msg_id = get<1>(a[i]); // 消息自身编号 iint profit = get<2>(a[i]); // 收益 i - r_i - 1// 如果该引用不在询问区间 [l, r] 内,则不能选if (target < l || msg_id > r) continue;// 选择第 i 条引用,则之前只能选择 pre[i] 及其之前的引用// 因为 pre[i] 是满足目标 <= target 的最大前驱索引dp[i] = max(dp[i], dp[pre[i]] + profit);}// 基准步数 r - l(从 x 到 y 每次减1)// 减去最大节省即为最少操作次数cout << r - l - dp[m] << "\n";}return 0;}代码思路——


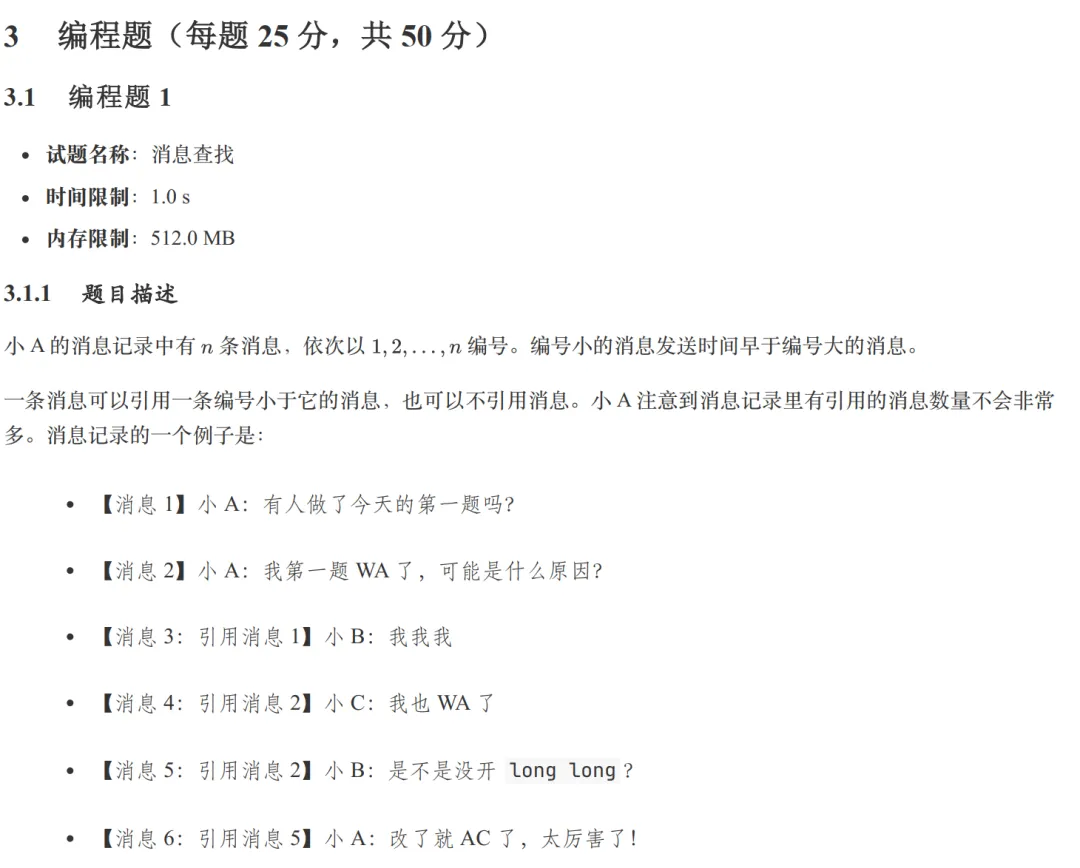
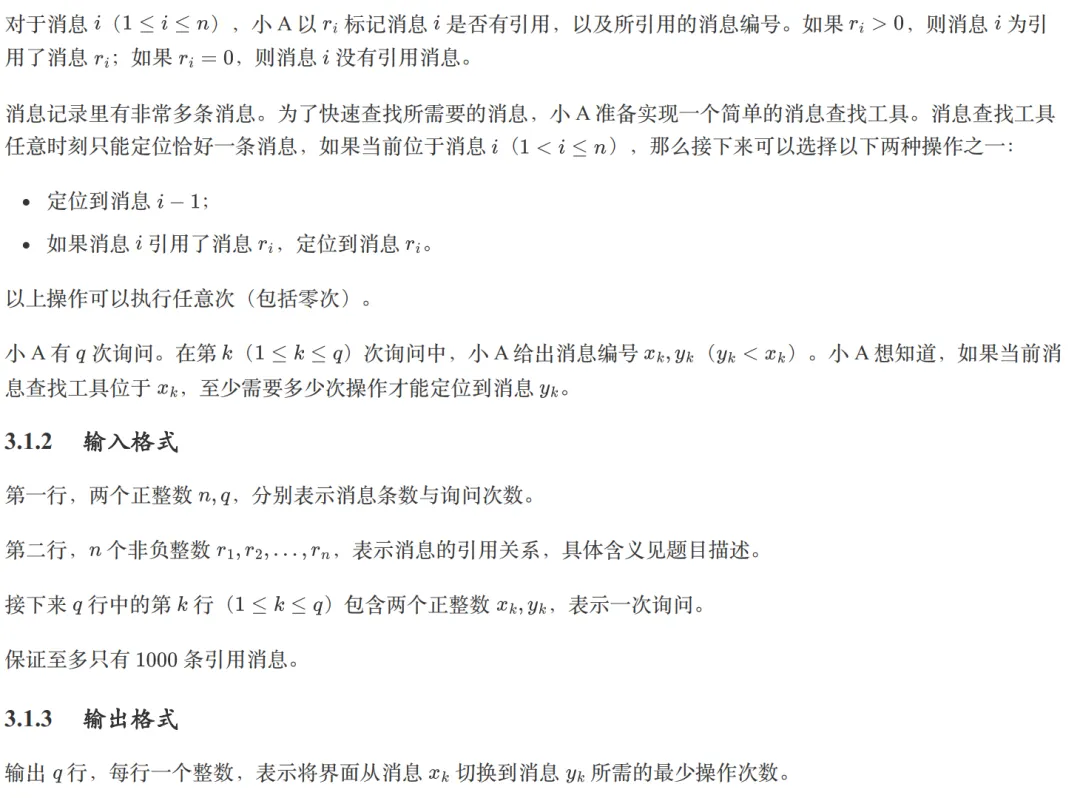
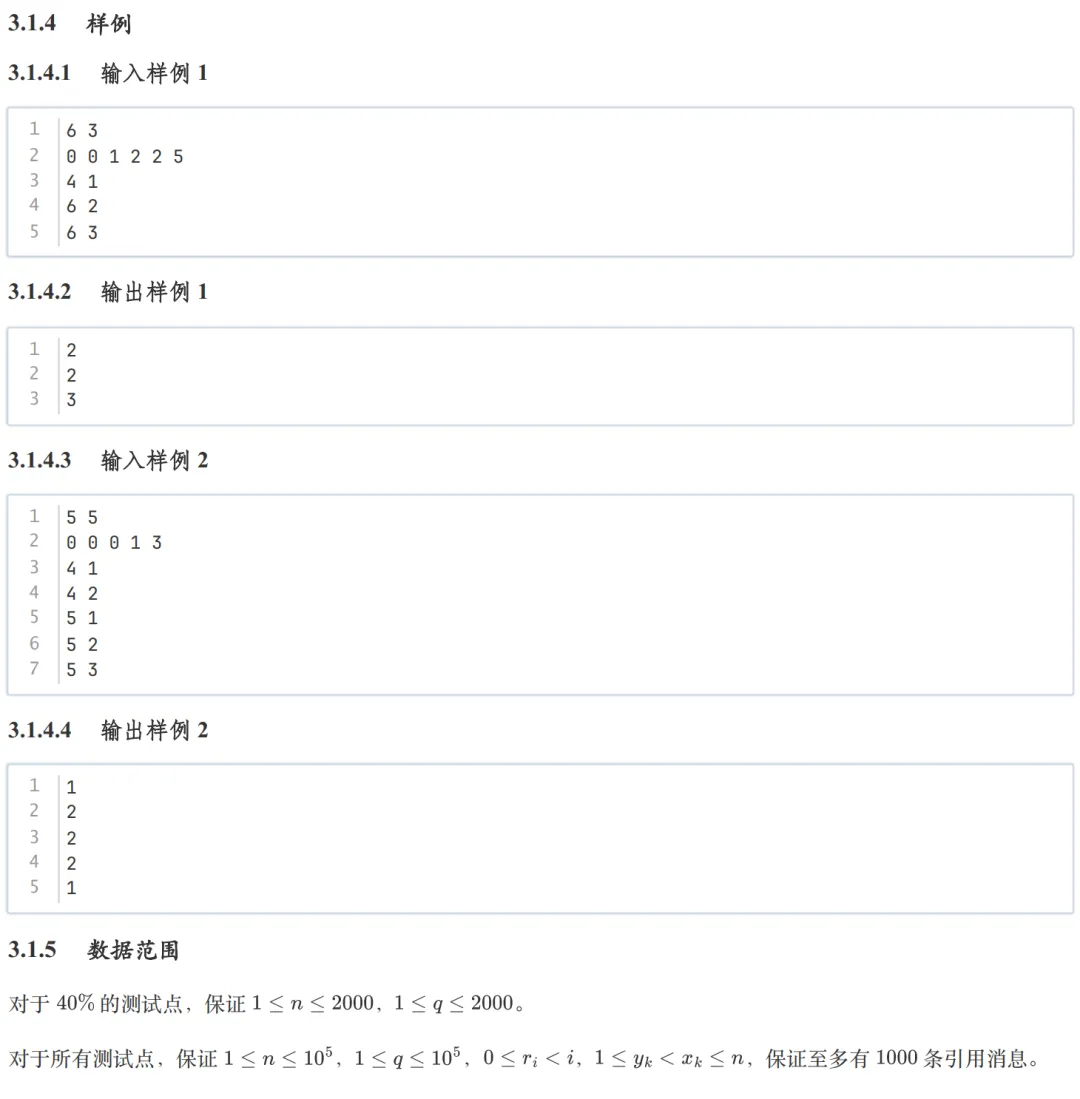
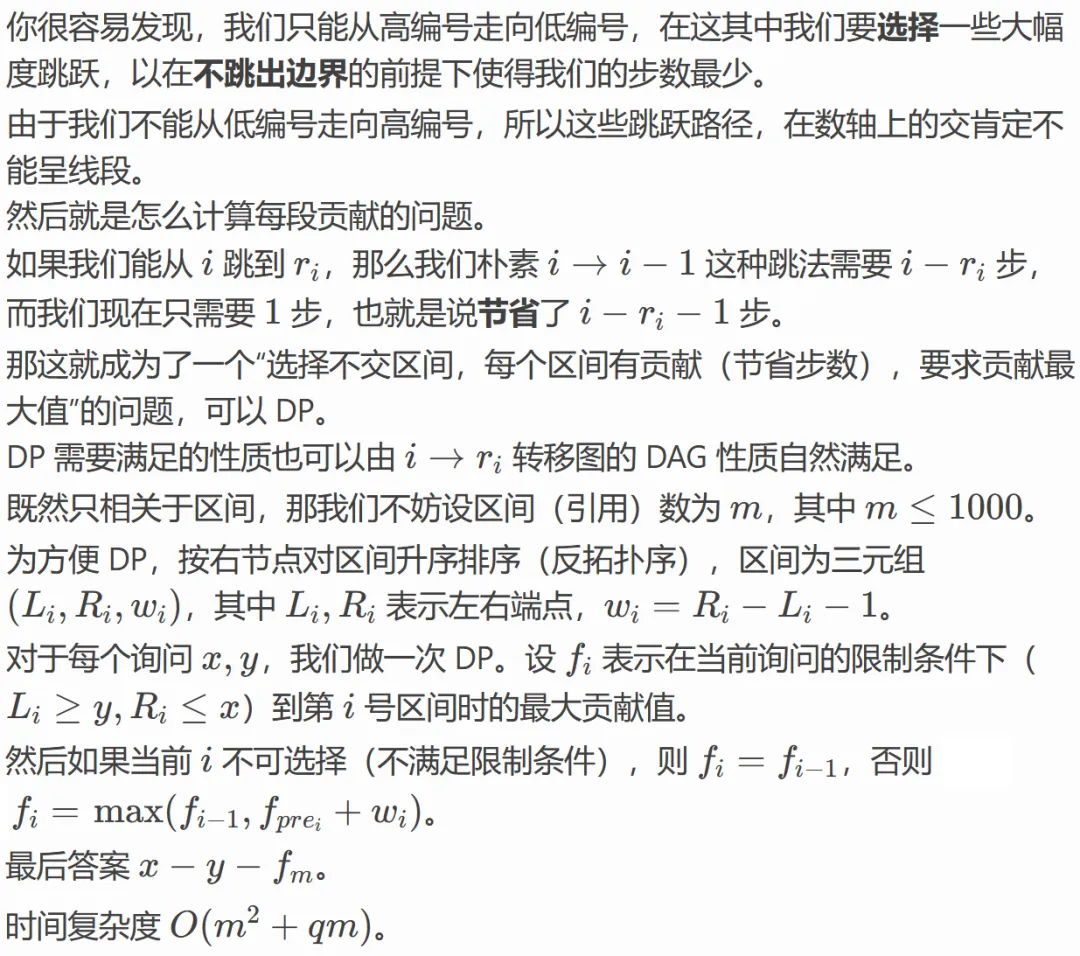
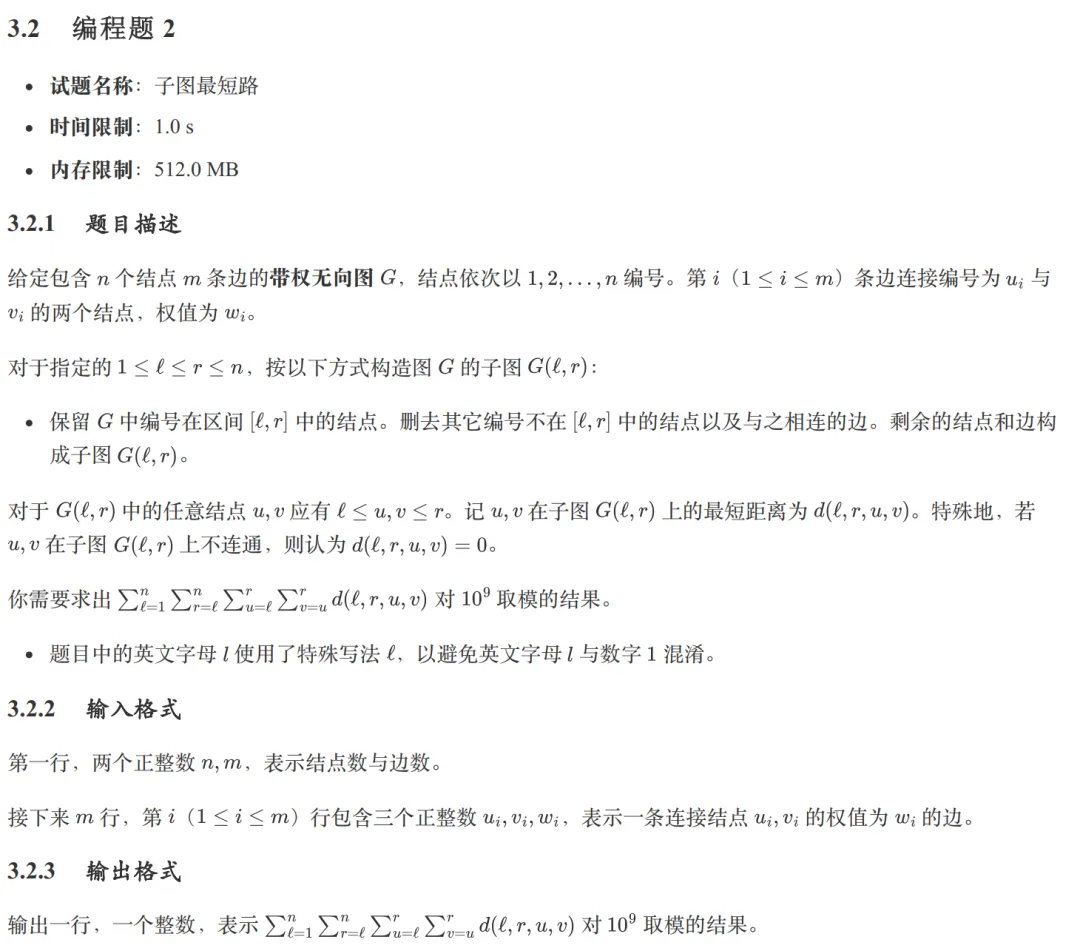
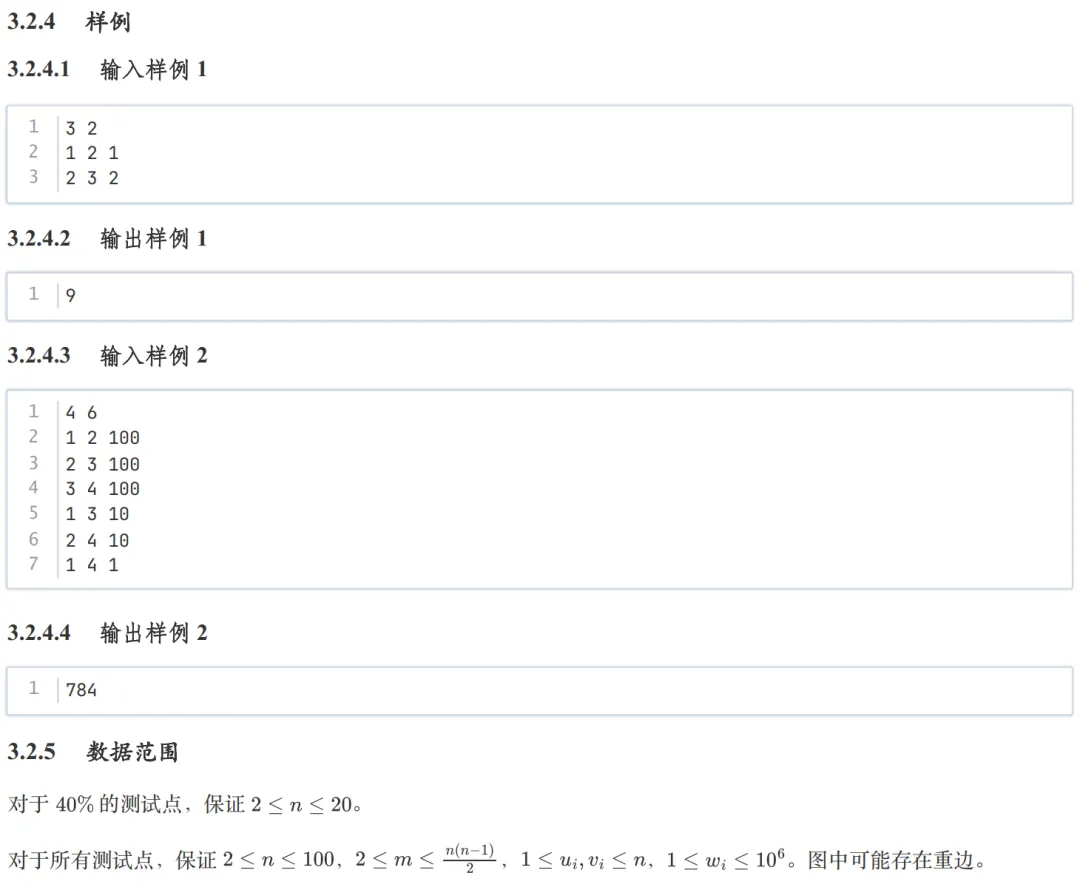
GESP 2026年3月 C++八级 子图最短路
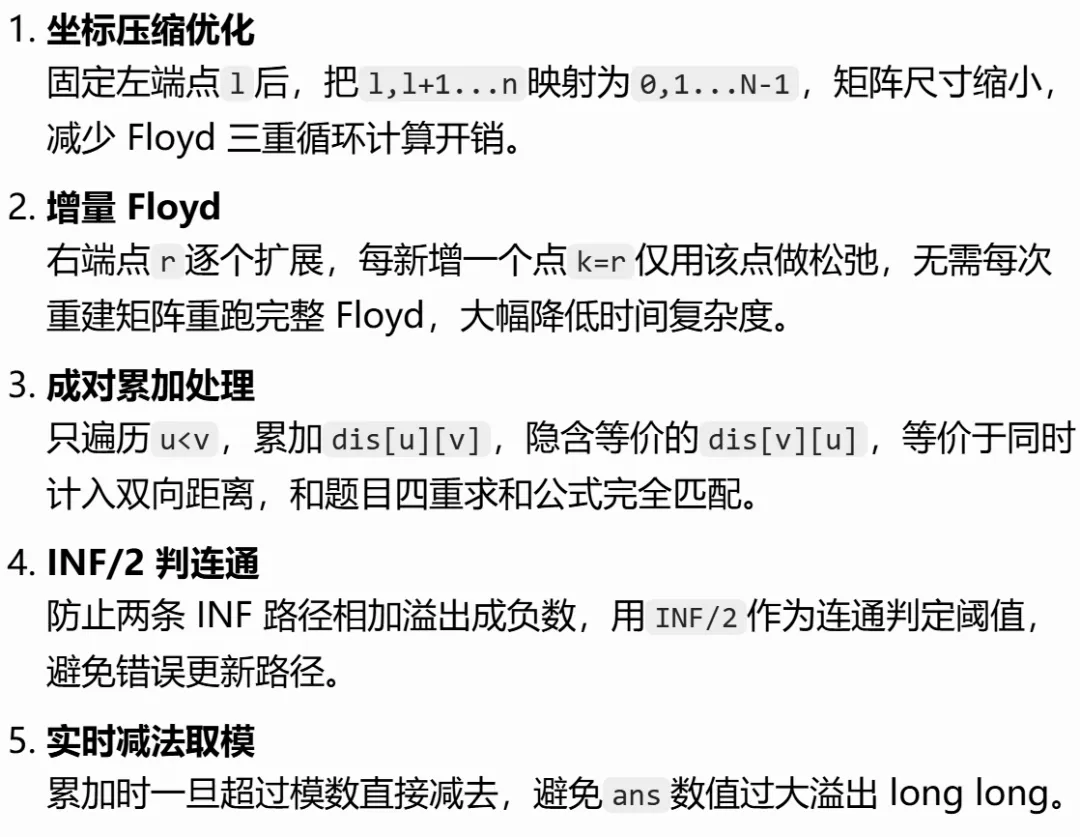
#include<bits/stdc++.h>using namespace std;// 别名:long long 简写为 ll,简化代码书写using ll = long long;// 无穷大:1左移60位,数值远大于单条边最大权1e6,避免路径溢出const ll INF = (1LL << 60);// 题目要求取模模数 1e9const int MOD = 1000000000;intmain(){// 关闭cin与stdio同步,加速cin输入速度ios::sync_with_stdio(false);// 解绑cin与cout,避免cout刷新拖慢cin读取cin.tie(nullptr);int n, m;// 读取结点总数n、边总数mcin >> n >> m;// 原图邻接矩阵 g[x][y]:点x到点y的直接边权,初始全部设为无穷大// 下标1~n对应题目点编号,0下标弃用vector<vector<ll>> g(n + 1, vector<ll>(n + 1, INF));// 点到自身距离为0for (int i = 1; i <= n; i++) g[i][i] = 0;// 循环读取m条无向边for (int i = 0; i < m; i++) {int u, v;ll w;cin >> u >> v >> w;// 处理重边:两点间保留权值最小的边g[u][v] = min(g[u][v], w);g[v][u] = min(g[v][u], w);}// 存储最终累加总和答案,用long long防止累加溢出ll ans = 0;// 枚举所有区间左端点 l,对应子图G(l, r)的左边界for (int l = 1; l <= n; l++) {// N:当前左端点l固定后,剩余可用点数量 l, l+1 ... nint N = n - l + 1;// dis 压缩矩阵:将 [l, n] 的点重新映射为下标0~N-1// dis[i][j] 等价于原图 g[l+i][l+j],缩小矩阵尺寸减少计算量vector<vector<ll>> dis(N, vector<ll>(N, INF));// 初始化压缩后的距离矩阵for (int i = 0; i < N; i++) {dis[i][i] = 0; // 点到自身距离为0for (int j = 0; j < N; j++) {// 把原图对应两点的边权复制到压缩矩阵dis[i][j] = g[l + i][l + j];}}// r 对应压缩矩阵下标,代表区间右端点 l+r,同时作为Floyd松弛中间点k// 循环扩展右端点:依次处理区间 [l,l]、[l,l+1] ... [l,n]for (int r = 0; r < N; r++) {int k = r; // 当前新增的点 l+r,作为Floyd新的中间中转点// Floyd-Warshall松弛:用新点k更新所有i,j之间的最短路for (int i = 0; i < N; i++) {// i到k不连通,跳过该路径if (dis[i][k] >= INF / 2) continue;for (int j = 0; j < N; j++) {// k到j不连通,跳过该路径if (dis[k][j] >= INF / 2) continue;// 更新i到j的最短路:i->k->jdis[i][j] = min(dis[i][j], dis[i][k] + dis[k][j]);}}// 当前有效区间为 [l, l+r],遍历所有无序点对(u,v) u<v// 因为d(l,r,u,v)和d(l,r,v,u)是两条独立贡献,这里会对称累加for (int u = 0; u < r; u++) {for (int v = u + 1; v <= r; v++) {// 判断两点连通(距离小于无穷大一半,防止溢出误判)if (dis[u][v] < INF / 2) {// 累加该路径距离,实时取模防止ans溢出ans += dis[u][v] % MOD;if (ans >= MOD) ans -= MOD;}}}}}// 输出总和对1e9取模的结果cout << ans % MOD << '\n';return 0;}代码思路——课程体系——
需要无水印PDF格式文件, 或者课程体系咨询, 欢迎扫描下面二维码添加好友垂询。
▍ 声明:本文整理自网络,如有侵权,请联系删除。
本公号刊载此文,是出于合法合理地分享和传播信息,扩大大受众范围,促进学术交流,推动共同进步之目的。公众号持有人郑重声明,本文的发布,将严格遵守相关规定和法律法规,不侵犯任意潜在作者的权益,不改变引用原文(若有)的意图和内容。若有来源标注错误或侵犯了您的合法权益,请随时与我们联系协商,联系(QQ):993225721,我们将及时更正、删除。文章若有幸得到转载,首先,公众号持有人感谢转载人为读者阅读提供了有价值的信息和知识,希望文章能够在被转载的平台上得到更广泛的传播和交流;其次,转载人应充分考虑到转载动作本身所可能带来的相应的风险和责任,包括但不限于侵犯知识产权、侵犯他人权益等行为所引起的法律责任,确保本文的合法传播和使用。同时,本人也极其愿意在转载过程中尽力配合转载人了解、关注、规避、消除相关的潜在风险。若转载人有相任何关疑虑,同样欢迎随时与我们联系协商,联系(QQ):993225721。 喜欢您关注我们哦——

文章来源:
四季读书网
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至23467321@qq.com举报,一经查实,本站将立刻删除;如已特别标注为本站原创文章的,转载时请以链接形式注明文章出处,谢谢!


